
OmniEncoder:突破“帧”束缚,像人类一样感知连续运动
OmniEncoder: See, Hear, and Feel Continuous Motion Like Humans With One Encoder
总结
问题
方法
结果
要点
摘要
本文提出了 Omni-Encoder,一种统一的 Transformer 骨干网络,旨在 25 fps 的对称高帧率下共同嵌入视觉和音频信号。该模型通过共享潜空间实现了多模态的深度融合,在手语识别和精细运动分析等连续视觉理解任务上达到了 SOTA 水平。
TL;DR
阿里巴巴通义实验室(Tongyi Lab)的研究团队近日发布了 Omni-Encoder。这是一款统一的 Transformer 骨干网络,它彻底摒弃了传统模型中视觉与音频“各过各的”编码方式,在 25 fps 的高频同步下实现“视听触”一体化建模。该模型在手语识别(NationalCSL)上狂拉基准线 20%,并在多项动作分析任务中刷新 SOTA。
痛点深挖:被忽视的“帧率鸿沟”
目前的 Omni-modal LLMs(如 Gemini, Qwen-Omni)虽然强大,但存在一个生理缺陷:感知不对称。
- 现状:为了节省算力,它们通常每秒只抽取 1-2 帧视频,而音频则保留 25 fps 以上的稠密采样。
- 后果:这种“视觉稀疏、音频稠密”的架构让模型变成了“深度近视”,它能听清每一个词,却看不清一个快速的手势动作(如手语或跳水)。
- 直觉:人类的感知是同步且连续的。Omni-Encoder 的目标就是让机器也能在编码阶段就实现视听信息的实时对齐与深度交互。
核心机制:Omni-Encoder 的三件套
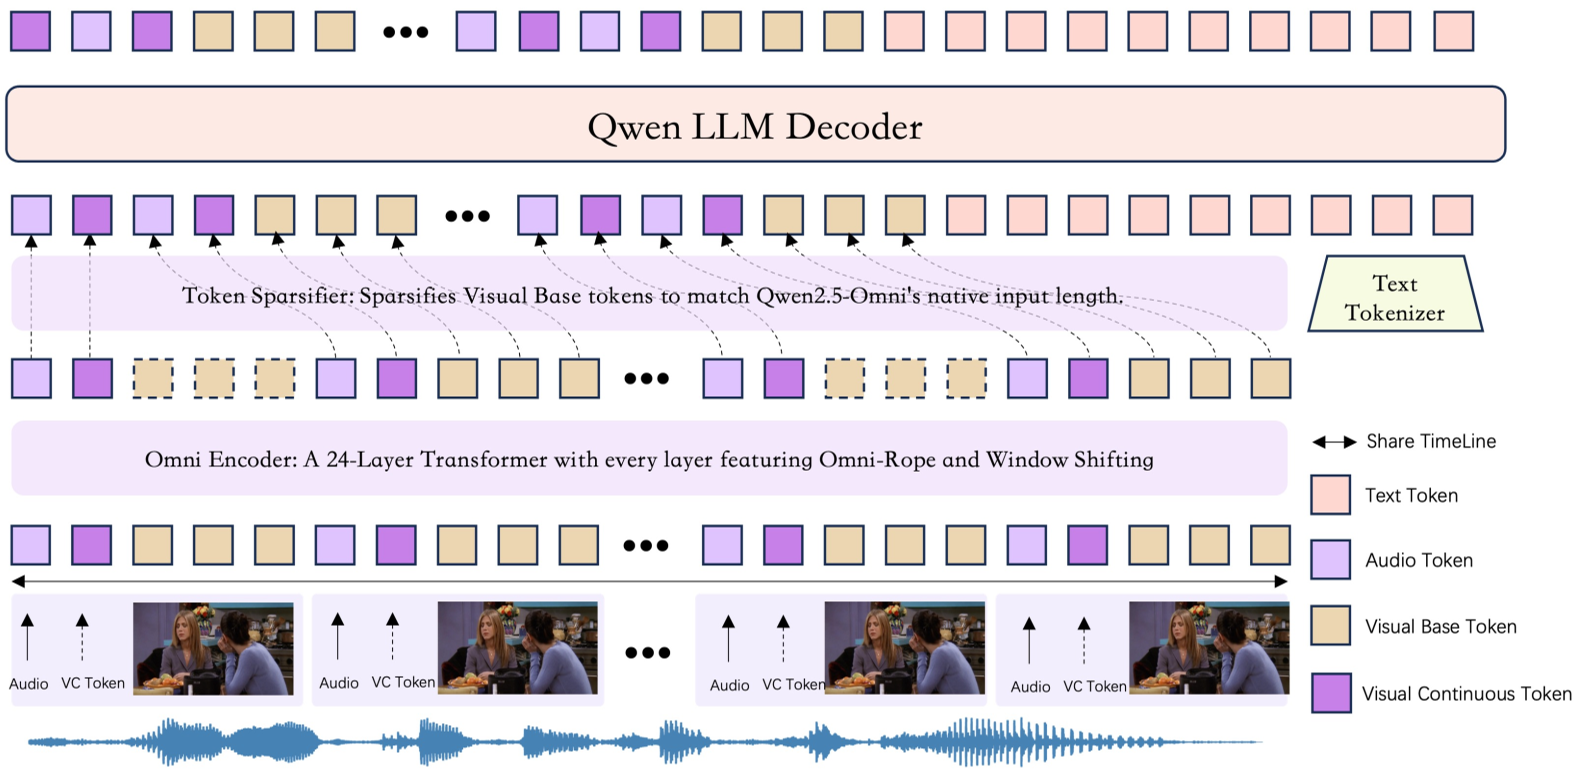
1. 令牌模板(Token Template)
研究者将视频转化为三种 Token 流:
- Audio Tokens: 捕捉声音信号。
- Visual Base (VB) Tokens: 传统的空间补丁(Patch),负责静态特征(纹理、形状)。
- Visual Continuous (VC) Tokens: 关键创新!这是逐帧的“可学习查询”,专门捕获帧间的微动、轨迹和手势起始点。
2. Omni-RoPE:3D 坐标系的精妙重排
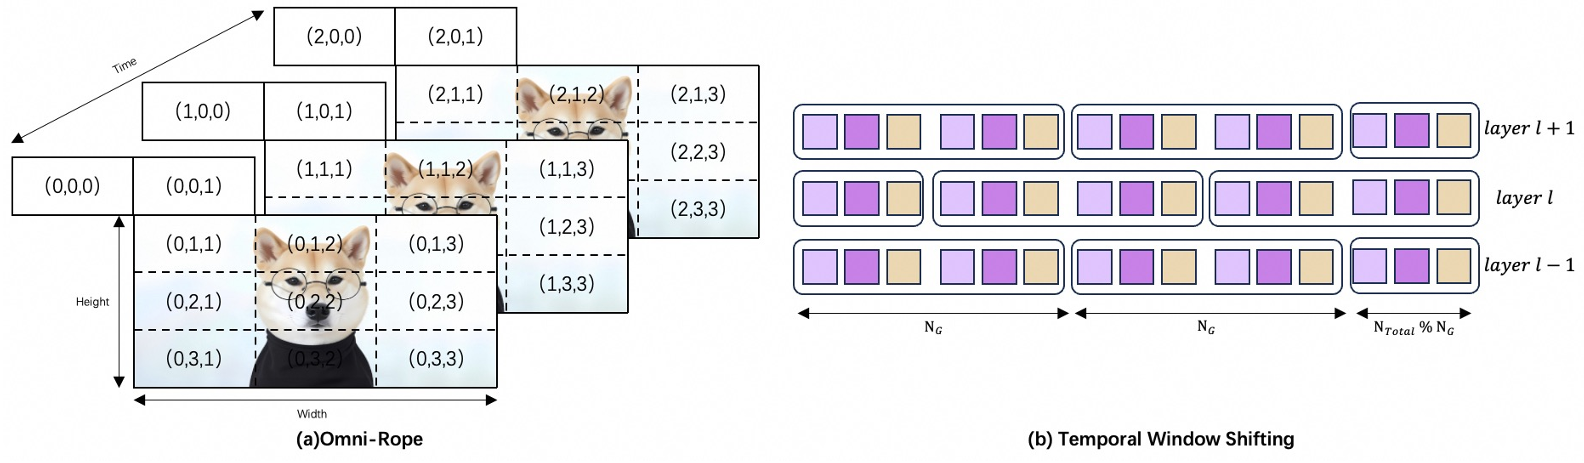
在同一个 Latent Space 里处理多种模态,位置编码容易“打架”。团队通过对坐标空间进行微调(VB 偏移至 [+1, +1]),为 Audio 和 VC 留出了独立的专用原点坐标。这保证了模型在理解空间位置的同时,能清晰分辨出“这是声音”还是“这是运动”。
3. 时间窗口移动(Temporal Window Shifting)
25 fps 的视频计算量呈现平方级增长()。Omni-Encoder 借用了 Swin Transformer 的思想,通过交替的局部窗口和位移窗口,将复杂度降为线性(),让长视频的处理变得触手可及。
实验战绩:不仅仅是“刷榜”
实验结果展现了压倒性的优势:
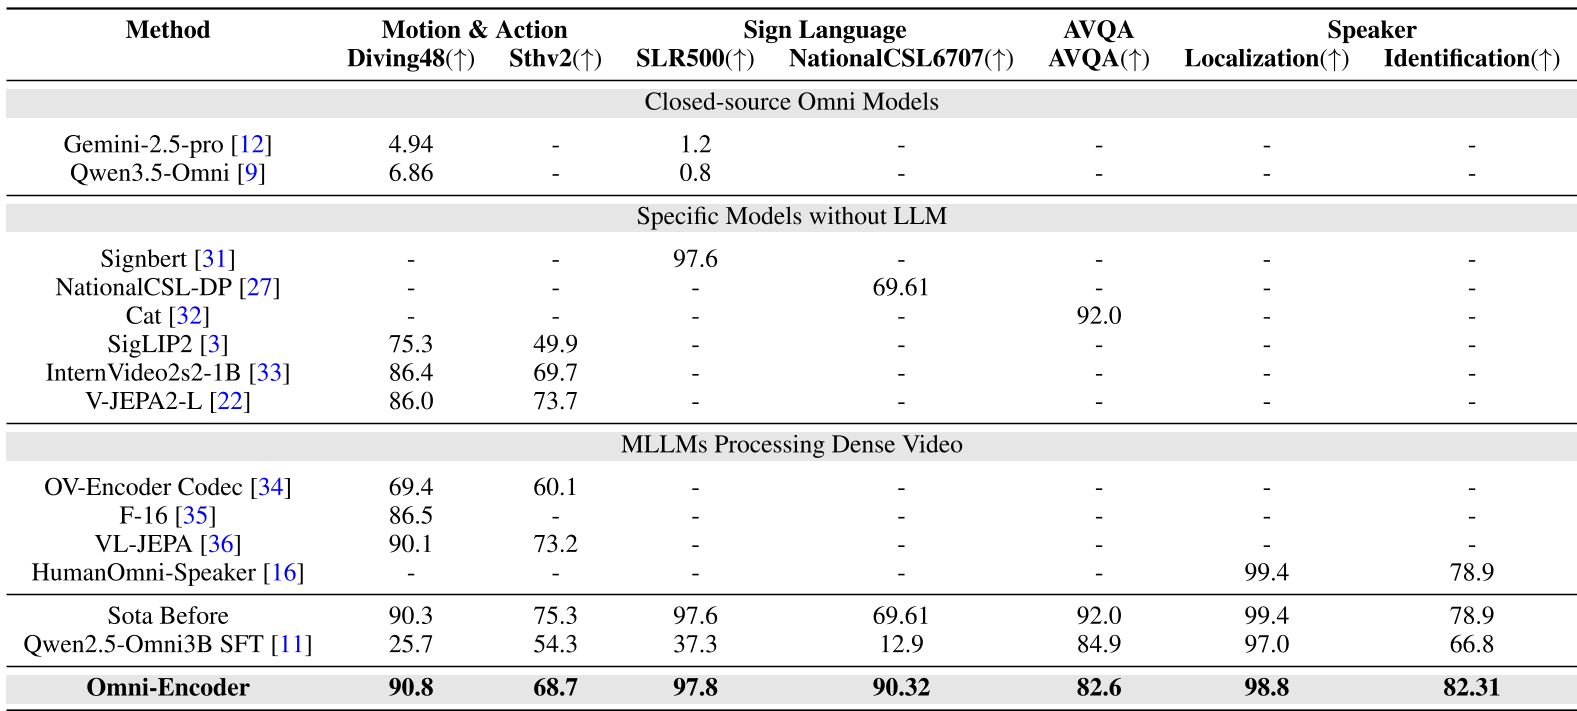
- 精细动作识别:在 Diving48 和 SLR500(手语)任务中,Omni-Encoder 轻松超越了专业模型 SignBERT。
- 手语理解:在极其困难的 NationalCSL 6707 词汇集上,它的准确率从前人的 69.6% 暴涨至 90.3%。
- LLM 兼容性:虽然编码端是稠密的,但通过 Token Sparsifier(令牌稀疏化器),它传给下游 LLM 解码器的 Token 数量依然控制在与 Qwen2.5-Omni 相同的水平,实现了“低成本、高精度”。
深度洞察与总结
Omni-Encoder 的成功揭示了一个深刻的工业趋势:通用模型正在反哺并超越领域专家模型。
- 价值:它证明了在统一架构下,通过引入高频的 Visual Continuous 机制,我们可以不用昂贵的特定任务架构就解决极其复杂的运动识别问题。
- 局限性:目前的训练数据规模(语音部分 < 1000 小时)相比工业级大模型仍显不足,未来在更大规模数据上的扩展(Scaling Up)令人期待。
总结: 当我们不再割裂地看世界,AI 才能真正读懂世界的律动。