
OneDrive:统一多范式驾驶,让视觉、语言与控制共用一个“大脑”
OneDrive: Unified Multi-Paradigm Driving with Vision-Language-Action Models
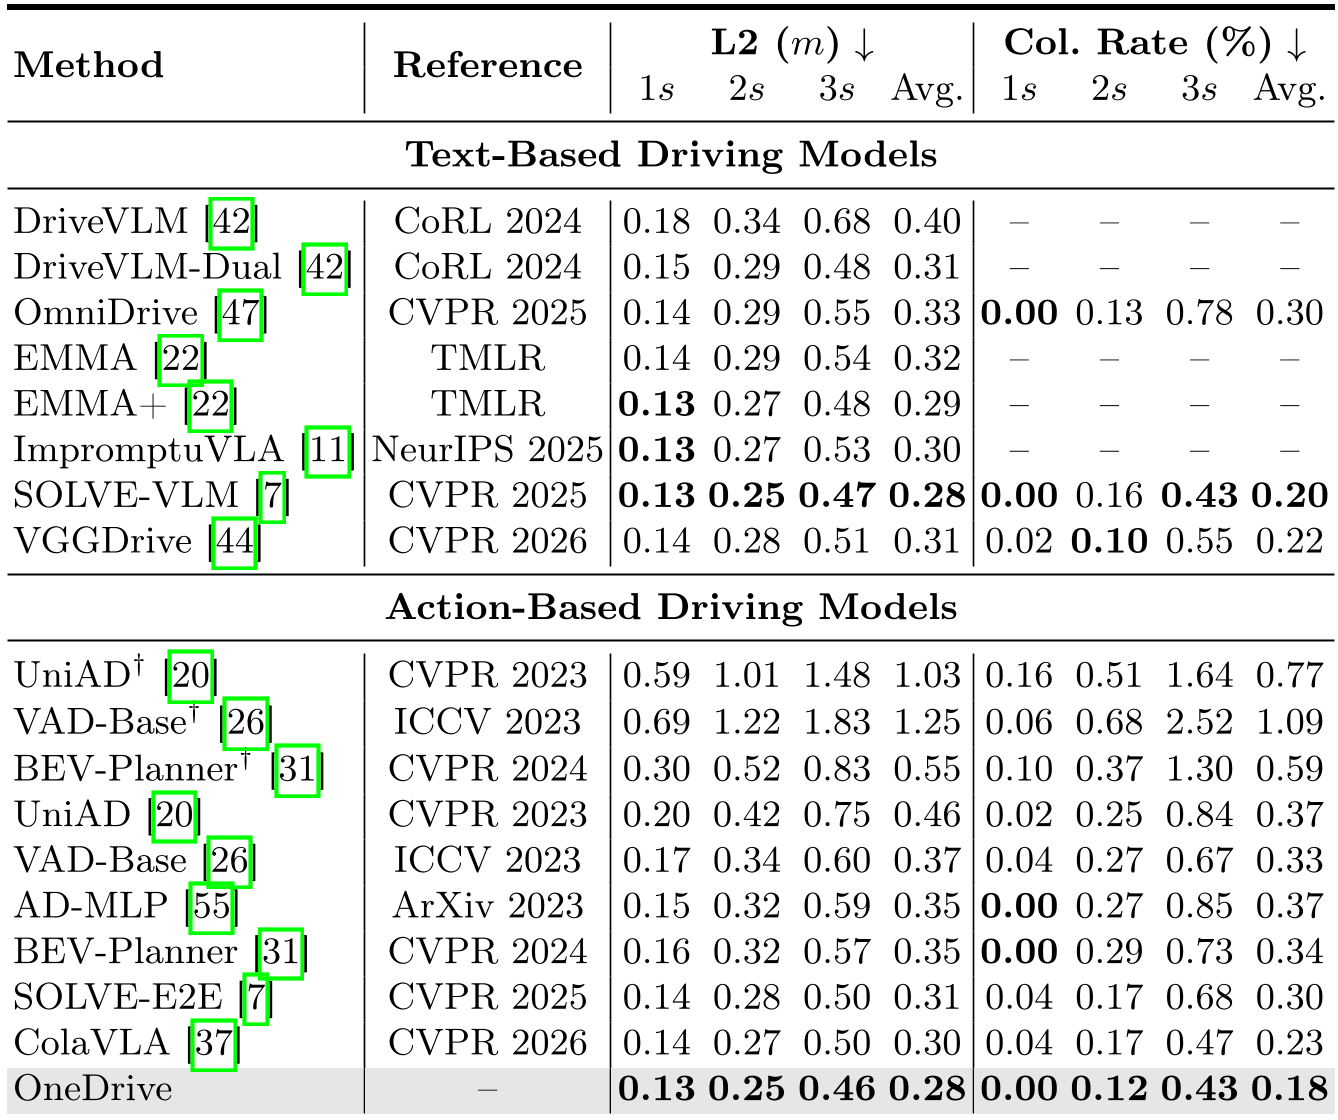
本文提出了 OneDrive,一种基于预训练视觉语言模型 (VLM) 的统一自动驾驶框架。该方法通过将异构任务(自回归文本生成、并行目标检测、轨迹回归)统一在单个 Transformer 解码器中,实现了端到端自动驾驶的 SOTA 性能,在 nuScenes 榜单上达到 0.28 L2 误差和 0.18 的低碰撞率。
TL;DR
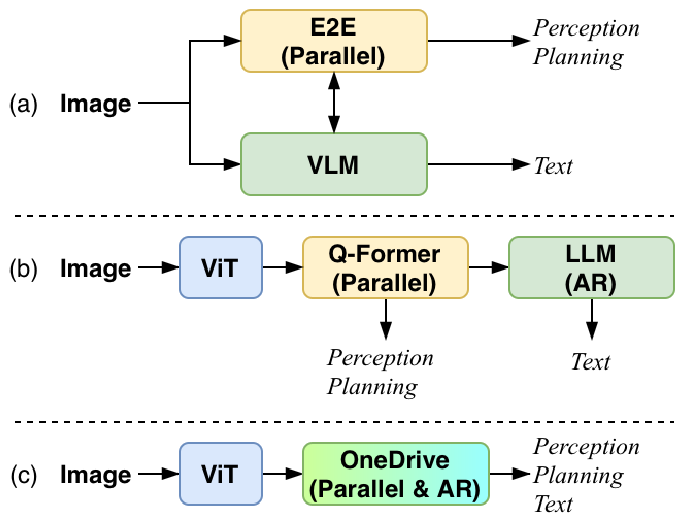
传统的自动驾驶系统往往需要一堆专用的“大脑插件”:一个负责看路(感知),一个负责开车(规划),再来一个负责聊天(VLM)。OneDrive 终结了这种碎片化设计。它通过独特的混合解码器架构,让同一个 Transformer 解码器同时搞定自回归文本生成和并行的轨迹规划,在提升性能的同时,将推理延迟降低了 40%。
背景定位
在自动驾驶领域,开发者们正面临一个“二选一”的难题:要么保持 VLM 的原始架构以获得强大的推理能力(但感知精度差);要么进行大规模的 3D 结构改造(如 BEV 建模),但这会破坏模型与通用大规模数据的兼容性。OneDrive 的出现提供了一条中间道路——在不改变 VLM 核心注意力机制的前提下,兼容异构的驾驶任务。
动机:为什么现有的 VLM 玩不转驾驶?
作者通过实验发现了一个核心直觉(Insight):
- Attention 是通用的:VLM 中预训练的 Causal Attention 模块在捕获视觉特征与查询(Query)之间的对应关系方面表现出惊人的迁移性。
- FFN 是专用的:原有的 Feedforward 模块被强绑定在文本生成上,强制用来做 3D 检测或规划会导致严重的训练不稳定。
因此,OneDrive 的核心思路是:“保留灵魂(Attention),更换工具(FFN)”。
方法论:混合解码器层的精妙设计
OneDrive 的核心在于将所有信息流——视觉 Token、检测 Query、车道线 Query、规划 Query 以及文本 Token——全部塞进一个序列中。
1. 统一 Token 表示
通过 Z = [X_img, Q_det, Q_lane, Q_plan, X_text] 这样的表示,所有任务共享一个特征空间。
2. 混合结构
为了兼顾“语言的先后顺序”和“感知的并行效率”,OneDrive 引入了混合解码器 (Mixed Decoder):
- Causal Attention(共享底层):所有 Token 在相同的因果掩码下处理。因为 Query 放在图像 Token 之后,它们可以自然地感知视觉背景。
- 并行交互模块(感知专用):在浅层解码器中,为感知 Query 增加了额外的自注意力块,允许它们在“看到”图像的同时进行内部协商。
- 任务专用 FFN:为检测、规划等任务定制了独立的转换层。
实验与结果:SOTA 性能与极致效率
1. nuScenes 开环战绩
在标准的感知-规划闭环中,OneDrive 刷新了多项指标。其 L2 误差(0.28m)和碰撞率(0.18%)均优于当前的顶级基线(如 SOLVE, ColaVLA)。这说明统一的架构不仅没削弱性能,反而通过多任务联合优化增强了安全性。
2. 推理延迟
由于 OneDrive 避免了重复前传完整的深度 LLM(通过截断推理模式),其在 NAVSIM 上的延迟从 263ms 骤降至 156ms。这种硬件友好性对于实时驾驶系统至关重要。
深度洞察:为什么这种做法有效?
- 隐式条件建模:在 OneDrive 中,规划 Token 排在感知 Token 之后。这意味着模型在计算规划轨迹时,已经通过 Causal Attention “读”过了感知到的障碍物信息,这种天然的依赖关系比显式的级联设计更具效率。
- 文本监督的正则化作用:实验(Table 5)显示,即使在纯驾驶任务中保留文本生成损失(Text Loss),感知的 mAP 也会提升。这说明语言模型学到的语义规律能像“粘合剂”一样,帮助模型维持更稳健的特征表达。
总结与局限
OneDrive 证明了我们不需要为每种驾驶任务设计复杂的解码器分支。一个“大一统”的序列处理模型足以胜任。
局限性:作者也坦诚,目前使用的 InternVL 视觉 Backbone 在纯 3D 检测上的表现与专门优化的 ViT 仍有差距(主要是因为 VLM 常见的特征下采样导致的细节丢失)。
未来展望:未来的研究将聚焦于如何在预训练阶段注入“物体中心化(Object-centric)”的视觉偏置,让视觉语言模型不仅能“读懂”场景,更能通过更高分辨率的 Token “看清”细小的障碍物。