
[ICML 2025] 当文字成为唯一线索:面向多智能体归因的隐式执行追踪 (IET)
When Only the Final Text Survives: Implicit Execution Tracing for Multi-Agent Attribution
本文提出了 IET (Implicit Execution Tracing),一种针对多智能体系统的元数据无关归因框架。该方法通过在生成过程中将特定密钥信号嵌入 Token 分布(Watermarking),实现了直接从最终文本中以 94% 以上的准确率恢复智能体片段及交互拓扑结构。
TL;DR
在多智能体系统(Multi-Agent System)发生错误时,如果执行日志、Agent ID 全部丢失甚至被刻意抹除,我们还能找到“谁该负责”吗?本文提出的 IET (Implicit Execution Tracing) 框架通过将身份信号隐式嵌入到生成文本的分布中,令成品文本自身成为一份“可自证的执行轨迹”。实验表明,该方法在完全无元数据的场景下,依然能以极高精度还原智能体间的交互拓扑。
背景定位:从“黑盒推理”到“内置仪表化”
目前多智能体系统的故障诊断(Failure Attribution)主要依赖“事后推理”:审计员翻看详尽的日志、分析模型轨迹。但这种模式存在两大痛点:
- 脱敏与断链:文本一旦被复制粘贴出系统环境,元数据便永久丢失。
- 隐私博弈:暴露详细的 Agent 内部轨迹可能触及数据合规红线。
作者由此提出:与其事后去猜,不如在生成时就给每个智能体的输出“打上钢印”。
核心机制:分布层面的隐式“钢印”
IET 的核心逻辑不在于文本表面,而在于 Logits(逻辑值)空间的调制。
1. 密钥条件的分布调制 (Keyed Modulation)
每个 Agent 拥有唯一的密钥。在 Decoding 阶段,IET 使用两个密钥:
- :决定 Logit 空间中固定的扰动方向。
- :取决于上下文的词表置换。 通过这种微小的、肉眼不可见的概率分布调整,Agent 的身份被“锁”在了产生的 Token 序列中。
2. 交互拓扑的编码
为了不仅知道“是谁说了话”,还要知道“他们怎么互动的”,作者将当前的 邻接矩阵 (Adjacency Matrix) 展平并编码为位掩码(Bitmask),作为状态实时更新并注入水印信号中。这意味着文本不但带有“作者名”,还携带了“工作流地图”。
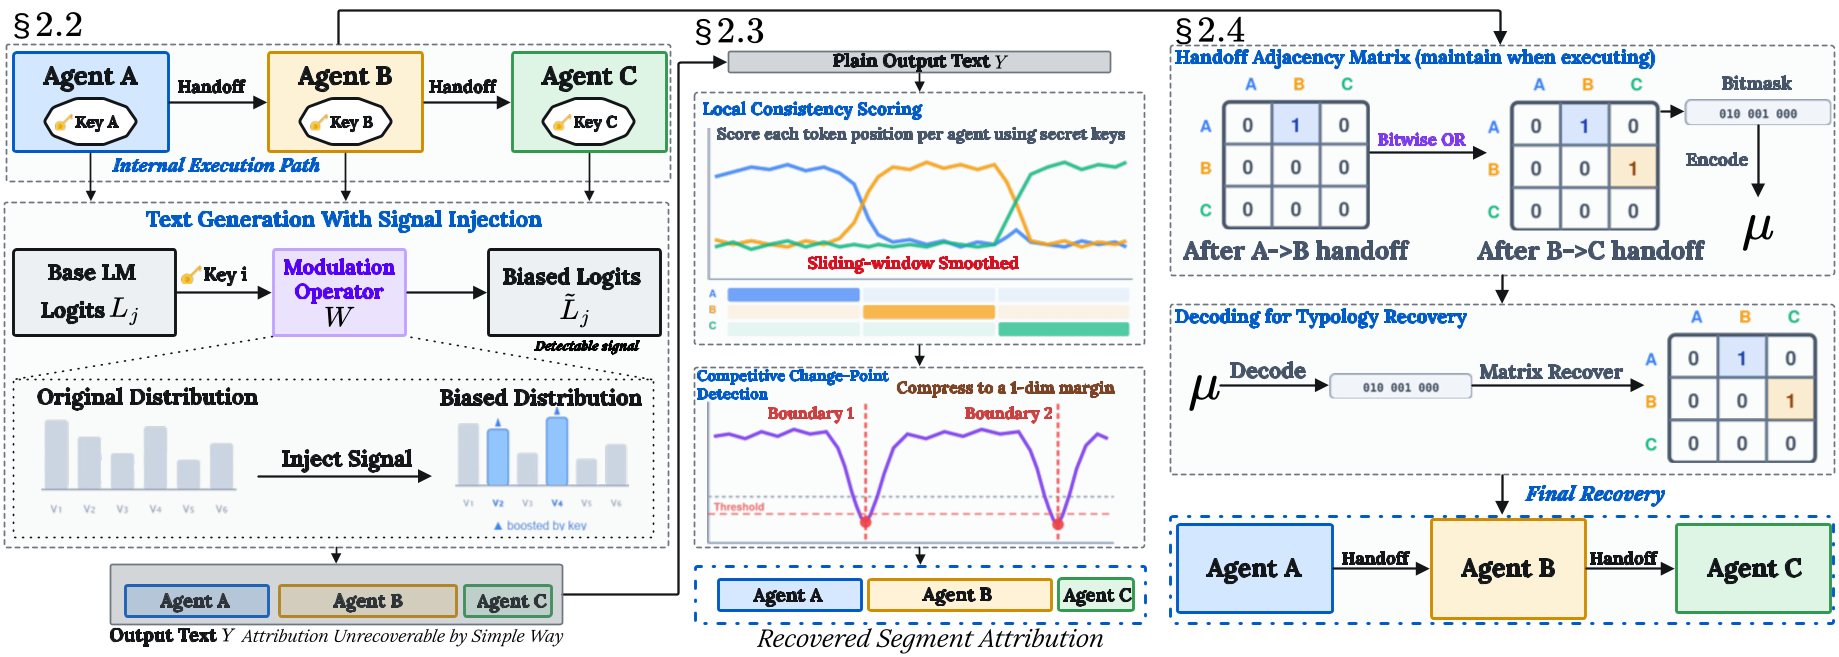 图 2:IET 架构概览:从带水印的生成到基于变点检测的归因恢复过程
边界重构:滑动窗口与竞争变点检测
归因的难点在于:一段长文本中,Agent A 何时结束,Agent B 何时开始? IET 引入了竞争性变点检测 (Competitive Change-Point Detection):
- 计算所有候选 Agent 的得分曲线。
- 计算领先 Agent 与次先者的“边际净胜分” 。
- 利用累积和(CUSUM)算法定位得分发生剧烈波动的转折点。
实验战绩:降维打击般的优势
在多个基准测试(MAMA, Who&When)中,IET 展示了显著的性能优势:
- 极高的归因精度:在 6 个 Agent 的复杂拓扑下,TokenAcc 依然保持在 94% 以上,而纯靠 LLM(如 GPT-4o)自行推理的准确率不足 30%。
- 完美的拓扑恢复:TopoAcc 几乎在所有测试中均达到 100%。
- 隐私处理免疫:即使对文本进行 PII(个人隐私信息)脱敏替换(见下图),归因效果几乎无损。
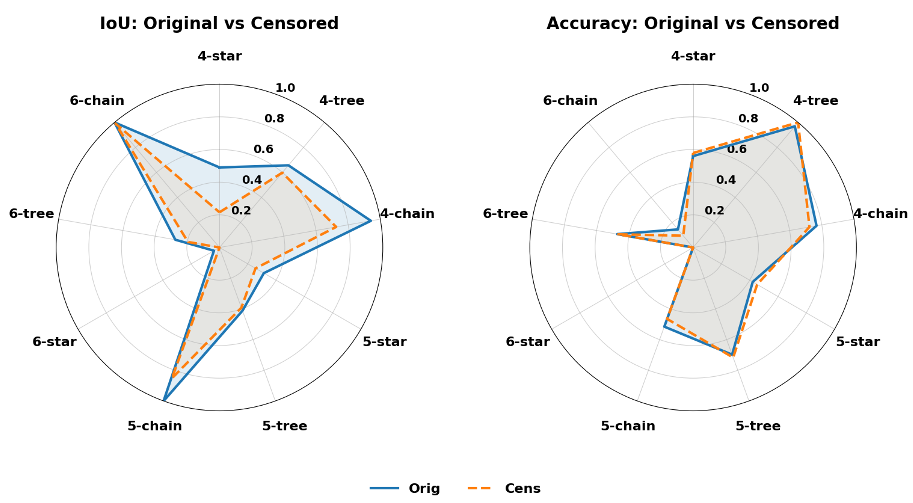 图 3:PII 脱敏后的性能几乎与原图重合,证明信号存在于生成机制而非字面词汇
 表 1:各方法在不同 Agent 数量下的归因性能对比。注意最后一行(Ours)各项指标的压倒性领先。
深度洞察与总结
IET 的成功标志着归因技术从“取证科学”(事后寻找蛛丝马迹)向量“合规设计”(通过系统设计确保可追踪性)的转变。
局限性 (Limitations):
- 虽然本文方法高度鲁棒,但在遭受极强的对抗性改写(Heavy Paraphrasing)时,信号强度可能会衰减。
- 注入信号对生成质量的微小扰动在极端敏感的任务(如代码生成的语法严谨性)中仍需进一步验证。
未来展望 (Future Work): 随着多模型、多厂商协作的 LLM-native 软件普及,IET 提供了一种不依赖中心化日志平台的审计方案。这对于未来 AI 版权的界定、责任的切分(Liability Splitting)具有深远的工程借鉴价值。