
开源图像编辑模型:隐藏的 Zero-shot 视觉专家
Open-Source Image Editing Models Are Zero-Shot Vision Learners
本文系统评估了 Qwen-Image-Edit, FireRed-Image-Edit 和 LongCat-Image-Edit 等开源图像编辑模型在 Zero-shot 视觉任务中的表现。研究发现,这些模型无需任何微调即可执行单目深度估计、表面法线估计和语义分割,且在某些指标上超越了经过特定任务训练的 SOTA 模型(如 FireRed 在表面法线估计上超过了 Marigold)。
TL;DR
腾讯的研究团队发现,像 Qwen-Image-Edit 这样的大型开源图像编辑模型,在没有经历过任何特定视觉任务(如深度估计、法线预测)训练的情况下,展现出了惊人的 Zero-shot 视觉理解能力。通过简单的文本指令引导,这些模型不仅能理解物体边界,还能推断出精准的 3D 空间几何关系,其表现甚至在某些指标上超越了专门微调过的 SOTA 模型。
背景定位:不只是“修图师”,更是“视觉学习者”
在 AI 领域,目前的共识是大型生成模型拥有极强的理解力。然而,这一证据大多来自 Veo 3 等闭源模型。本文填补了开源领域的空白,揭示了一个深刻的 Insight:为了实现高质量的图像编辑,模型必须在内部构建起对场景几何、物体构造成分和空间关系的深刻理解。 这种能力可以被“泵”出来用于稠密视觉任务。
挑战:如何从“图”中提取“量”?
将编辑模型视为视觉学习者的核心难点在于:这些模型输出的是像素(RGB),而视觉任务需要的是数值。作者为此设计了一套精密的解码流程(Prompt-and-Decode):
- 深度估计:引导模型生成亮度代表距离的灰度图,利用 Affine Alignment 解决尺度偏差。
- 表面法线:要求模型遵循标准的 RGB 法线编码协议,并引入了“自动轴校准”来适配不同的坐标约定。
- 语义分割:让模型按指令(例如“路刷成红色”)生成掩码,通过颜色距离函数还原分类标签。
核心架构与方法
该方法最简洁之处在于其 非侵入性。它不需要修改模型代码,也不需要增加任何可学习参数。
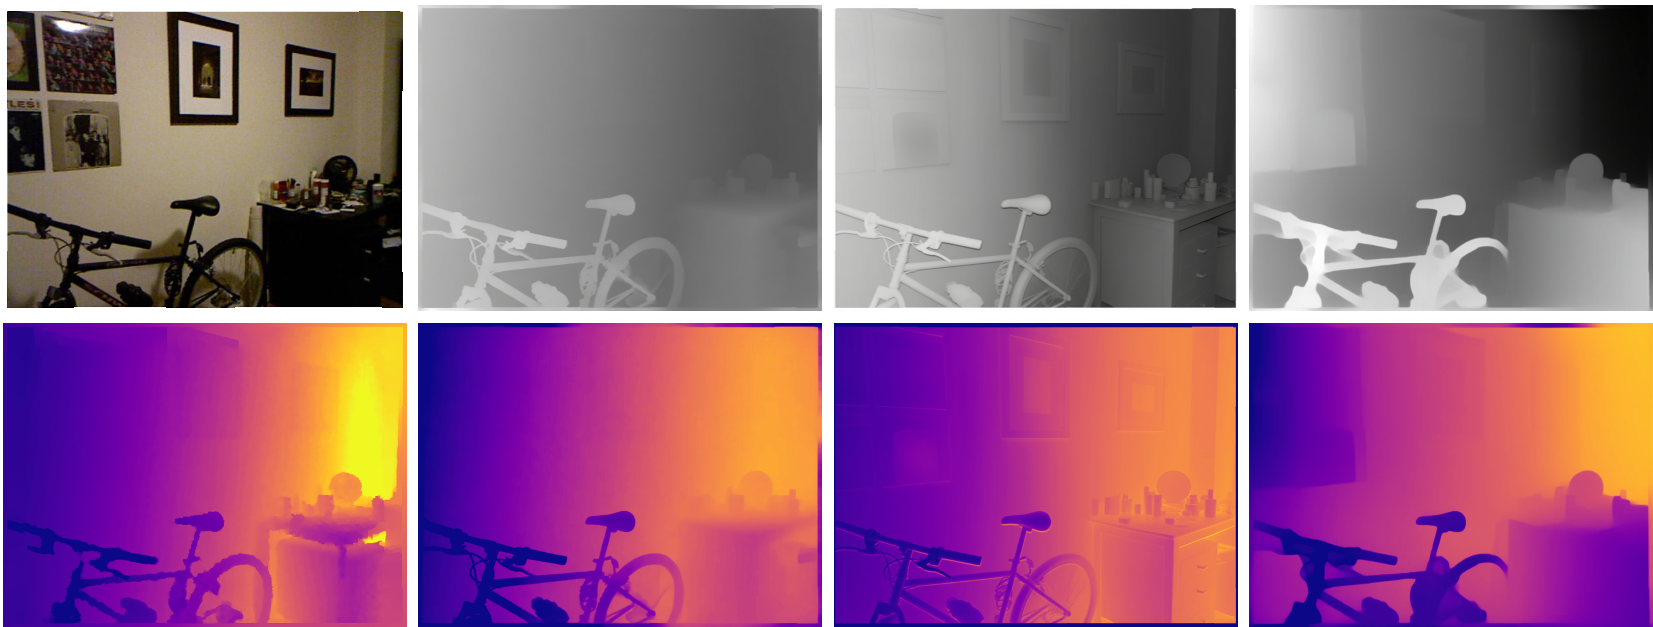 图 1:图像编辑模型执行深度估计的流程,从左至右依次为原图、生成的灰度图、真实的深度图以及解码后的预测结果。
实验结果:震撼的 Zero-shot 战绩
在 NYUv2 测试集上的表现令人侧目:
- 表面法线 (Surface Normal):FireRed-Image-Edit 跑出了 17.69° 的误差,不仅击败了知名的微调模型 Marigold (20.86°),还打平了专门指令微调过的 Vision Banana。
- 深度估计 (Depth Estimation):长猫模型 (LongCat) 在室内场景表现出极强的相对几何恢复能力,δ1 达到 0.822。
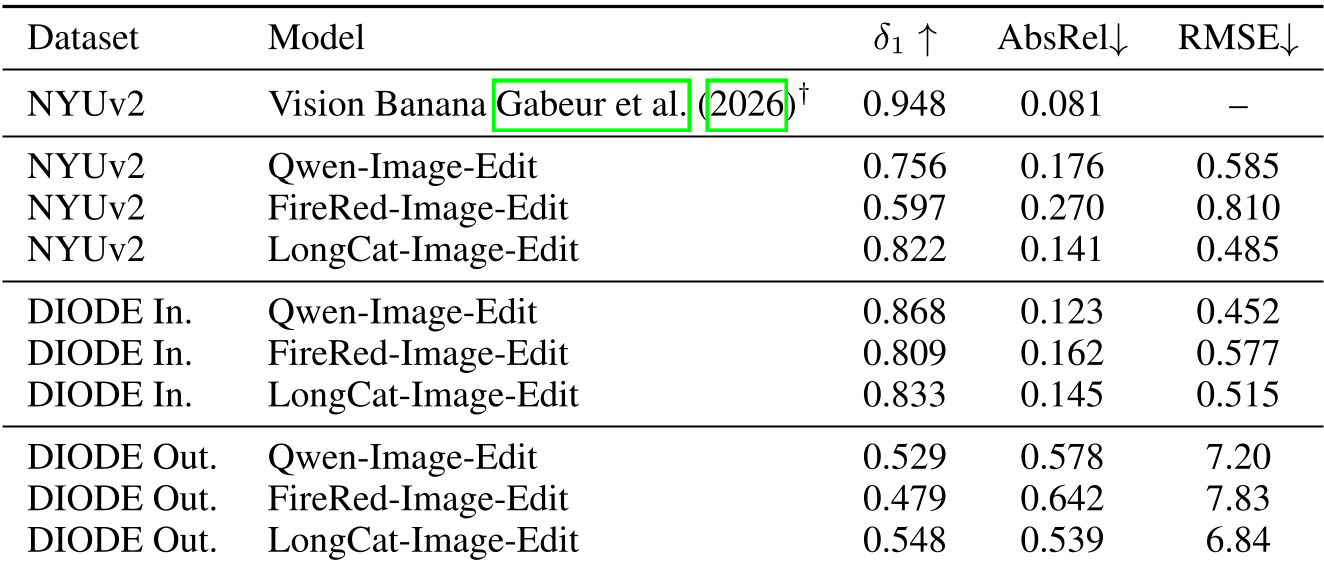 表 1:各模型在不同数据集上的深度估计量化对比,显示了开源模型跨领域的泛化性。
深度洞察:能力的瓶颈在哪里?
尽管 Zero-shot 能力强悍,但研究也暴露出一些“天花板”:
- 格式遵循 (Format Following):有些模型虽然“理解”了场景,但无法严格输出纯净的调色盘颜色(例如在分割任务中出现渐变色),导致解码失败。
- 语义混淆:在复杂的 Cityscapes 19 类分割中,模型虽然能定位物体,但有时会将指定的颜色搞混。
- 几何优于语义:模型对几何(深度、法线)的感知显著强于对精细语义类别的区分。
总结与展望
这项工作证明了图像编辑预训练是一种极佳的“代理任务”。它不仅让模型学会了生成美图,还意外地赋予了模型理解物理世界 3D 结构的能力。
未来的启示:我们可能不需要为每个视觉任务都训练一个专用模型,通过提升生成模型的指令遵循(Instruction Following)质量,这种“通用的视觉推理引擎”潜力巨大。