
OpenSearch-VL:从被动理解到主动探索,打造全开源的多模态深度搜索之王
OpenSearch-VL: An Open Recipe for Frontier Multimodal Search Agents
本文推出了 OpenSearch-VL,这是一个用于训练顶尖多模态深度搜索智能体的全开源方案。该方案涵盖了从数据构建(SearchVL-SFT-36k/RL-8k)、多元化模型工具集(增强、识别、搜索)到创新的强化学习算法(Fatal-aware GRPO),在七项基准测试中平均提升超过 10 个百分点,达到甚至超越了商业闭源模型的表现。
TL;DR
在 AI 向 Agent(智能体)进化的浪潮中,多模态深层搜索(Multimodal Deep Search)被视为通往 AGI 的必经之路。然而,受限于数据的封闭和长程推理过程中的高失效率,开源社区一直缺乏能与 GPT-4o 或 Gemini-Pro 抗衡的搜索 Agent。腾讯混元与港中大、港大团队联手推出的 OpenSearch-VL,通过一套包含 44k 高质量交互轨迹、视觉预处理工具库以及“致命错误感知”GRPO 算法的组合拳,彻底打破了这一僵局。
背景定位:解决“搜索 Agent”的幻觉与脆弱
目前的 MLLM 在处理复杂查询时,往往存在两个致命伤:
- 偷懒(Shortcuts):如果题目中出现了明显的实体名,模型会直接检索最终答案,而跳过了图片理解过程,导致其在处理“隐性信息”时能力匮乏。
- 链式崩溃(Cascading Failures):在长达 8-10 步的工具调用中,如果第 3 步因为图片不全或 OCR 识别错误导致了报错,传统的 RL 训练会将后续所有错误的 Token 一起喂给模型,产生巨大的梯度噪声。
核心方法:构建“三位一体”的搜索食谱
1. 数据炼金:防止检索“捷径”
团队通过对 Wikipedia 知识图谱进行路径采样,构建了多跳推理链条。为了迫使模型必须看图,他们采用了 Fuzzy Entity Rewriting(模糊实体重写):
- 将确切的实体名(如:史蒂夫·欧文)重写为属性描述(如:那位在1991年接管这家动物园的男士)。
- 这种做法确保了模型必须先通过
ImageSearch或OCR确认图片主体,才能进行下一步检索。
2. 主动感知:给模型配备“滤镜”和“矫正器”
不同于以往只具备 WebSearch 的 Agent,OpenSearch-VL 拥有一套完整的视觉预处理工具箱(Visual Toolset):
- Sharpen/SuperResolution:处理模糊或低像素局部。
- PerspectiveCorrect:校正拍照倾斜的文档。
- Crop:空间注意力机制,聚焦关键细节。
这种设计赋予了模型一种“先修复、后分析”的直觉,极大地提升了在真实、嘈杂环境下的部署能力。
3. 致命错误感知 GRPO (Fatal-Aware GRPO)
这是本文最具学术深度的改进。在 RL 过程中,如果 Agent 连续 3 次调用工具失败,系统会判定该轨迹进入“致命状态(Fatal)”。
- 掩码(Masking):直接截断致命步之后的 Token,不参与训练。
- 单侧优势钳制(One-sided Advantage Clamping):如果一个失败轨迹的前半部分做得很好(得分高于组内平均值值),模型会依然强化前半部分的正确行为;反之,若得分低于平均值,则直接归零,防止学习到错误的逻辑。
 图 1:OpenSearch-VL 训练框架总览,展示了从 SFT 到强化学习的演进过程。
实验战绩:开源力量的觉醒
在涵盖了 SimpleVQA、VDR、MMSearch 等 7 个极具挑战性的榜单上,OpenSearch-VL 展示了强大的统治力:
- 跨尺度胜出:其 8B 版本便超越了之前的 SOTA 模型 SenseNova-MARS;32B 版本则直接在多个任务上击败了 Gemini 2.5 Pro。
- 长程鲁棒性:如图 3 所示,Fatal-aware GRPO 使得模型能够在更长的交互回合中保持高准确率,而不会像普通 GRPO 那样随着步数增加而崩溃。
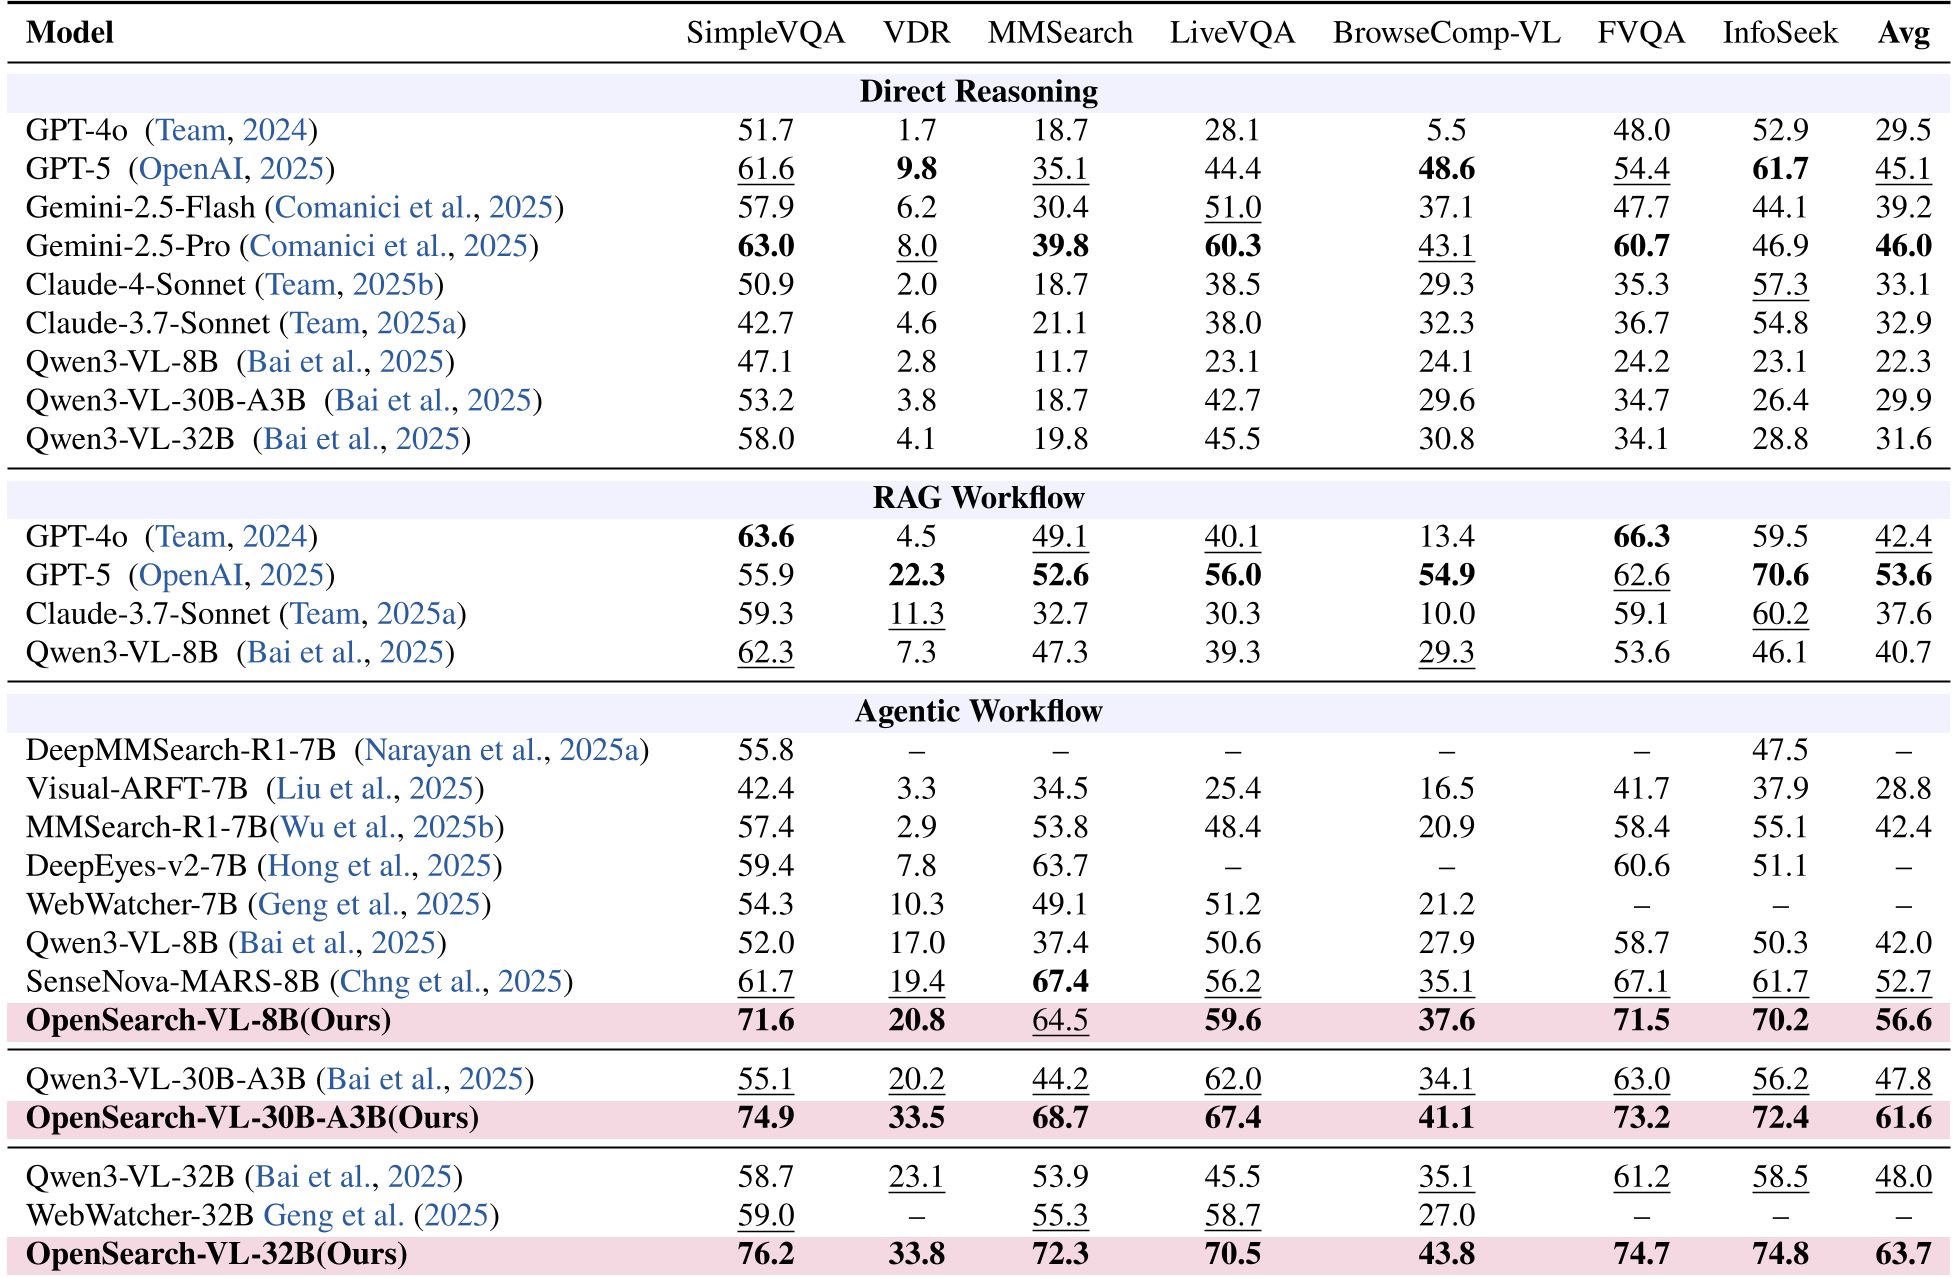 表 1:OpenSearch-VL 与主流商业模型及开源基线的性能对比。
深度洞察:为什么这篇论文很重要?
OpenSearch-VL 的成功揭示了一个深刻的洞察:Agent 的能力上限并不只取决于 LLM 本身的推理能力,更取决于它对环境反馈的容错处理(Fault Tolerance)。
通过在强化学习算法中显式建模“失败”,并鼓励模型在失败发生前进行卓有成效的尝试,团队解决了困扰 Agent 社区已久的梯度污染问题。这为未来构建更复杂、具备自我修复能力的工业级 Agent 指明了方向。
局限性与展望
尽管表现卓越,但 OpenSearch-VL 仍依赖于外部商业 API(如 Serper, GPT-4o 裁判等),这在一定程度上影响了完全本地化的复现性。未来的方向将集中在开发开源的进程奖励模型(Process Reward Models),使 Agent 能够不再依赖“昂贵的判官”,实现完全自主的进化。
总结:OpenSearch-VL 不仅仅是一个模型,它是一套开源的“ Agent 工业化方案”,从数据的源头到 RL 的最后一公里,为多模态智能体研究立下了新的标杆。