
OpenSeeker-v2:仅靠 SFT 步入搜索智能体巅峰,学术界的硬核逆袭
OpenSeeker-v2: Pushing the Limits of Search Agents with Informative and High-Difficulty Trajectories
本文推出了 OpenSeeker-v2,这是一个突破性的开源搜索智能体(Search Agent)。通过仅使用 10.6k 条高质量、高难度的合成数据进行 Supervised Fine-Tuning (SFT),该模型在 30B 规模下刷新了 4 项核心榜单的 SOTA,在 ReAct 范式下性能超越了依赖重度强化学习(RL)的工业界顶级模型。
TL;DR
在 AI 搜索领域,工业界巨头往往通过“大模型+重度 RL+海量算力”来堆砌性能。上海交通大学 OpenSeeker 团队推出的 OpenSeeker-v2 却走了一条截然不同的路:通过精心合成 1 万条极具挑战性、长轨迹、多跳推理的 SFT 数据,在 30B 参数规模下,一举击败了通义千问、RedSearcher 等经过 CPT+SFT+RL 重重打磨的工业级模型。
背景定位
长久以来,Deep Research 这种深度搜索能力被视为大厂专利。原因在于这类智能体不仅要懂交互,更要有极强的长程规划(Long-horizon Planning)和健壮的信息处理能力。OpenSeeker-v2 的出现打破了这一僵局,它证明了:数据难度(Difficulty)和丰富度(Richness)才是决定智能体上限的核心瓶颈,而非模型训练流程的复杂程度。
核心洞察:为什么要“难”?
传统合成数据往往落入“一搜即得”的陷阱:
- 浅层检索:问题太简单,智能体点一个搜索链接就收工了,学不到复杂的容错和回溯能力。
- 线索单一:上下文信息量小,不需要多源证据聚合。
作者认为:如果让智能体在训练时只能接触到必须经过 60 步以上交互才能解决的“硬核”问题,它就会被迫学会更深层次的推理与策略选择。
方法论详解:三位一体的数据炼金术
OpenSeeker-v2 并没有修改模型的底层架构(基于 Qwen3-30B-Thinking),而是对数据合成管线进行了三项关键手术:
-
图谱规模扩展 (Scaling Graph Size): 在合成任务时,将基于种子的证据子图规模从 扩展到 。这意味着环境中充斥着海量的 topologically 相关信息,模型必须在更复杂的上下文里筛选证据,促成了“跨多节点聚合”的深度搜索。
-
严格低步数过滤 (Strict Low-step Filtering): 这是最“激进”的一点。作者设定了一个最小工具调研步数阈值 ,任何在这个步数内就找到答案的轨迹都被无情丢弃。这确保了训练集是一个“魔鬼训练场”,迫使智能体习惯于长周期的信息搜寻。
-
万级精品数据: 相比于动辄数以百万计的通用 SFT,OpenSeeker-v2 仅使用了 10.6k 条轨迹。这种“少而精”的策略证明了对于垂直领域任务,质量的权重远高于数量。
实验与结果:以小博大的奇迹
在反映真实搜索能力的多个 Benchmark 上,OpenSeeker-v2 展现出了惊人的跨级打击能力:
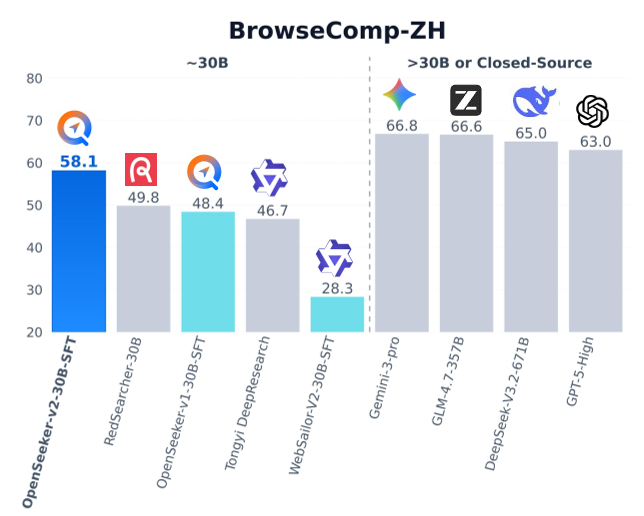
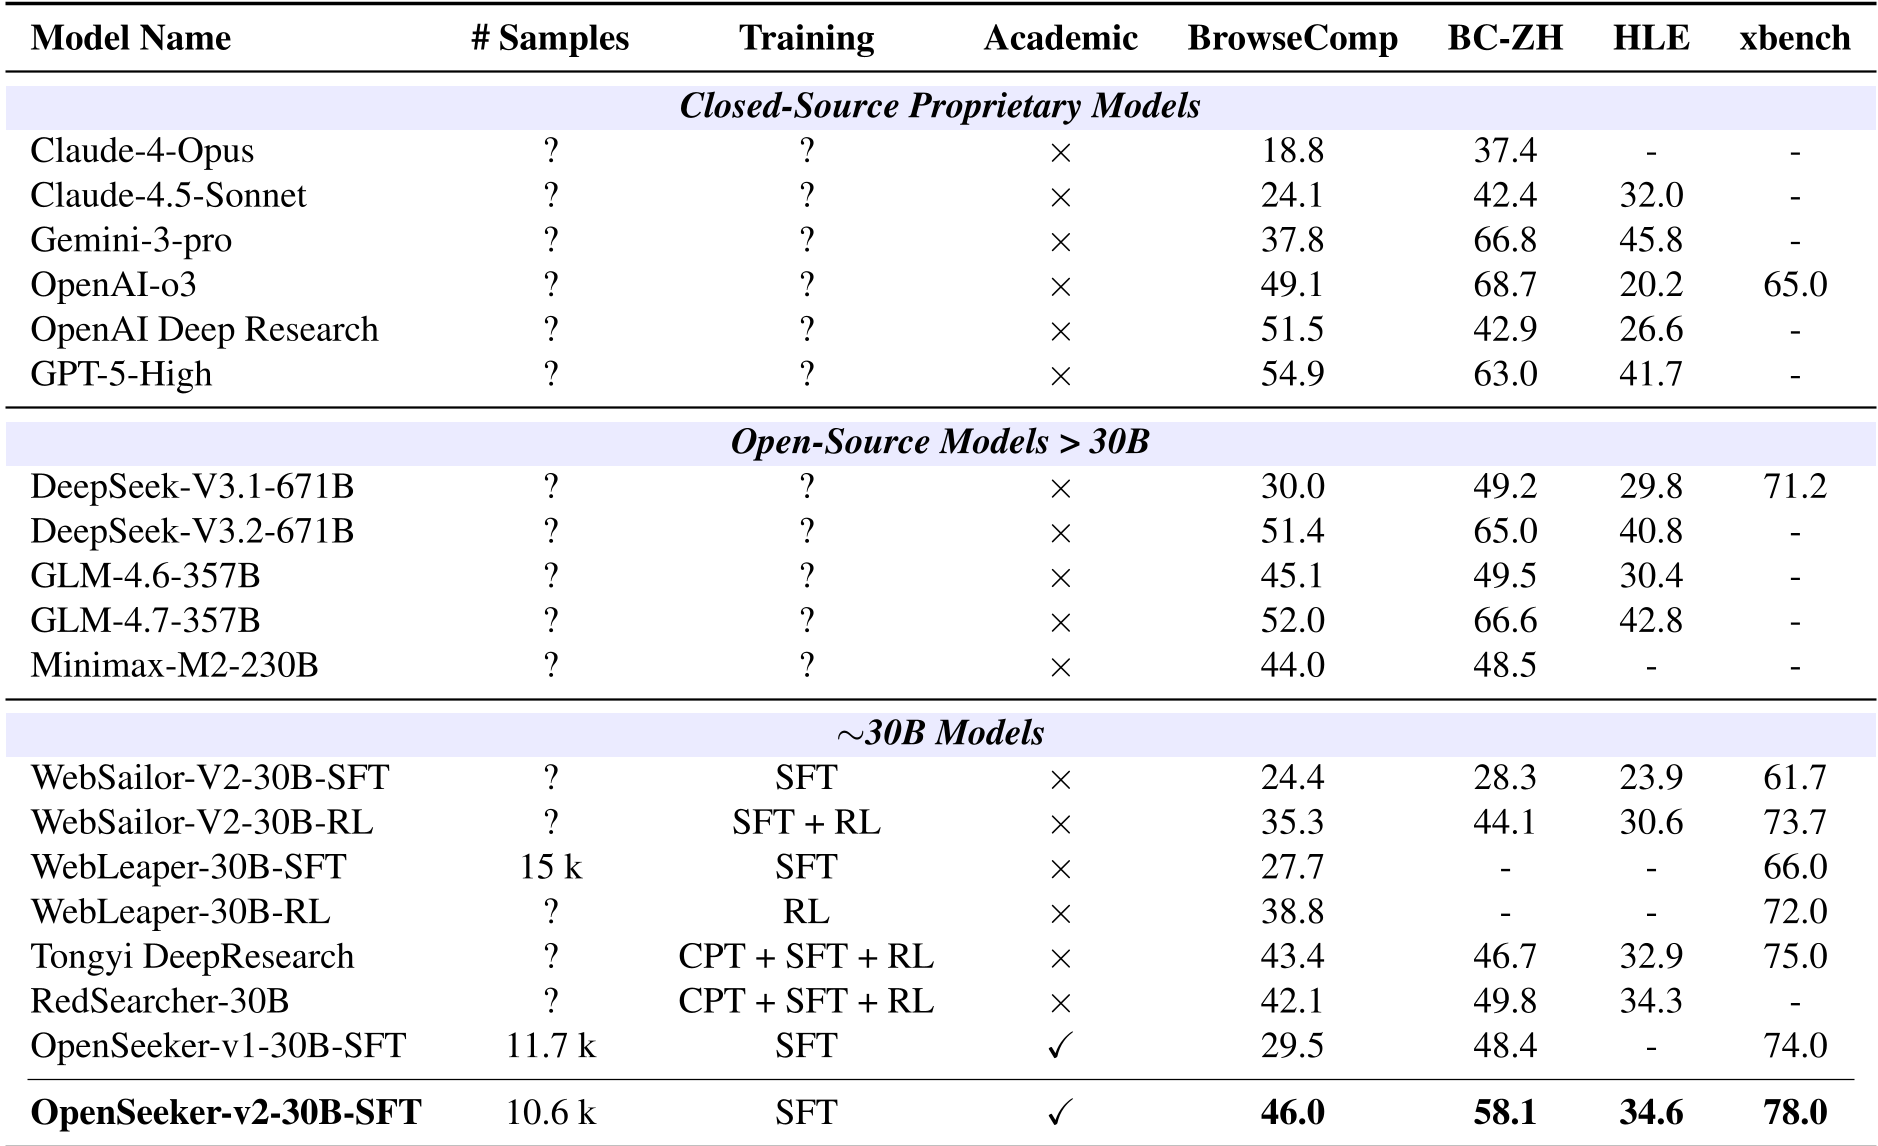
- 超越工业管线:在 BrowseComp 等榜单上,它比通义千问 DeepResearch 强出 2.6% 到 11.4% 不等。
- 碾压巨量模型:即使面对 671B 的 DeepSeek-V3.1 或 357B 的 GLM-4.6,30B 规模的 OpenSeeker-v2 依然保持领先。
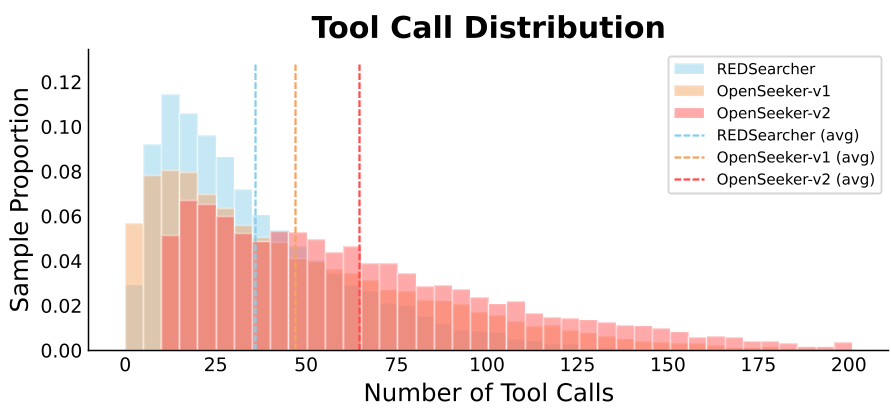
从数据统计图(图2)可以清晰看到,OpenSeeker-v2 的轨迹平均步数(64.67 步)远超同类工作(RedSearcher 为 36.01 步)。这种**“耐力测试”**式的训练是其成功的关键。
深度洞察:SFT 真的够了吗?
虽然这篇论文高调宣布了 SFT 的胜利,但我们要保持客观。SFT 虽然能诱导(Induce)出极强的搜寻行为,但 RL 往往在对齐(Alignment)和长序列的鲁棒控制上有更高的天花板。
OpenSeeker-v2 的贡献在于:它为整个社区提供了一个极高的 Baseline。它告诉我们,与其在复杂的 CPT 和 RL 算法上纠结,不如回过头来认真思考“如何让模型接触到更具挑战性的场景”。
总结与局限
Takeaway:搜索智能体的上限在于数据,而非算力。长轨迹、高难度、多工具交互是未来 Agentic Workflow 的标准配置。
局限性:虽然 SFT 表现强劲,但在面对从未见过的极端边缘案例(Corner Cases)时,缺乏 RL 探索的模型可能会表现出机械性的重复。此外,30B 的模型规模在某些极高难度的推理任务上仍可能存在硬件本身的智能瓶颈。
OpenSeeker-v2 目前已完全开源,这不仅是学术界的一次胜利,也为普惠 AI 搜索技术立下了新的标杆。