
OPSD 的真相:它在压缩而非修复你的数学模型
OPSD Compresses What RLVR Teaches: A Post-RL Compaction Stage for Reasoning Models
本文提出了对一种名为 OPSD(策略内自蒸馏)的后训练机制的深度诊断,重点探究其在思维链(CoT)数学推理模型中的作用。研究发现 OPSD 在此类任务中本质上是一种“压缩”而非“纠错”技术,通过在 SFT 和 RLVR 之后引入 OPSD,可以在保持推理准确率的同时显著降低推理成本。
TL;DR
在 AI 追求“思维能力”的竞赛中,推理成本(Token 数量)成为了新的瓶颈。本文通过严谨的消融实验证明:On-Policy Self-Distillation (OPSD) 在长文本数学推理中并不是一种“纠错”工具,而是一个极其高效的“压缩器”。它的最佳生态位是在强化学习(RLVR)之后,作为精简推理步骤、降低计算成本的最后一道工序。
背景定位:后训练阶段的第三种路径
传统的模型强化通常分为两条路:
- RLVR (基于验证的强化学习):通过奖励信号(Reward)从头探索路径,能提升上限,但生成的逻辑往往像“碎碎念”,废话极多。
- SFT (监督微调):模仿专家数据,但受限于静态数据集的分布。
OPSD 曾被寄予厚望,认为它能通过“带答案的老师教学生”的方式实现准确率跃迁。然而,本文揭示了它在具备“思维能力”的模型上的真实局限性。
核心洞察:为何 OPSD 无法“妙手回春”?
作者提出了一个深刻的假设:
- 在短文本任务中,教师(看到答案的自己)可以明确告诉学生“这个词错了,改用那个词”。
- 在长链数学推理中,教师虽然知道答案,却很难在成百上千个推理步骤中精准定位哪一步是导致失败的“蝴蝶效应”起点。
通过对正确和错误 rollout 的拆分实验,研究发现:
- 对正确样本做 OPSD:模型学会了删掉那些“Hmm... 让我想想”、“不对,我再检查一下”等冗余的信心标记和冗余循环。
- 对错误样本做 OPSD:由于教师信号在错误路径上表现出“事后聪明”的偏见,它倾向于粗暴地缩短路径,导致模型在关键逻辑节点上缺乏探索,反而破坏了准确率。
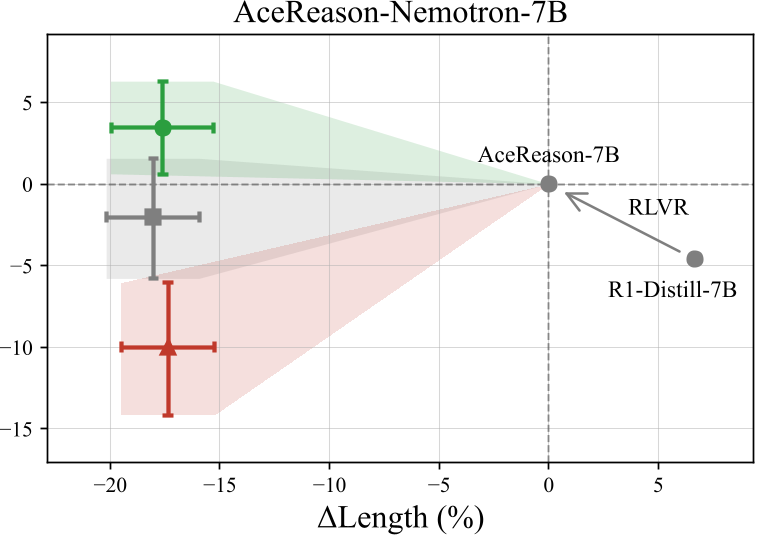 图 1:OPSD 在准确率-长度平面上的表现。可以看到,“仅针对正确样本训练”可以在保持准确率的同时大幅向左移动(缩短长度)。
方法论:一种更科学的后训练流水线
基于“OPSD 压缩本质”的发现,作者提出了 SFT → RLVR → OPSD 的三阶 pipeline。
1. 架构解析
OPSD 的核心公式旨在最小化学生分布与教师分布之间的 KL 散度:
L_OPSD = E[ D_KL( Student || Teacher_with_Context ) ]
这里的 Teacher 其实就是模型自己,只不过它在输入端额外读到了“正确答案”或“反思建议”。
2. 压缩效应的证据
实验显示,经过 OPSD 处理后,模型中诸如 "wait", "hmm", "perhaps" 这类带有犹豫和检查性质的词汇密度显著下降(下降 13% 到 23%)。这意味着 OPSD 实际上在惩罚“思考过程中的低效率”。
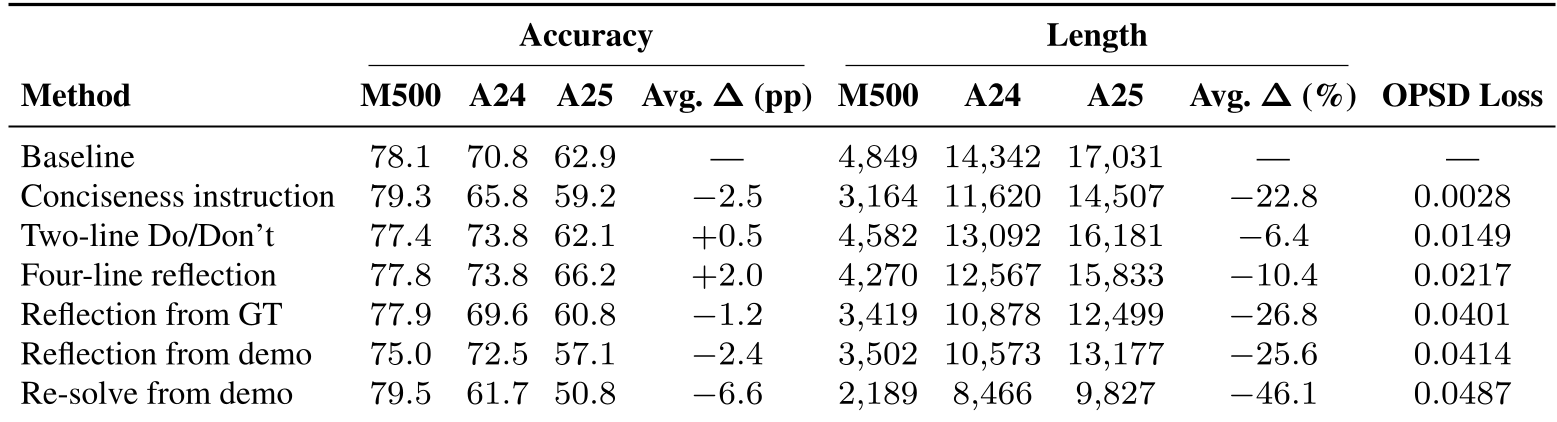 表 4:即使给教师提供更丰富的演示(Demo),OPSD 依然倾向于压缩长度而非修复错误。
实验与结果:快准稳的工程方案
在 Qwen3 和 DeepSeek-R1-Distill 等主流模型上的实验表明:
- 效率极高:只需几百次优化步骤(极少的算力成本),就能获得比专门的长度惩罚 RL 更好的压缩效果。
- 鲁棒性强:在 MATH500 和 AIME 等高难度数学竞赛题集中,这种“仅对正确轨迹训练”的压缩模型表现极稳。
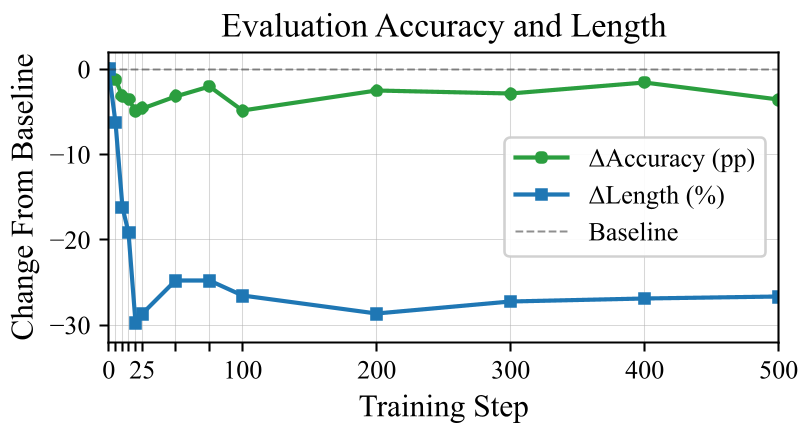 图 3:长度压缩在训练的前 25 步就已成型,后续训练只是在微调这一压缩状态。
深度见解:我们应该如何利用它?
总结 (Takeaway): 不要指望用 OPSD 来替代 RL 或提升模型的 IQ。它的真正使命是 “提纯”。正如作者所言,OPSD 应该放在 pipeline 的最后——当 RLVR 已经让模型掌握了解决问题的能力,产出了足够多的正确推理轨迹后,用 OPSD 来把这些轨迹“脱水”,让推理变得更快、更便宜。
局限性 (Limitations):
- 本文尚未探讨多模态或其他非数学推理领域的泛化性。
- OPSD 可能会在极端情况下导致模型“过度自信”,从而降低其在非常规问题上的自我纠错能力。
未来展望: 随着推理模型集成到实时交互中,如何以毫秒级响应提供复杂逻辑将成为核心竞争力。OPSD 这种“低成本轨迹精简”技术,极具工程价值。