
优化器-模型一致性:为什么微调时你不该更换优化器?
Optimizer-Model Consistency: Full Finetuning with the Same Optimizer as Pretraining Forgets Less
本文提出了“优化器-模型一致性”(Optimizer-Model Consistency)现象,即在监督微调(SFT)阶段,使用与预训练阶段相同的优化器进行全参数微调,能实现最优的学习-遗忘权衡。研究涵盖了 AdamW 和新兴的 Muon 优化器,并在 Llama-2-7B 等模型上验证了该结论。
TL;DR
在 LLM 的预训练-微调范式中,我们通常关注数据质量和微调技术(如 LoRA)。然而,UIUC 和 Apple 的研究者近期揭示了一个被长期忽视的变量:优化器的一致性。研究表明,在 SFT 阶段使用与预训练阶段相同的优化器,能产生最佳的“学习-遗忘权衡”(Learning-Forgetting Tradeoff),表现甚至优于被神话的 LoRA。
核心发现:优化器在“塑造”模型
过去我们认为优化器只是寻找代价函数最小值的工具,但本文指出:优化器实际上在物理上塑造了模型的权重分布和激活特性。
- AdamW (A1,∞ 系列):倾向于产生稀疏的激活值。
- Muon (A2,2 系列):产生更稠密的权重谱分布(高 Stable Rank)和稠密激活。
这种塑造作用导致了所谓的优化器-模型一致性:预训练后的模型已经适应了特定优化器带来的正则化效应。如果在 SFT 阶段切换优化器,更新方向将不再契合预训练留下的“曲率特征”,从而导致严重的灾难性遗忘。
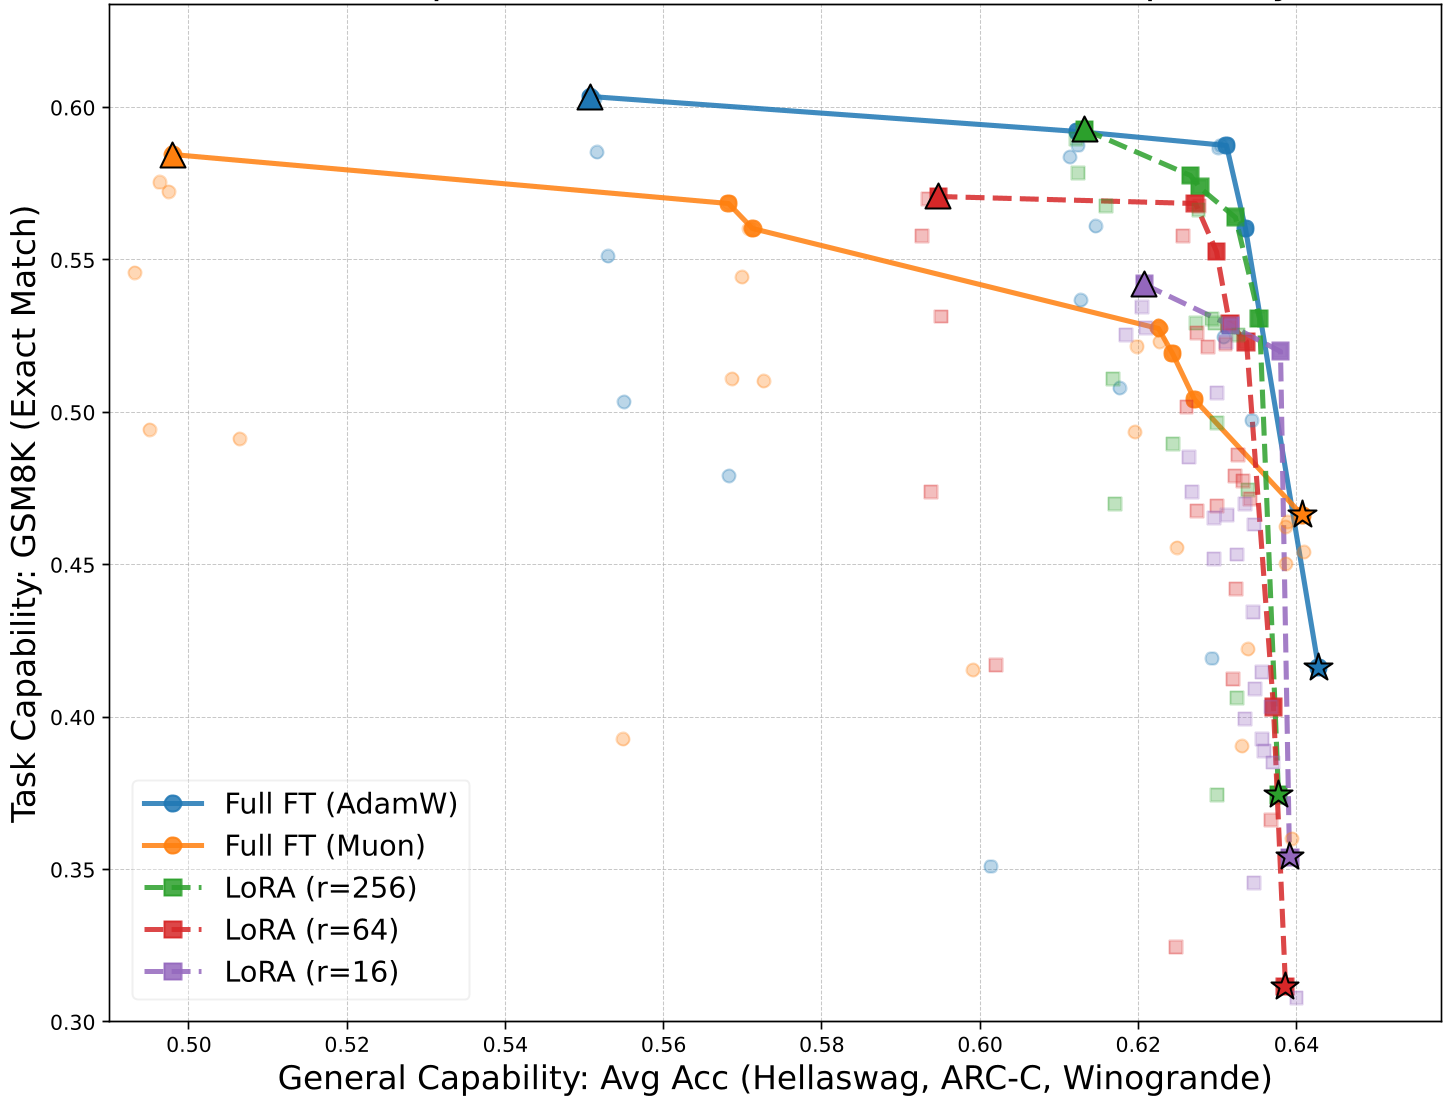 图 1:在 Llama-2-7B 的数学微调实验中,AdamW(预训练优化器)全微调的 Pareto 前沿(最右上角)显著优于 LoRA 和其他优化器组合。
深度视点:激活正则化的直觉
为什么 AdamW 预训练的模型在 AdamW 微调下遗忘最少?作者通过数学推导(基于 Taylor 展开和 Fisher 信息矩阵)给出了直觉:
- 激活正则化:优化器本质上在限制某种范数。AdamW 对应 范数,天然诱导激活值的稀疏性(类似 Lasso)。
- 曲率匹配:遗忘损失 与输入激活值的二阶矩 成正比。当 SFT 优化器与预训练优化器同族时,更新方向 能更好地利用这种特定的稀疏/稠密特性,从而在不破坏原有知识的前提下学习新任务。
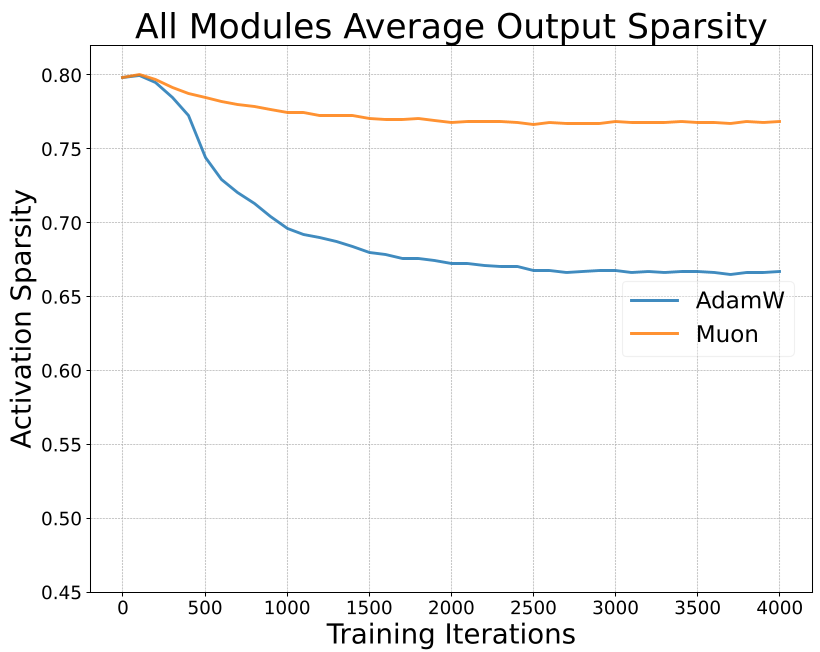 图 4:实验观察显示,AdamW 预训练的模型激活值明显比 Muon 稀疏,这验证了优化器对模型微观行为的长期塑造。
指点江山:LoRA 的神话破灭了?
学界普遍认为 LoRA 遗忘少是因为参数量小。但本文提出了更有力的洞察:
- 学习率才是关键:如果对全参数微调和 LoRA 同时进行严谨的学习率搜索(Grid Search),全参数微调(配合一致优化器)总能找到一个点,在相同的学习效果下比 LoRA 遗忘更少(见上图 1)。
- 结论差异:此前认为 LoRA 遗忘少的论文通常只对比了单一的最优学习率,而忽略了整体的 Tradeoff 曲线。
警示:Muon 的“阿喀琉斯之踵”
Muon 作为近期 DeepSeek-V3/V4 等模型采用的明星优化器,预训练极其强悍。但本文揭示了它的弱点:过强的记忆倾向。
在合成语言建模实验中,研究者将数据分为“清洁数据”和“随机洗牌后的损坏数据”。结果发现:
- Muon 记忆更快:它在完全无逻辑的损坏数据上准确率显著高于 AdamW。
- 推理能力不足:在需要学习逻辑模式(而非单纯死记硬背)的数学和代码 SFT 任务中,Muon 的优势大幅缩减,甚至不如 AdamW。
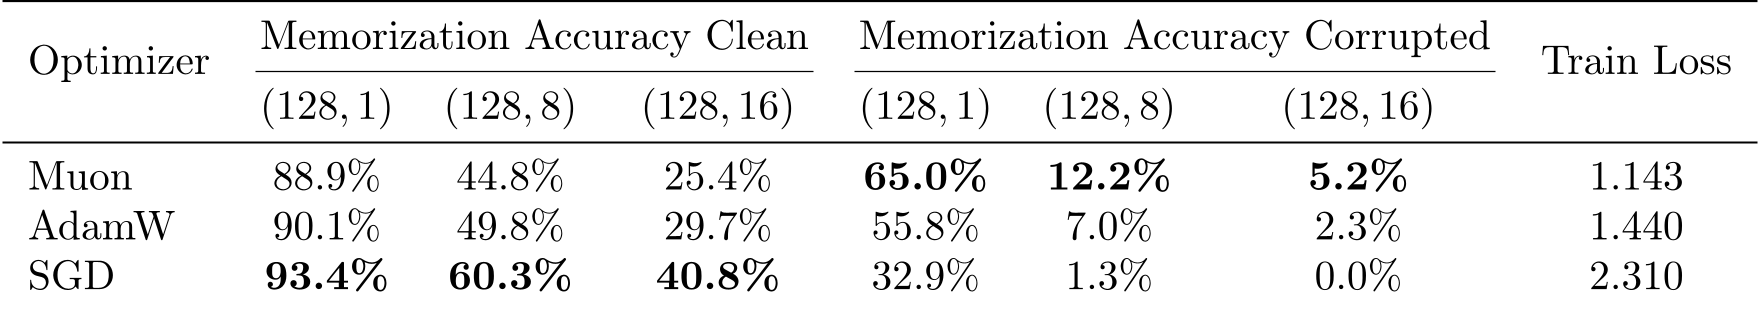 表 3:Muon 在损坏数据上的高准确率揭示了其更容易陷入“死记硬背”的陷阱,这解释了它在推理类微调任务中的疲软。
总结与启示
本项研究为工业界提供了实用的微调建议:不要轻易更改优化器种子。 如果你的基础模型是用 AdamW 练的,SFT 最好也用 AdamW 并辅以全量微调;如果你使用的是 Muon 预训练的模型,虽然一致性要求你继续用 Muon,但要警惕它在推理任务上的记忆过载风险。