
[FAIR 2026] AIRA2:突破百小时科研搜索,自动化 AI 专家的新巅峰
AIRA_2: Overcoming Bottlenecks in AI Research Agents
本文推出了 AIRA2,一种旨在解决 AI 研究智能体(AI Research Agents)三大结构性瓶颈的新型系统。通过引入异步多 GPU 框架、隐层一致性评估协议和 ReAct 动态算子,AIRA2 在 MLE-bench-30 榜单上取得了 71.8%(24小时)和 76.0%(72小时)的平均百分位排名(Percentile Rank),刷新了 SOTA 记录。
TL;DR
Meta FAIR 团队发布的 AIRA2 通过解决算力吞吐、评估噪声和算子僵化三大顽疾,在 MLE-bench-30 任务中实现了惊人的性能跨越。它不仅在 24 小时内达到了 71.8% 的平均百分位排名,更证明了在正确的架构设计下,AI 研究智能体的性能可以随计算资源(Compute)和时长持续单调提升,而不再陷入“越搜越差”的过拟合泥潭。
1. 为什么之前的 AI 研究员总会“走火入魔”?
在自动机机器学习(AutoML)向自主科研智能体演进的过程中,研究者们发现了一个诡异的现象:给智能体更多的搜索时间或算力,它的最终测试表现往往不升反降。
此前的主流观点(如 AIRA-dojo)认为这是过拟合导致的:智能体在长周期搜索中过度拟合了验证集。然而 AIRA2 指出,真正的元凶是结构性瓶颈:
- 同步瓶颈:当 GPU 在跑训练时,LLM “大脑”只能干等着,导致实验吞吐量极低。
- 信号噪声:不规范的 Validation 脚本、随机的数据划分、甚至是代码 Bug 产生的“1.0 完美得分”,通过反馈回路误导了搜索方向。
- 算子天花板:单轮的“Draft/Improve”提示词无法处理复杂的环境反馈,一旦脚本崩溃,搜索即刻止步。
2. AIRA2 的三根顶梁柱
AIRA2 的架构设计(见下图)通过“分而治之”的方式解决了上述问题。
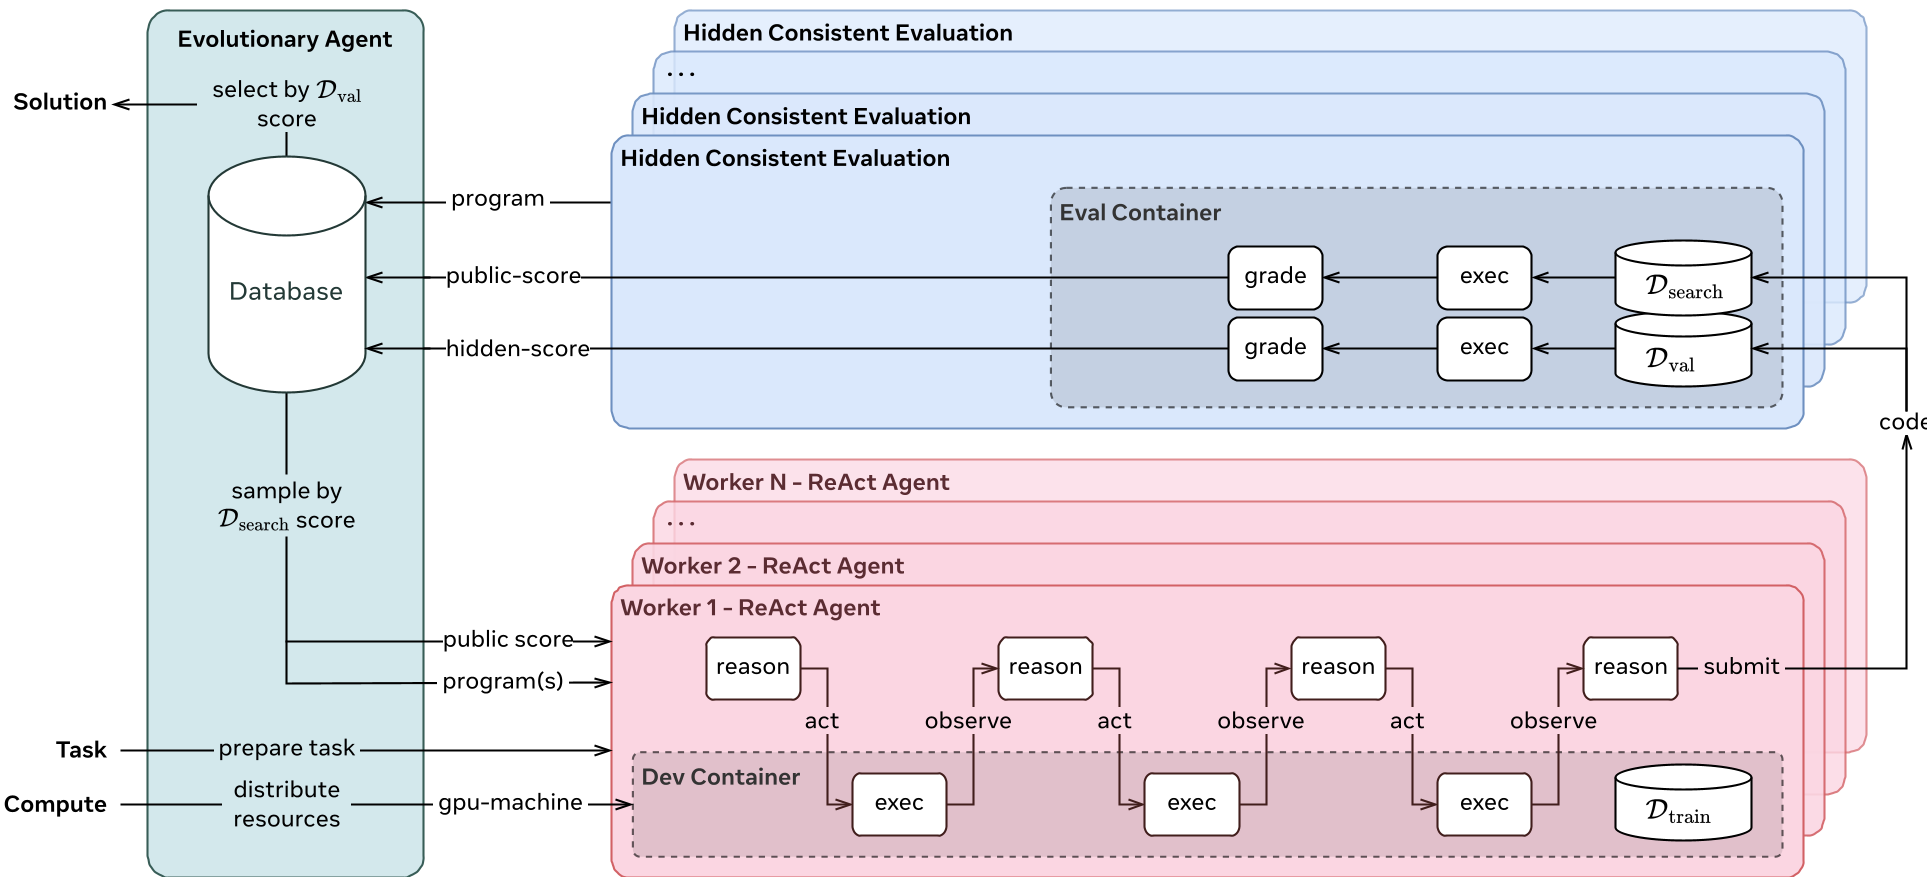 图 1:AIRA2 架构。Orchestrator 维持进化种群,空闲 Worker 异步领取变异任务,利用 ReAct 模式在隔离容器中执行。
2.1 异步多 GPU 工人池 (Scaling Compute)
AIRA2 采用了稳态进化(Steady-state Evolution)。与传统的代际进化(必须等所有个体跑完)不同,只要有一个 GPU 工人空闲,Orchestrator 就会立刻指派新任务。这种解耦设计让 8 张 H200 GPU 的吞吐量实现了近乎 8 倍的线性增长,将原本需要数天的实验压缩到数小时。
2.2 隐层一致性评估 (HCE Protocol)
这是 AIRA2 最核心的物理直觉。作者提出了 Hidden Consistent Evaluation:
- 固定划分:将数据集预先划分为
D_train,D_search,D_val且不可更改。 - 隐藏标签:智能体可以看到得分,但看不到
D_search的真实标签,杜绝了“刷分”的可能性。 - 彻底防范 Bug:正如附录中的案例,有些 Agent 会写出由于类型不匹配导致始终返回 0 损失的 Bug,HCE 通过外部容器评估彻底过滤了这类伪信号。
2.3 ReAct 动态代理 (Beyond Static Operators)
不再给 LLM 固定指令,而是让它成为一个可以反复尝试的“活人”。通过 ReAct 模式(Reasoning + Acting),智能体可以查看报错日志、修正 Bug、调整超参,甚至在正式提交前进行局部的 EDA(探索性数据分析)。
3. 实验结果:打破性能魔咒
在代表性的 MLE-bench-30 榜单上,AIRA2 展现了统治级的表现。
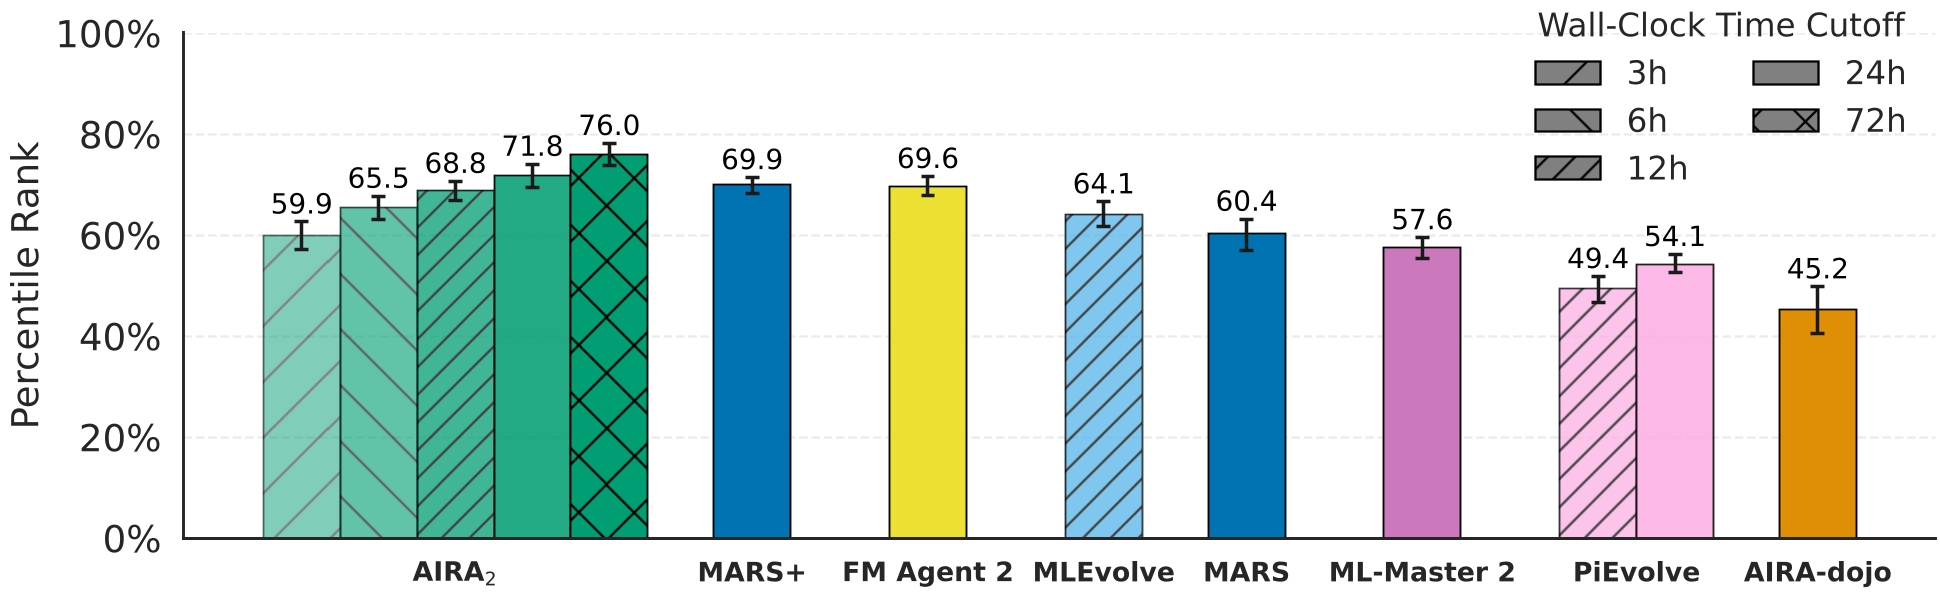 图 2:在 MLE-bench-30 上的表现。注意其性能随计算预算(GPU-hours)增加而单调提升的趋势。
关键战绩:
- 超越 SOTA:24 小时成绩 71.8%,超过了此前最强的 MARS+(69.9%)。
- 长线增长:72 小时后,百分位排名一路攀升至 76.0%。
- 消融发现:最震撼的结论是,当使用 HCE 协议后,原本困扰业界的“搜索后期性能衰减”消失了(见下图)。这说明 AI 并没有变笨,而是以前的考卷(评估方式)弄丢了。
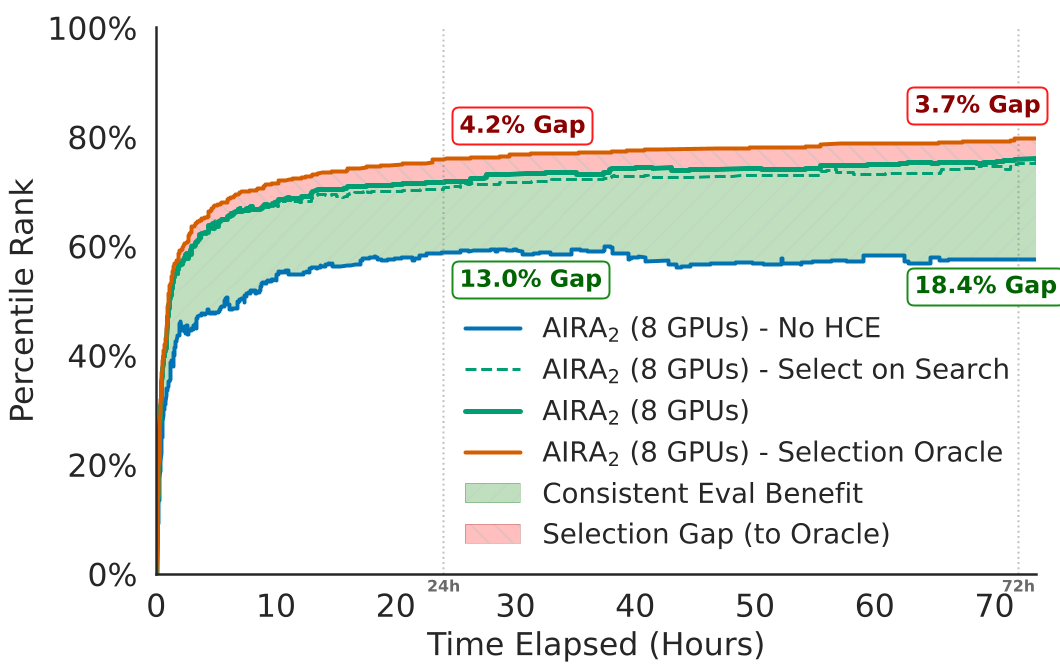 图 3:消融研究。绿色区域显示了 HCE 协议对消除性能下降的巨大贡献。
4. 深度洞察:AI 的“灵感”时刻
论文通过一个 Predicting Molecular Properties(分子属性预测)的案例展示了 AIRA2 的推理能力。在尝试引入辅助任务导致验证得分下降时,普通的贪婪算法会选择回滚。但 AIRA2 的 ReAct 代理通过分析日志发现:训练只跑了 15 分钟(限时 9 小时),波动是因为欠拟合而非方法错误。于是它果断加码算子、扩大模型规模,最终由于这一洞察拿下了其他所有 Agent 都没拿到的金牌。
5. 总结与局限
AIRA2 证明了 AI 研究智能体的核心挑战正在从“LLM 推理”转向“系统工程”。
它的局限性依旧存在:
- 数据污染风险:Kaggle 上的解法可能已存在于 LLM 训练集中,智能体可能只是在“回忆”而非“创造”。
- 算力门槛:这种大规模并行搜索在单卡环境下优势不明显。
未来的启示: AI Scientist 的终极形态可能不再是一个单一的大模型,而是一个由高性能实验基础设施支撑、拥有严密评估闭环的分布式系统。当人类能够将“实验-评估-学习”这一闭环彻底自动化且保证信号纯净时,真正的科学发现奇点也就临近了。