
MDN:并行逐步动量——打破线性注意力的“SGD瓶颈”
MDN: Parallelizing Stepwise Momentum for Delta Linear Attention
本文提出了 Momentum DeltaNet (MDN),一种通过“逐步动量(Stepwise Momentum)”法则增强线性注意力机制(Linear Attention)的新型架构。MDN 在 1.3B 规模下实现了 SOTA 性能,尤其在长文本检索和语言建模任务中大幅超越了 Mamba2 和 Gated DeltaNet。
TL;DR
在大型语言模型(LLM)向超长上下文演进的过程中,线性注意力机制(Linear Attention)以其 的复杂度成为 Transformer 的有力竞争者。然而,传统的线性更新机制本质上是“朴素 SGD”,难以保留细粒度的长期记忆。本文提出的 Momentum DeltaNet (MDN) 通过引入 Stepwise Momentum(逐步动量) 规则,并攻克了块并行训练(Chunkwise Parallelization)的数学难题,在保持推理速度的同时,显著提升了模型的检索精度。
1. 痛点:为什么线性注意力需要动量?
当前的线性模型(如 Mamba2, GLA, GDN)之所以能够 work,是因为它们将隐藏状态的更新建模为一种 在线优化(Online Optimization)。但问题在于,这些模型使用的都是最基础的 SGD 更新。
- SGD 的缺陷:对梯度噪声极其敏感,且存在快速的信息衰减(Rapid Decay),这解释了为什么 Mamba 类模型在复杂检索任务(如 Needle-In-A-Haystack)中往往表现不如 Transformer。
- 动量的直觉:在优化算法中,动量法通过累积历史梯度来平滑轨迹、抵消噪声。在线性注意力中,这意味着模型可以获得更长、更稳健的历史信息访问能力。
2. 核心挑战:因果性与并行性的博弈
动量法虽然好,但很难在 LLM 的标准训练流程中并行。
- 传统做法:很多非线性 RNN(如 TTT, Titans)采用块级动量(Blockwise),这会破坏块内的因果掩码(Causal Mask),导致训练和推理时表现不一致。
- MDN 的突破:作者提出了一种全新的并行算法,通过对系数进行“几何重排”,将复杂的嵌套累加解耦为高效的计算项,实现了 Stepwise Momentum(即块大小为 1 的严格因果动量),这是以往研究难以企及的。
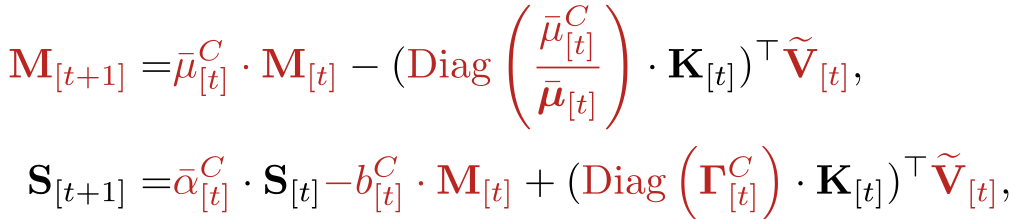 上图展示了 MDN 的核心更新逻辑,通过 状态显式地维护动量分量。
3. 动力系统:二阶系统的魔力
MDN 不仅仅是简单加了一个动量项。从特征值(Eigenvalue)分析的角度看:
- 一阶系统(如 GDN/Mamba):其特征值被限制在实数轴上。这意味着它们只能进行单纯的衰减(Decay)或状态追踪。
- 二阶系统(MDN):引入动量后,动态方程演变为二阶系统。特征值可以是复共轭对(Complex Conjugate)。
- 物理直觉:这使得 MDN 能够捕捉到阻尼振荡(Damped Oscillations)。这种振荡能力赋予了模型“相位感知”的记忆力,从而更好地模拟复杂的序列依赖。
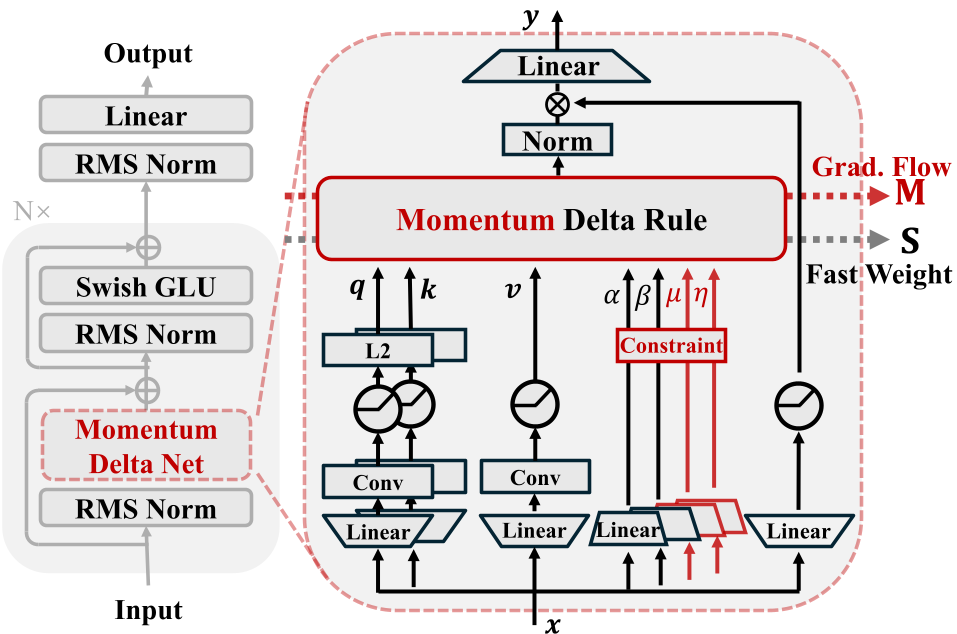 图 (b) 展示了动量引入后的复平面特征值轨迹,显著扩展了表达空间。
4. 关键实验结果:检索性能的跨越式提升
在 400M 和 1.3B 的规模下,MDN 展示了极强的统治力:
- MQAR 任务:在多查询关联召回这一核心指标上,MDN 表现极佳,甚至超过了专门为此优化的 KDA 模型。
- 长文本建模:在 8k 长度的 Needle-In-A-Haystack 实验中,MDN 在多针任务上的表现由于所有基线,这直接证明动量机制能更有效地保留复杂上下文。
- 训练速度:作者通过编写高度优化的 Triton 内核,使得 MDN 虽然状态量更多(双倍状态),但训练吞吐量与 Mamba2 等模型处于同一梯队。
 MDN 在保持线性注意力的常数推理成本(Constant KV cache)的同时,取得了更优的准确率 PPL。
5. 深度洞察与局限
洞察:MDN 的成功在于其“隐性建模能力”。分析发现,MDN 在解码过程中快权(Fast Weight)的状态变化范数(Change Norm)显著大于其他模型,这表明动量让隐藏状态在处理序列时表现出更丰富、更活跃的动力学特性。
局限性:
- 显存开销:由于需要维护两个状态( 和 ),在极端大模型上可能会带来一定的显存压力。
- 缩放验证:目前实验最高到 1.3B,在 7B 或更大规模上的 Scaling Law 表现仍有待进一步验证。
总结
Momentum DeltaNet 是一项将经典优化洞察与现代硬件感知架构设计完美结合的工作。它通过解决并行化的数学障碍,证明了“动量”对于提升线性模型表达能力的不可或缺性,是迈向高效万亿级长上下文模型的重要一步。