
PFlowNet:打破几何精度迷思,用“变分感知流”重塑视觉推理
Perceptual Flow Network for Visually Grounded Reasoning
本文提出了 Perceptual Flow Network (PFlowNet),这是一种通过结构化“感知流”(Perceptual Flow)来增强多模态大模型(LVLM)视觉推理能力的框架。该方法在 V* Bench (90.6%) 和 MME-RealWorld-lite (67.0%) 等基准测试中刷新了 SOTA 纪录。
TL;DR
在视觉语言模型(LVLM)领域,我们习惯于认为模型“看”得越准,“想”得就越对。然而,ICML 2026 的这篇论文 PFlowNet 告诉我们:最精确的专家标注并不等同于最优的推理证据。作者通过引入一种解构化的“感知流”(Perceptual Flow)架构和变分强化学习,让模型在保持视觉可靠性的同时,学会自主寻找对推理最有帮助的视觉线索,显著刷新了多项 SOTA。
痛点深挖:专家模型的“管窥之见”
目前的 visually grounded reasoning (VGR) 任务通常依赖专家模型提供的几何先验(如 Bounding Box)来约束模型的幻觉。但作者发现了一个反直觉的现象:当你给模型喂入由专家标注的、极其精准的物体切图时,模型的推理准确率反而下降度性。
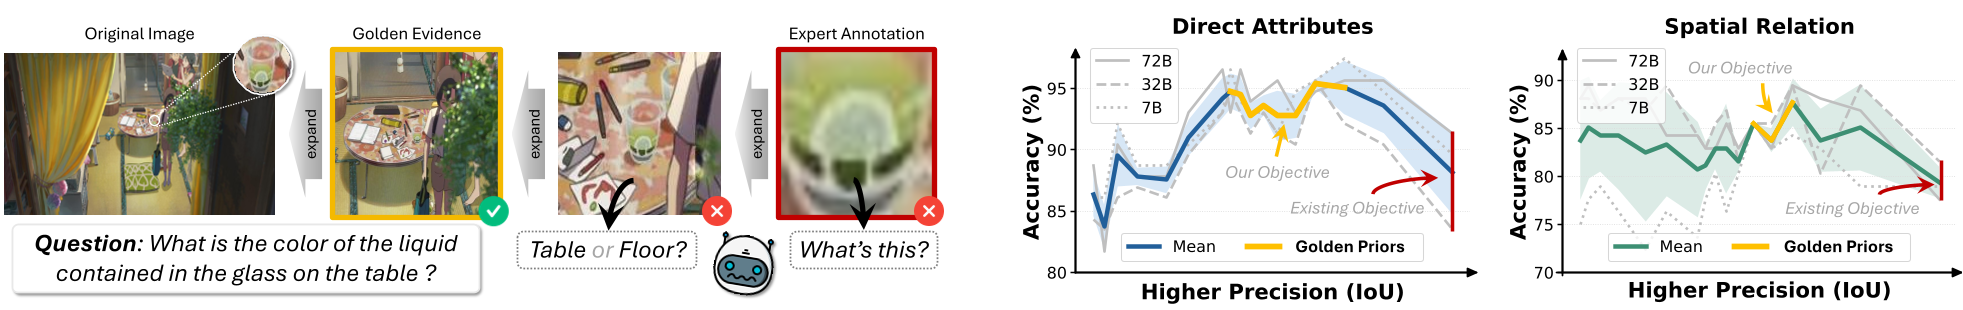 图 1:IoU 精度与准确率的矛盾关系。可以看到,全图或适度扩张的标注往往优于极度精确的专家标注。
这种现象源于设计初衷的错位:专家检测模型追求几何孤立,而推理需要上下文(Context)。如果生搬硬套专家的标注,会导致模型产生“管窥效应”,丢失关键的辅助推理信息。
核心方法:解耦感知与推理
PFlowNet 不再强迫模型去复刻静态的几何坐标,而是提出了 Perceptual Flow 的概念。它将推理过程拆解为两个核心阶段:
- 感知流生成 (Flow Generation):
- Planning State ():首先用自然语言思考“我该看哪里”。
- Perceptual States ():生成一系列 RoI 坐标及其相应的描述性文字。
- 流引导推理 (Flow-guided Reasoning):将这些视觉“思维轨迹”作为前缀,引导模型生成最终答案。
变分强化学习:从对齐到搜索
为了优化这一过程,PFlowNet 采用了变分强化学习。其核心在于 Sub-Trajectory Balance (SubTB) 目标函数,这使得模型能够在长轨迹中获得高频的中间监督信号。
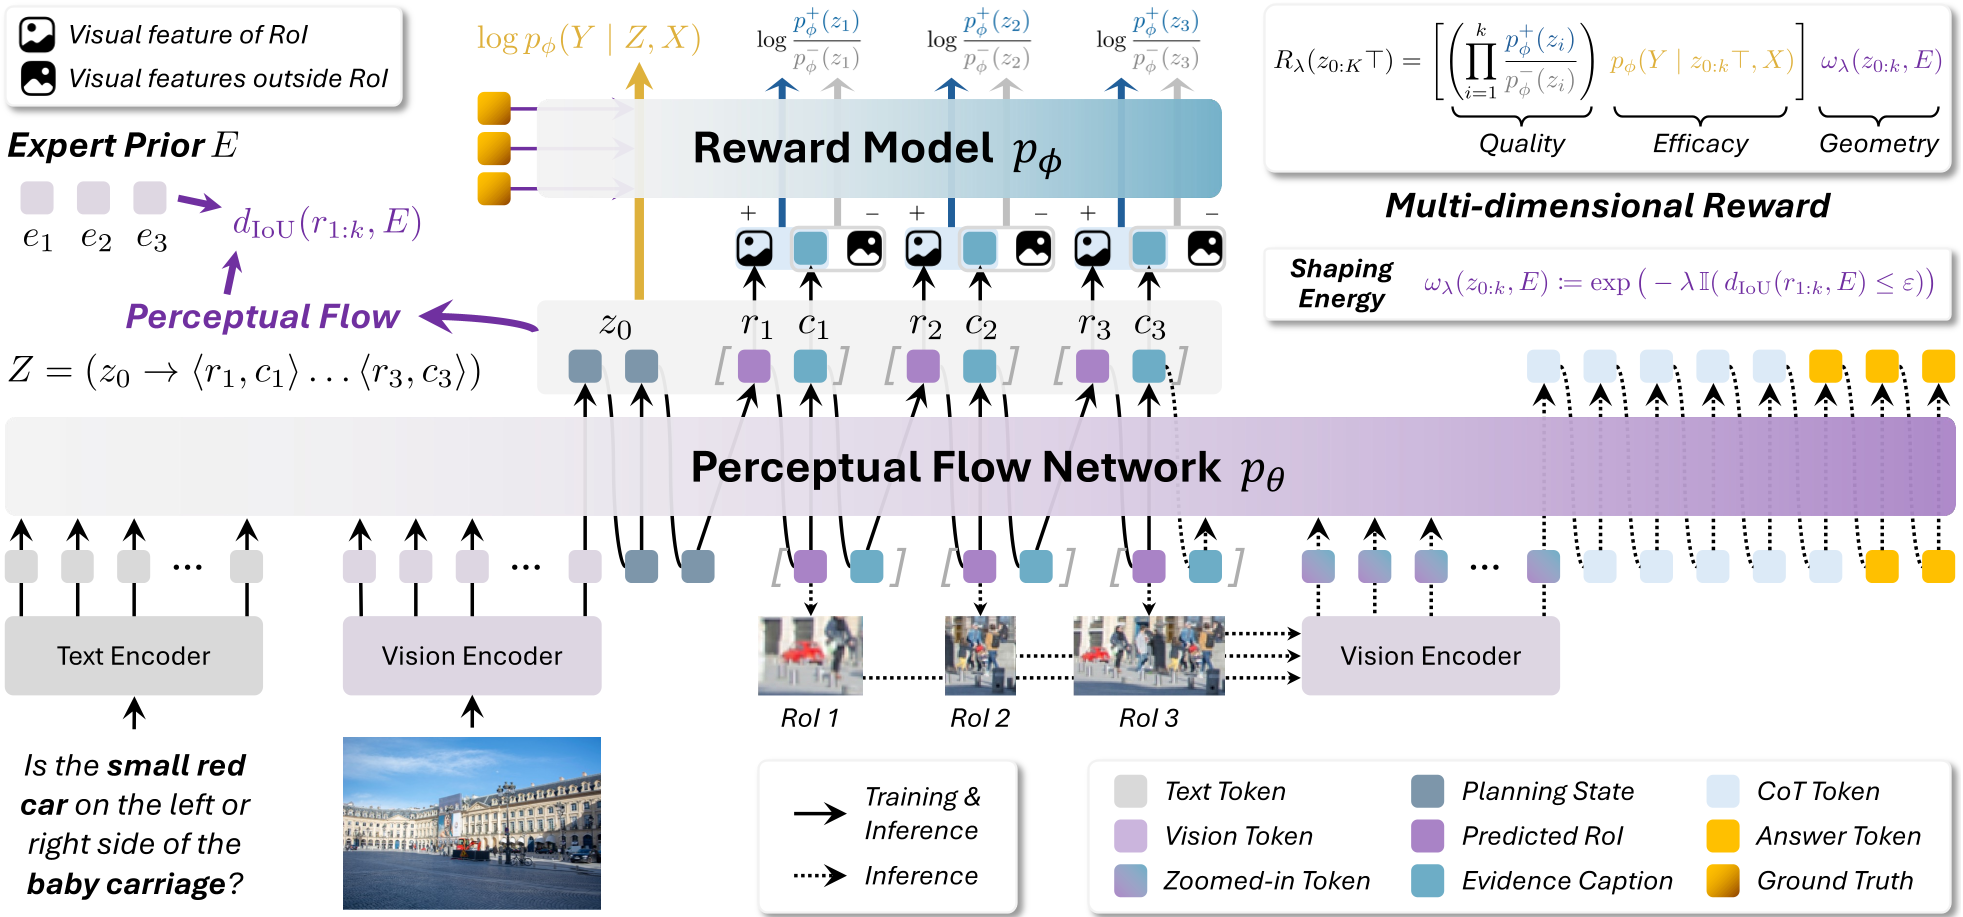 图 2:PFlowNet 的两阶段架构:从感知流采样到自条件推理。
多维奖励设计:
- 质量奖励 (Quality Reward):利用对比项 确保生成的描述与切图内容高度相关。
- 效能奖励 (Efficacy Reward):衡量这一段感知流对最终预测正确答案的真实贡献。
- 几何塑造 (Vicinal Geometric Shaping):不再要求 100% 对齐坐标,只要在专家标注的一定半径 范围内即可,这极大地释放了模型的探索空间。
实验战绩:全线 SOTA
PFlowNet 在多个严苛的基准测试中展现了统治力,特别是在需要精细搜索和复杂推理的任务中:
- V Bench*: 达到 90.6%,远超 Qwen3-VL 8B 原生模型(77.5%)。
- MME-RealWorld-lite: 达到 67.0%,提升幅度高达 18.4%。
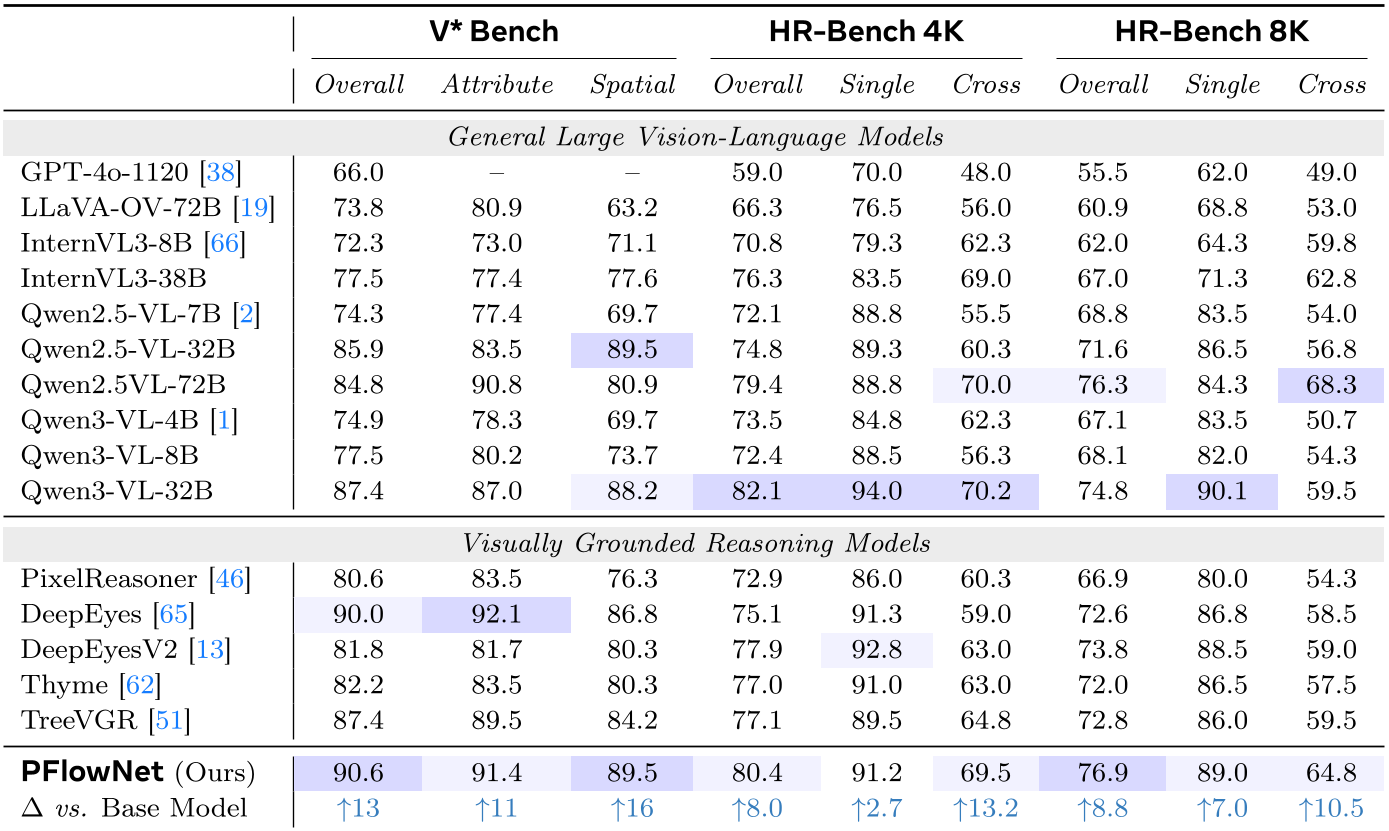 表 1:在细粒度视觉理解上的性能表现。
测试时缩放 (Test-Time Scaling)
与以往的 Grounded RL 不同,PFlowNet 的策略分布非常丰富(多样化)。这意味着在推理时,通过增加采样次数(Pass@k),性能会稳步提升。相比之下,传统的 RL 方法往往会陷入模式崩塌(Mode Collapse),多次采样也无法获得更好的结果。
深度洞察:为什么这很重要?
PFlowNet 的成功揭示了视觉推理的一个关键 Inductive Bias:视觉 grounding 应该服务于推理,而不是服务于坐标检测。
通过将感知轨迹建模为潜变量(Latent Variable),PFlowNet 实际上在模型内部构建了一个“视觉暂存器”。它不仅提高了可解释性——我们可以清晰地看到模型在想什么、在看哪里——还通过这种结构化的中间步骤,成功缓解了 LLM 常见的语言偏见和幻觉问题。
总结
PFlowNet 为 visually grounded reasoning 开辟了新路径。它证明了通过巧妙设计的变分目标和奖励函数,较小规模的模型(8B)也能在复杂推理任务中通过“高质量的思考过程”击败参数量大数倍的通用模型。
局限性:尽管感知流效果显著,但在处理极其简单的视觉问题时,这种四阶段的推理过程可能会带来不必要的计算开销。未来的方向将是如何实现“自适应感知”,根据问题难度动态调整感知流的深度。