
扰动即一切:打破大语言模型的“死记硬背”,实现真正的外推预测
Perturbation is All You Need for Extrapolating Language Models
本文提出了一种基于扰动的自回归语言模型框架,旨在通过在训练和推理阶段引入语义邻域(Semantic Neighbor)变换,显著提升大语言模型(LLM)的推断(Extrapolation)能力。该方法在 OPT、GPT-2 等模型上实现,且在多个 SOTA 基线对比中展现了更强的样本效率和泛化性能。
TL;DR
在高质量训练数据趋于枯竭的背景下,来自布里斯托大学和 LSE 的研究团队发表了这篇题为《Perturbation is All You Need for Extrapolating Language Models》的论文。论文提出:通过在训练和推理环节同步引入语义扰动(Perturbation),可以将 LLM 难以应对的“分布外推断(Extrapolation)”任务巧妙地转化为“分布内插值(Interpolation)”任务,从而显著提升模型在面对陌生 Prompt 时的创作与推理表现。
背景定位:从 Scaling Law 到 Sample Efficiency
虽然 DeepSeek 和 Gemini 等系列模型屡创奇迹,但学术界已开始担忧:当人类生产的文本数据被消耗殆尽后,LLM 的下一步在哪里?此前的 Scaling Laws 指出性能提升依赖于参数量和数据量的指数增长,但本文另辟蹊径,试图通过改进推断能力(Extrapolability)——即模型对训练集未涵盖的上下文生成合理响应的能力——来提升样本效率。
痛点深挖:确定性前缀的“傲慢与偏见”
传统自回归模型(Post-additive noise 范式)的核心公式是 。在这种模式下,模型对前缀 是完全“信任”的。然而,在实际推断中,用户给出的 Prompt 往往是训练数据中从未出现过的点。如果模型过于依赖精确匹配(Deterministic prefix),一旦面对语义微调的变体就会失效。
作者观察到人类认知的一个特点:我们在理解语言时,对同义替换、隐喻或微小的语法变化具有天然的鲁棒性。例如,“满怀爱心”和“有很多爱可以分享”在认知上是等价的。目前的 LLM 缺乏这种逻辑直觉,更多是在进行高维空间的模式检索。
核心方法论:引入前置扰动层级
作者提出了一种“语义邻域”变换机制:
- 扰动设计(T):对原始输入 进行随机插入、同义词替换或删除,生成其上下文邻居 。
- 两步建模:先通过 抽样,再基于扰动后的变量进行预测 。
这种结构在统计学上被称为 Pre-post-additive Noise Model。它最大的学术贡献在于提供了一套关于“外推不确定性”的严谨数学定义,并证明了:只要扰动器(Perturber)选取得当,模型可以将分布外的测试点映射回训练分布的支撑集内,从而实现完美外推。
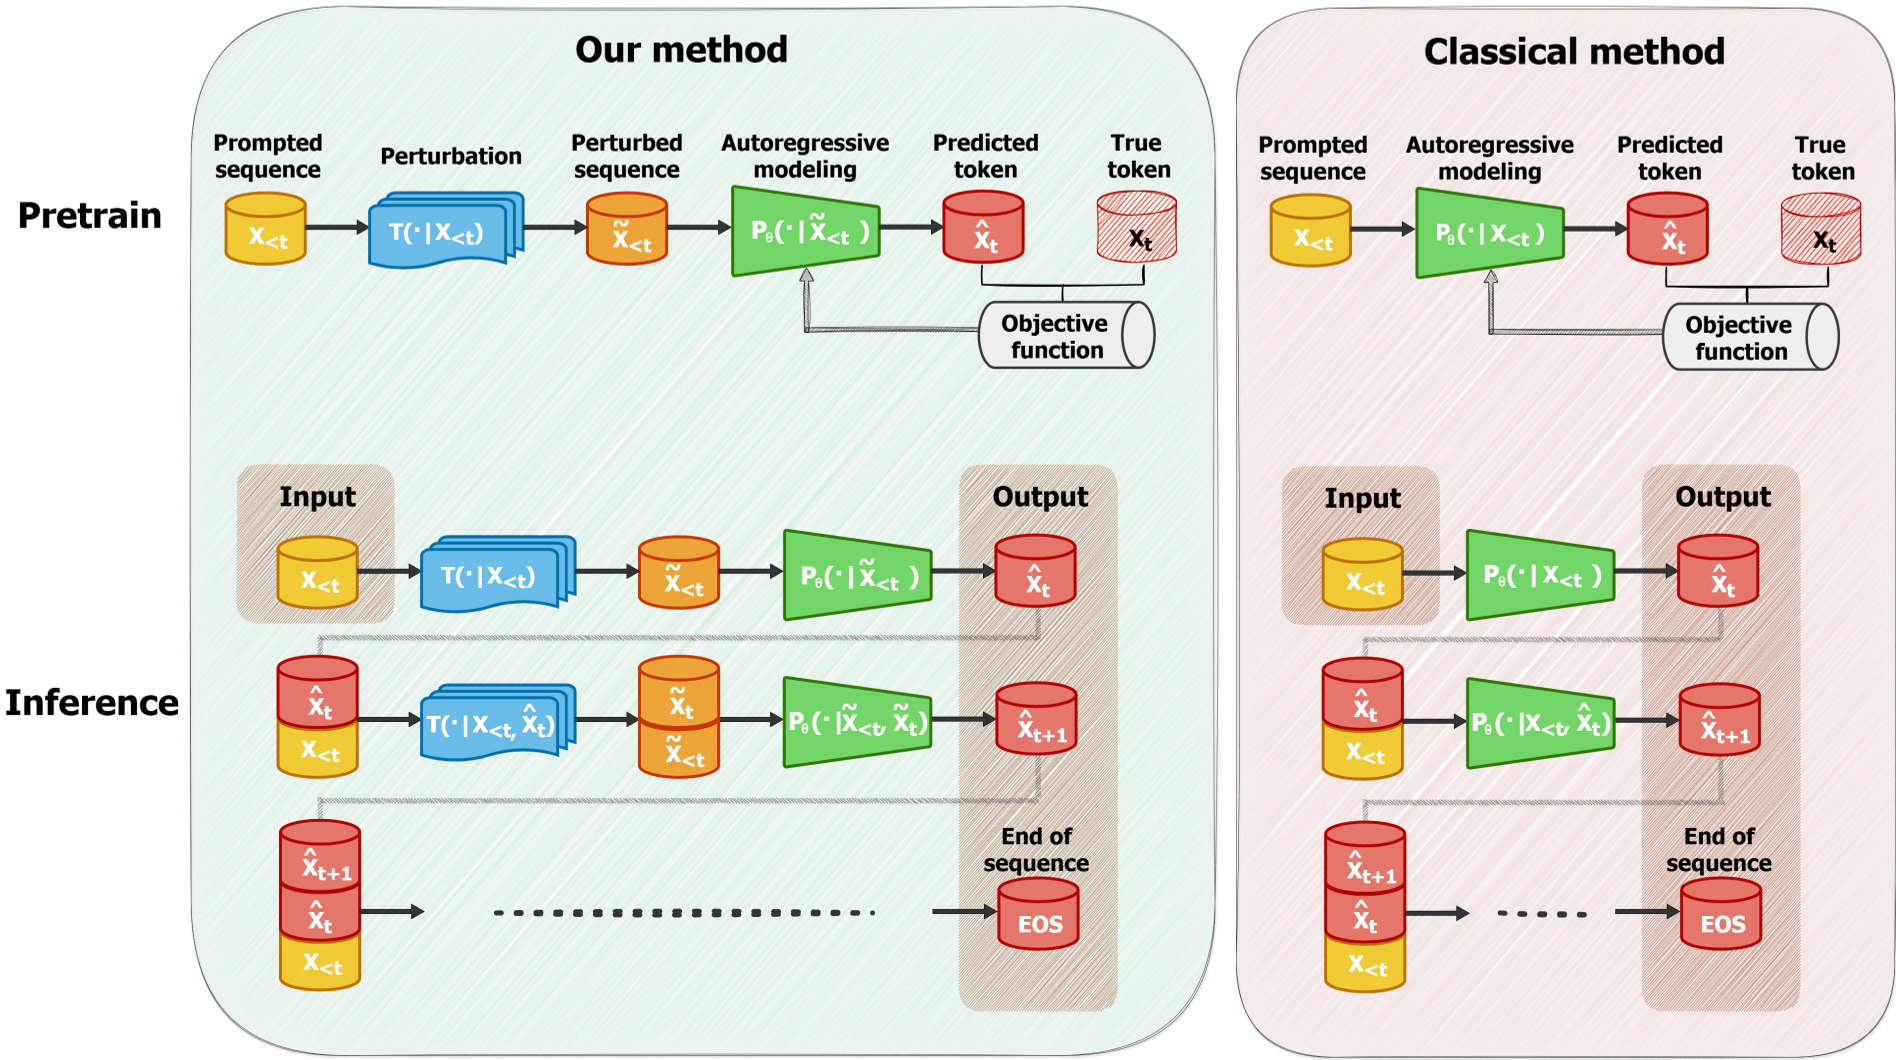 图 1:扰动自回归模型与经典模型的对比。注意扰动不仅发生在训练阶段,更作为推理阶段的固定模块。
实验与结果:全线超越 SOTA
研究人员在 WikiText-2 上训练了 OPT-125M 和 GPT-2,并在 WebText、WritingPrompts 等高度异质化的数据集上测试了泛化能力。
- Mauve 得分大幅提升:在大规模 OOD 数据集上,该方法不仅显著超过了标准的 MLE,还击败了 MixCE 和 EMO 等专门优化损失函数的基线。
- 扰动强度的权衡:实验显示,适度的扰动(强度选在 0.025 左右)能达到最佳的平衡点。过强的扰动会破坏语义,过弱则无法提供足够的泛化性。
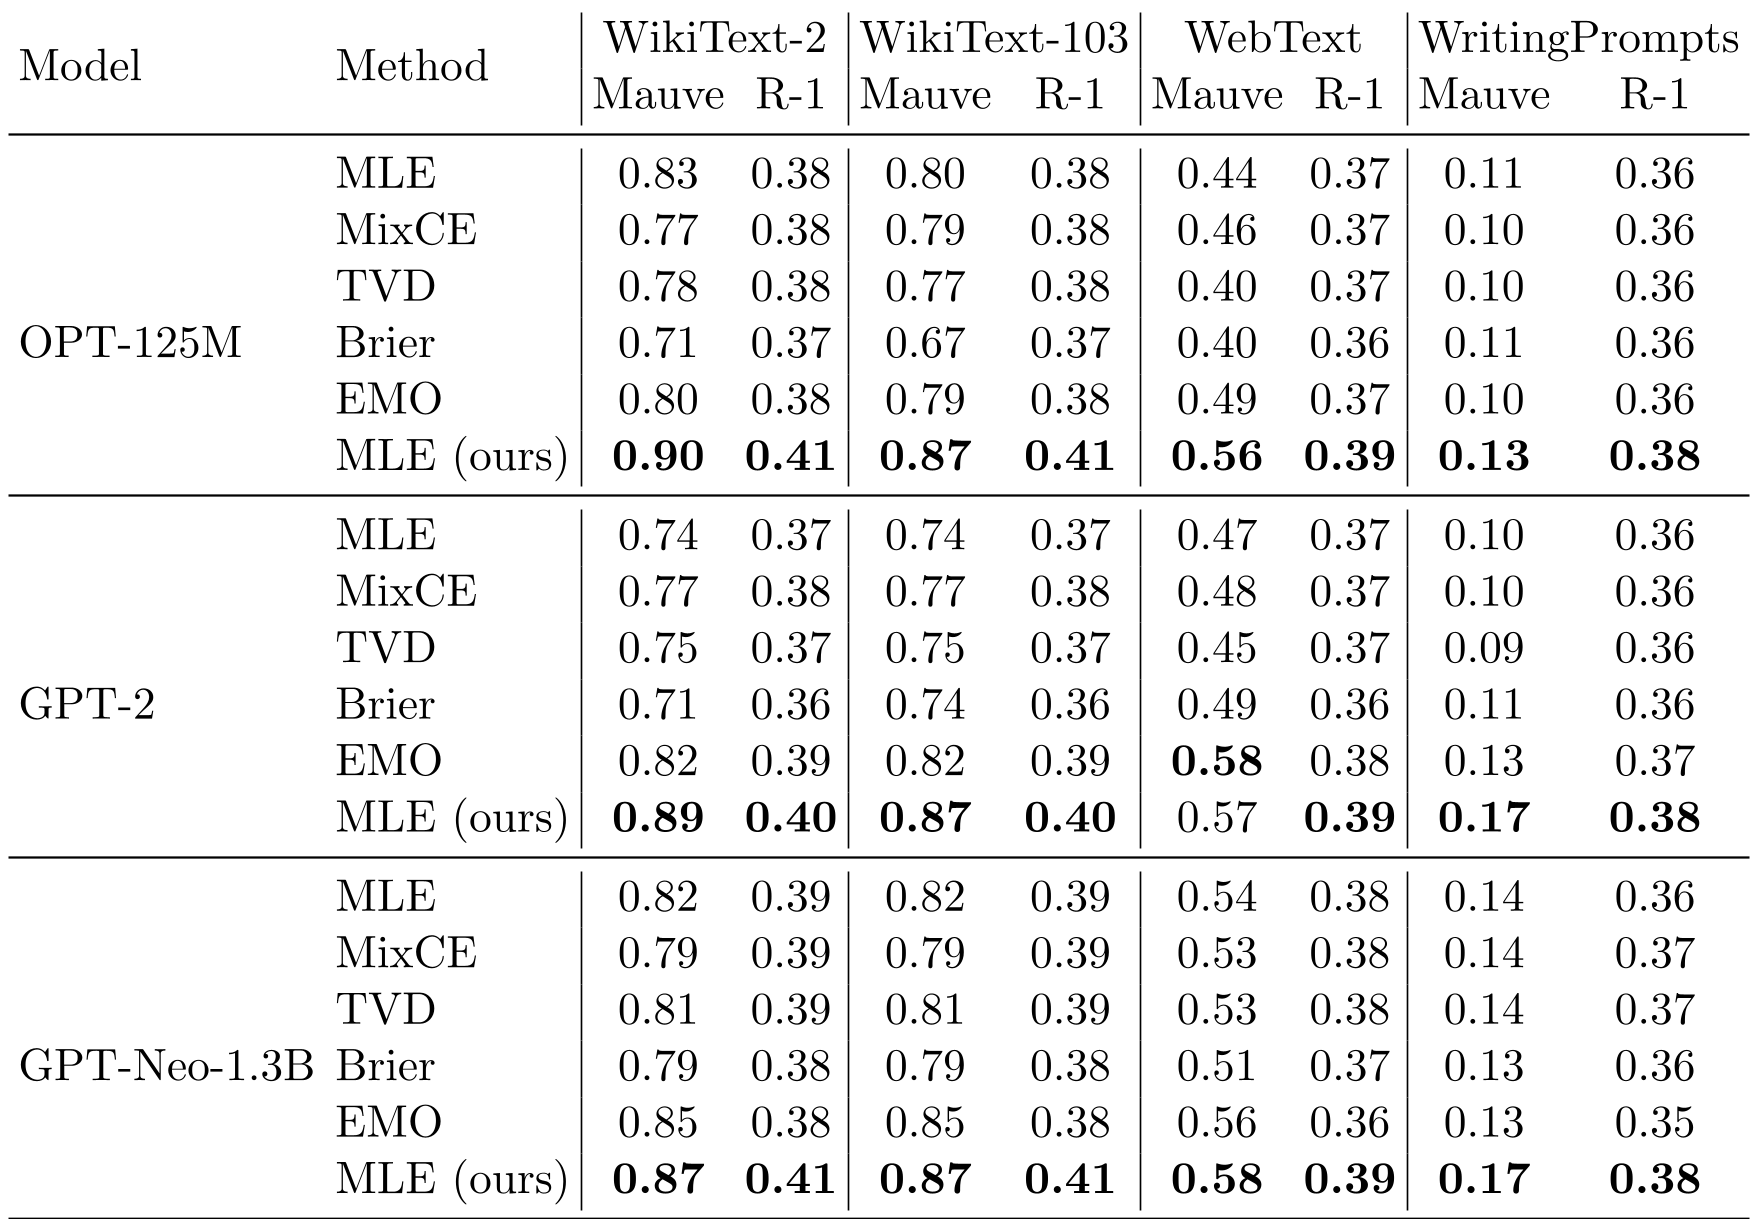 表 1:在多项任务中,该方法(MLE ours)在衡量文本质量的 Mauve 指标上均处于领先地位。
关键发现:推理阶段扰动的不可缺失性
最有趣的发现来自消融研究(Ablation Study)。如果仅在训练时加扰动(类似传统数据增强),性能提升极其微弱;只有在推理时也开启扰动,模型才能真正释放其学到的鲁棒性。这表明,扰动应该被视为模型架构的一部分,而非仅仅是数据预处理。
深度洞察与总结
- 本质提升:该工作的价值在于它不仅是一个 Trick,而是有深厚的分布回归(Distributional Regression)理论支撑。它将“预训练模型对长尾分布的鲁棒性”这一非正式概念,转化为了可证明的“外推不确定性”界限。
- 局限性:目前的扰动方式仍较为初级(逻辑上的 Token 级操作),未来若能引入可学习的、向量空间的语义扰动参数,其潜力将进一步释放。
- 未来展望:这一思路极易扩展至多模态领域。例如在视觉生成中,对输入的上下文(Contextual images)进行隐空间扰动,或许能解决视频生成模型在长时序列中的崩坏问题。
结论: 扰动可能真的就是 LLM 实现从“记忆”到“创造”跨越的那关键一环。