
PivotRL:低成本实现高精度智能体后训练的“杠杆原理”
PivotRL: High Accuracy Agentic Post-Training at Low Compute Cost
本文提出了 PivotRL,一种针对长程智能体(Agentic)任务的高效后训练框架。通过在现有 SFT 轨迹上进行局部的、基于验证器的策略强化学习(RL),该方法在 NVIDIA 的 Nemotron-3-Super-120B 等模型上实现了 SOTA 性能,显著降低了计算成本并缓解了分布外(OOD)退化。
TL;DR
在 AI Agent 的演进中,如何平衡“教它做事”(SFT)和“让它试错”(RL)一直是个难题。NVIDIA 团队发布的 PivotRL 给出了一个优雅的解:它不再进行极其耗时的全轨迹端到端 RL,而是精准定位 SFT 轨迹中的“关键点”(Pivots),通过局部试错和功能性奖励,以 1/4 的计算成本跑赢了端到端 RL,并彻底解决了 SFT 带来的领域外能力退化问题。
痛点深挖:为什么 Agent 训练这么贵且易脆?
当前的 Agent 训练主要有两种路径,但都各带“剧毒”:
- SFT 的局限(Superficial Alignment):模型仅仅是在模仿专家的字符串。一旦环境发生轻微偏移(OOD),模型就不知道如何处理。更糟的是,过度 SFT 常导致模型在数学、代码等通用领域能力断崖式下跌。
- E2E RL 的重负:像 SWE-Bench 这种长程任务,每一轮更新都要进行几十轮的环境交互(Rollout),计算资源消耗极其惊人。
作者通过观察发现,即便把 SFT 轨迹拿去做局部 RL,如果采用随机采样,高达 71% 的训练样本其实是无效的——因为模型在这些状态下要么已经稳赢,要么稳输,无法产生梯度更新信号。
Methodology:PivotRL 的核心直觉
PivotRL 的核心在于两个词:筛选 (Filtering) 与 宽容 (Tolerance)。
1. 寻找“关键点”(Pivots)
并非所有的对话轮次都值得训练。PivotRL 会预先进行离线 Profile,计算每个状态的奖励方差 。
- 直觉:如果一个状态下模型采样的动作结果全好或全坏,其优势函数(Advantage)基本为零。
- 策略:只选择那些让模型表现出“挣扎”和“多样化结果”的状态进行在线 Rollout。这就像老师只纠正学生最容易犹豫不决的错题。
2. 功能等价奖励(Functional Reward)
传统的强化学习常要求输出与专家答案字符串一致,这在 Agent 任务(如 Bash 命令、API 调用)中极不合理。PivotRL 使用领域验证器(Verifier),只要动作逻辑正确(如达成了相同的文件修改效果),就给正向奖励。
理论证明:数学上的优雅
作者提供了严谨的理论证明(Theorem 3.2 & 3.3):
- 梯度信号:证明了 GRPO 更新量直接与奖励的标准差成正比。这为“筛选高方差 Pviots”提供了数理支撑。
- OOD 保留:证明了基于功能奖励的 RL 本质上是 KL 散度约束下的投影,它在提升目标任务概率的同时,能最大限度保留参考模型对无关任务的排序。
实验与结果:降本增效的典范
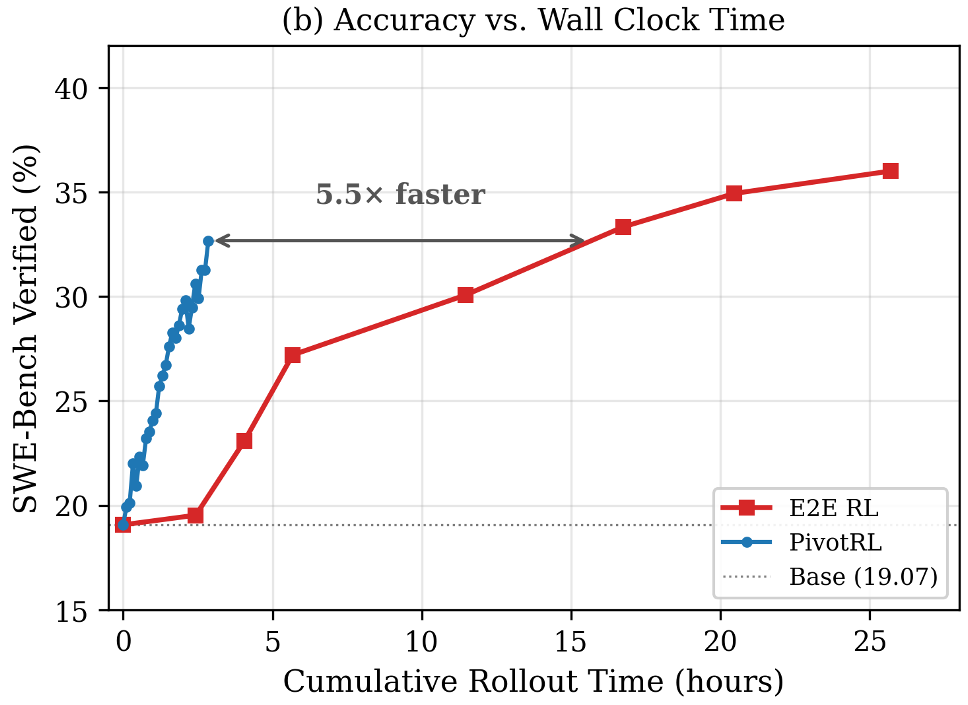
在 SWE-Bench(软件工程金标准)上,PivotRL 展现了惊人的效率:
- 性能:达到与端到端 RL 相当甚至更高的水平(约 32.6% 准确率)。
- 成本:交互轮数减少到 1/4,墙钟时间减少了 5.5 倍。
在 OOD 任务上,SFT 在进行 Terminal 环境训练后,数学成绩(AIME25)从 86 分暴跌至 21 分。而 PivotRL 几乎完全保留了原始能力,得分依然维持在 82 分以上。
深度洞察与总结
Takeaway: PivotRL 标志着 Agent 训练从“暴力交互”向“精准干预”的转变。它利用了 SFT 提供的优质状态空间,通过局部强化解决了探索效率低下的问题。
局限性:该方法高度依赖于高质量的验证器(Verifier)。对于那些难以定义“功能等价”的任务(如主观创作类 Agent),可能需要引入 LLM-as-a-Judge 或过程奖励模型(PRM)来替代硬核验证器。
未来展望:这种“基于方差采样”的思路极具普适性,未来可能成为所有长程推理模型(Reasoning Models)后训练的标准配置。