
像素到 Token:VLA 模型中隐动作监督的系统综述
From Pixels to Tokens: A Systematic Study of Latent Action Supervision for Vision-Language-Action Models
本文对视觉-语言-动作(VLA)模型中的隐动作(Latent Action)监督策略进行了系统性研究,提出了基于图像(Image-based)和基于动作(Action-based)的两种监督视角,并对比了四种集成策略。研究表明,直接预测离散隐动作 Token 能显著提升模型在长程推理和复杂电机控制任务中的性能,在 LIBERO 和 RoboTwin 等基准测试中达到了 SOTA 水平。
TL;DR
在具身智能(Embodied AI)飞速发展的今天,Vision-Language-Action (VLA) 模型如 Google 的 RT 系列、OpenVLA 等已成为通用机器人策略的标准范式。然而,面对数据来源极其混杂的现状,如何有效地监督这些模型?本文系统地探讨了 Latent Action (隐动作) 的监督艺术。研究发现:不要让模型直接去猜坐标值,而是让它先去预测离散的隐动作 Token,这一简单的改变能让模型在复杂任务中的成功率最高提升 17.5%。
痛点深挖:异质数据的“巴别塔”
当前 VLA 训练面临的最大挑战是数据的异质性 (Heterogeneous)。不同机器人平台的自由度不同,甚至人类视频完全没有动作标注。如果直接训练预测连续坐标(Continuous Action),模型会陷入语义失配的泥潭。
虽然业界已经开始尝试使用隐动作作为“中间语言”,但做法五花八门:有的是作为辅助损失,有的是作为生成的预览图。作者通过这篇论文,为这片混乱的领域建立了“统一坐标系”。
核心洞察:两种视角,四种策略
作者将 Latent Action 的应用统一为两个互补的逻辑:
- 轨迹正则化 (Regularizing the Trajectory):这是一种“前向映射”,把隐动作看作高层视觉规划(Visual Plans),告诉 VLM 应该往哪走。
- 目标空间统一 (Unifying the Target Space):这是一种“逆向映射”,把复杂的连续动作压缩进 VLM 原生的 Token 空间,让动作预测像写文章一样简单。
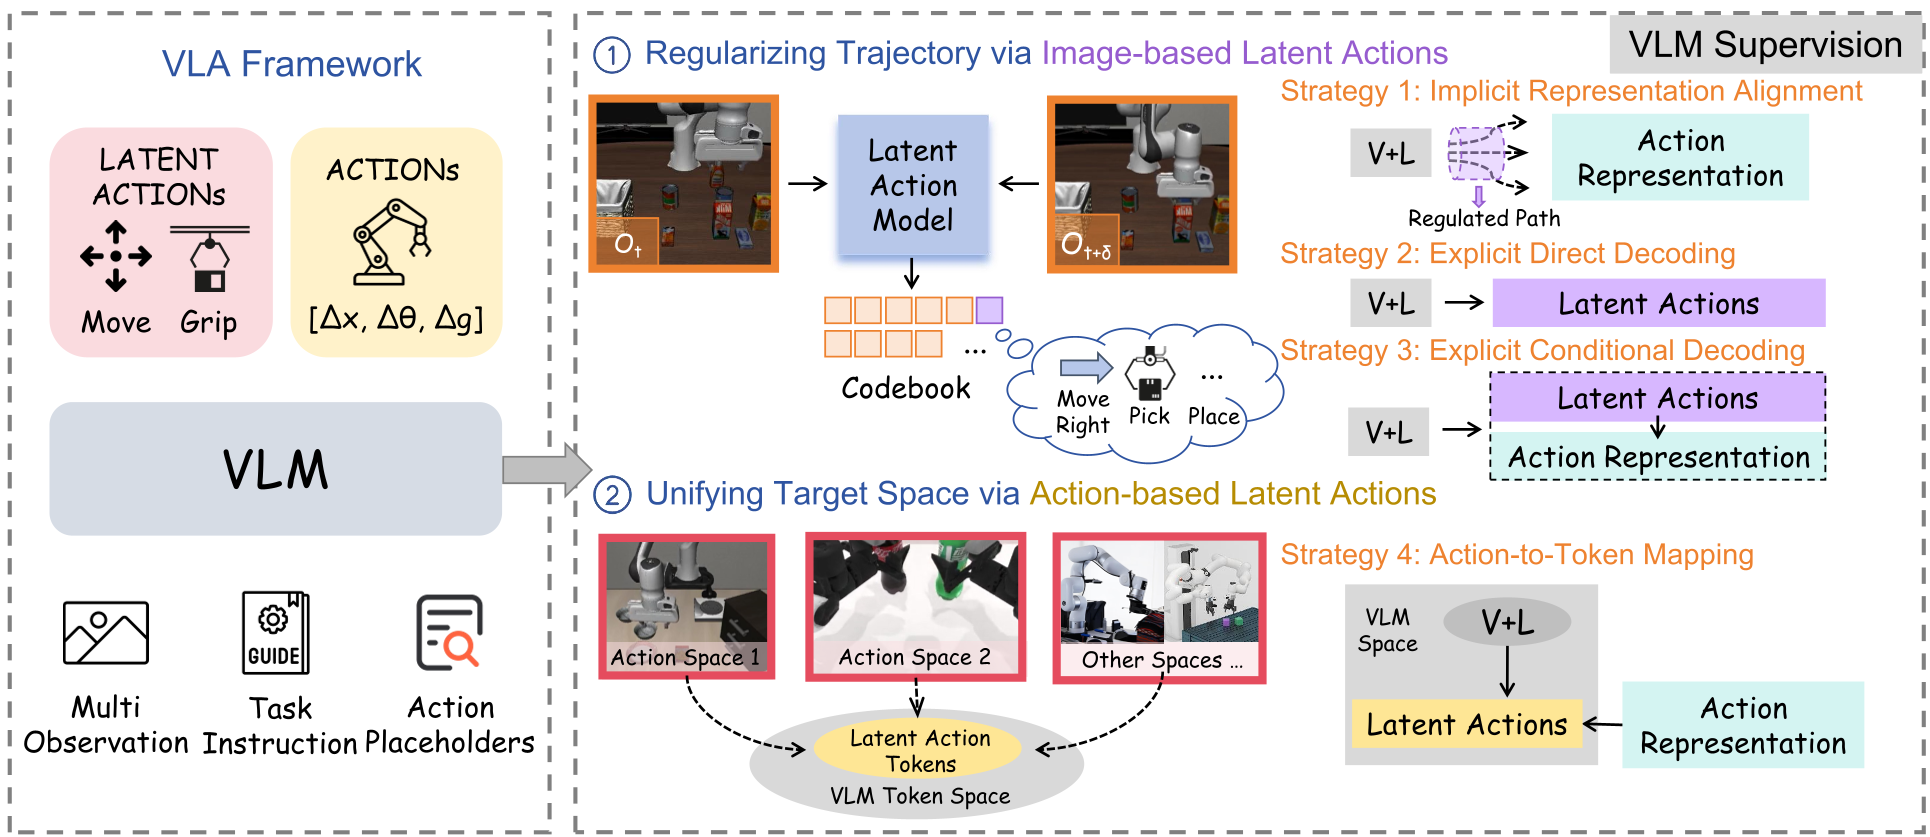
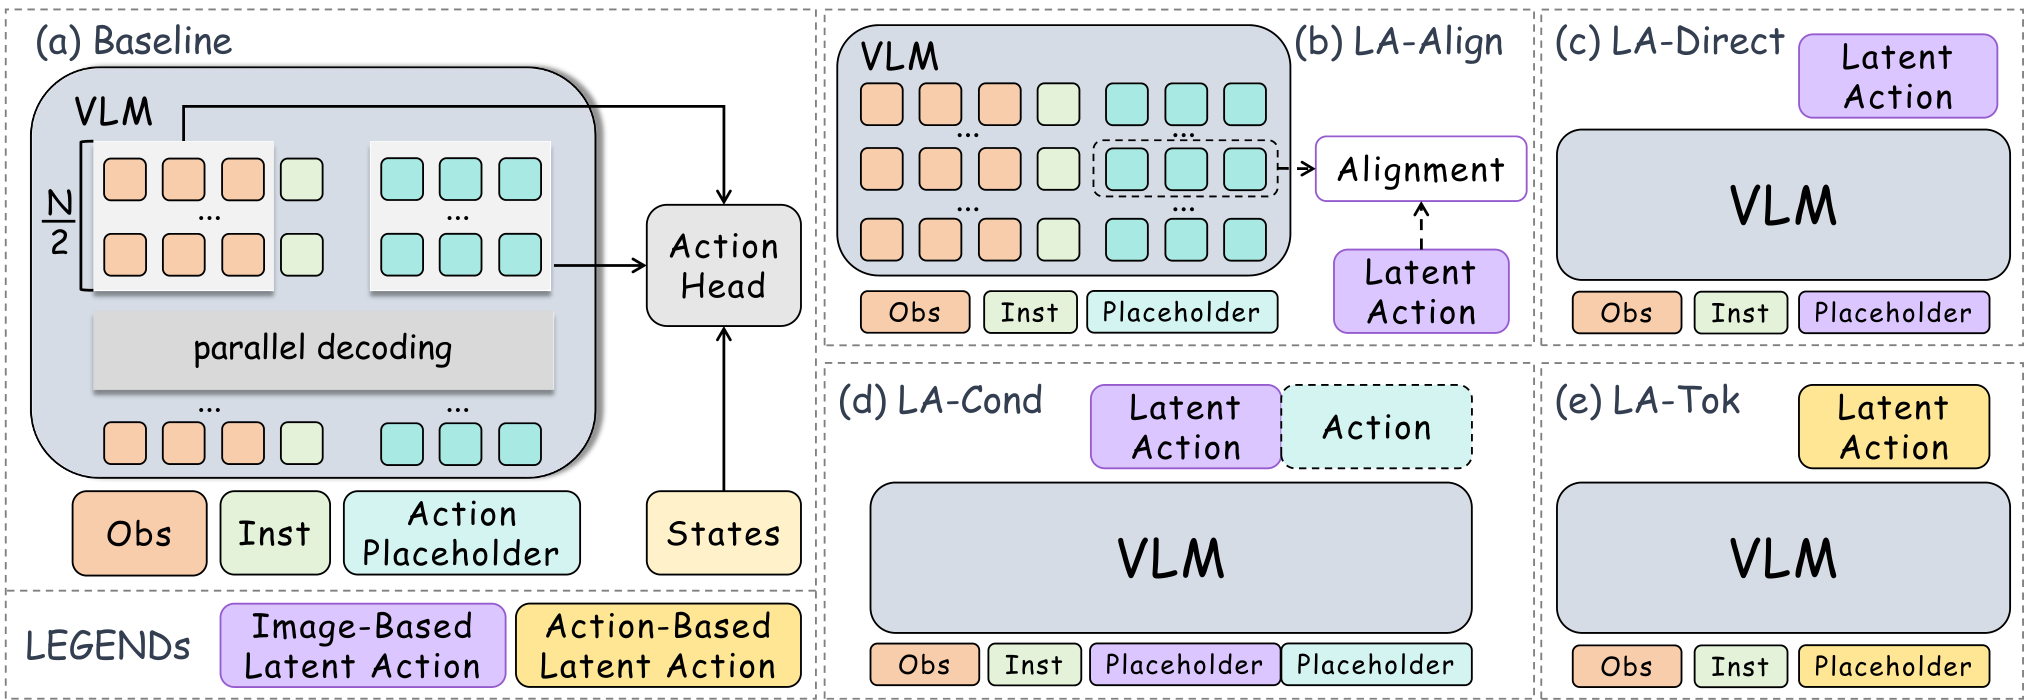
基于此,作者在 Qwen-VL 基础上实现了四种集成方案(LA-Align, LA-Direct, LA-Cond, LA-Tok),并发现了一个及其关键的**“形式-任务对应关系”**。
实验揭秘:谁才是最强监督?
1. 不同任务,不同配方
- 长程推理(Long-horizon):在 LIBERO-Long 实验中,图像基隐动作表现抢眼。因为它通过视觉状态转移(Visual State Transition)为模型提供了全局视野。
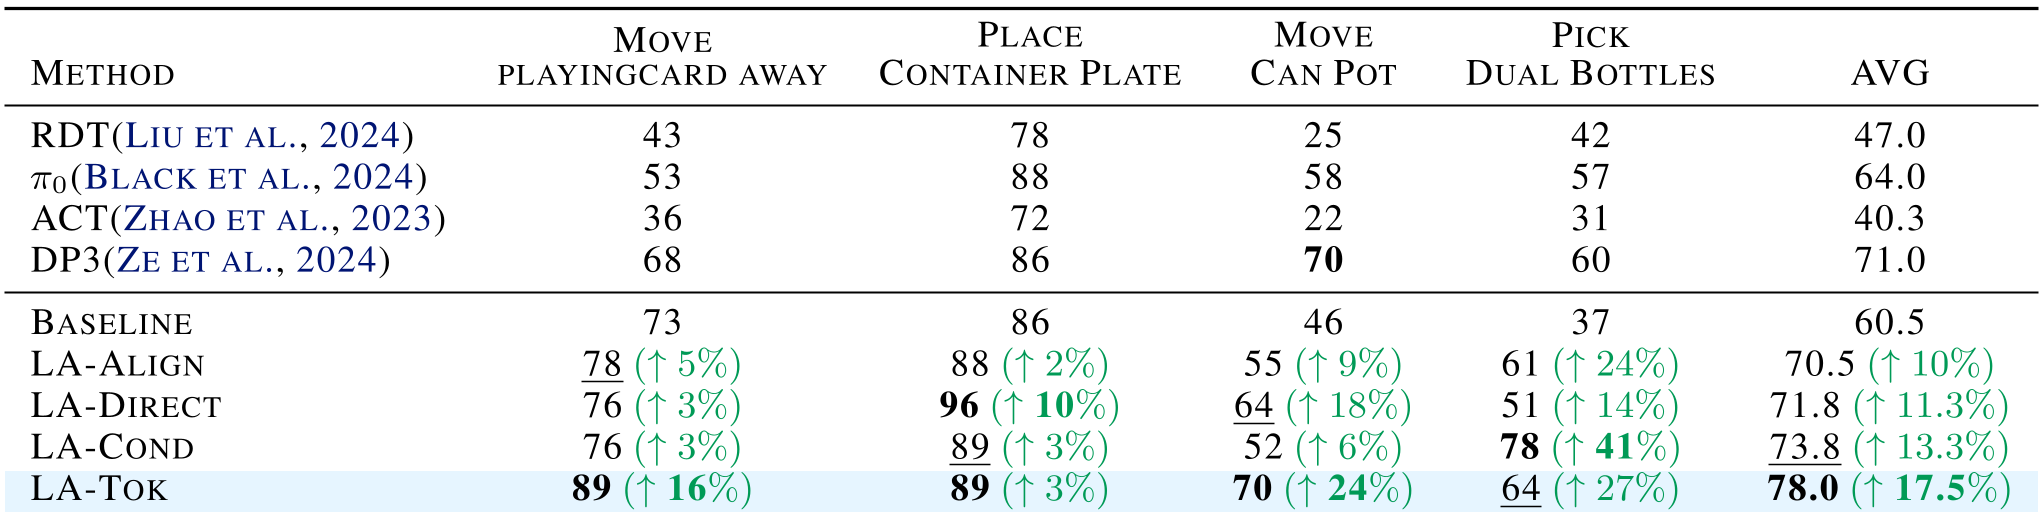
- 复杂电机控制(Motorically Complex):在涉及到双臂协同的 RoboTwin 实验室中,**动作基隐动作(LA-Tok)**一骑绝尘。通过将频率域和时域特征结合,它捕捉到了动作的精细抖动。
2. 离散 Token 完胜连续回归
这是一个反直觉但深刻的结论:在 VLM 内部,使用 Cross-Entropy 损失去预测离散 Token,总是比使用 MSE 损失去回归一个连续向量效果更好(在基准测试中平均高出 2% 以上)。这表明 VLM 更擅长处理分类任务,而分类任务的离散瓶颈(Bottleneck)起到了正则化作用,过滤了动作中的噪声。
3. 加入隐动作后的“抗干扰”能力
在 10 个任务的联合训练中,普通的 Baseline 往往会出现“拆东墙补西墙”的负迁移现象。但引入 LA-Cond 策略后,所有任务的成功率均单调提升。这说明隐动作为异质数据集提供了统一的建模范式,降低了学习冲突。
深度分析:未来 VLA 该怎么训?
本文不仅是实验报告,其实是一份实战避坑指南:
- 如果你希望机器人更“聪明”(懂规划):选 LA-Direct,让模型预测未来的隐视觉特征。
- 如果你希望机器人更“灵活”(懂协调):选 LA-Tok,把动作揉碎成 Token。
- 不要盲目增加 Placeholder 长度:实验证明,单纯增加 Token 长度而不引入 Latent 监督,性能几乎没有提升。
总结与局限
作者建立了一个极其纯净的对比实验环境,隔离了参数量、主干网络带来的干扰。虽然目前实验还局限于单臂机器人,但这套理论框架对于未来构建更庞大的通用具身智能(Generalist Robotics)模型具有重要的启发意义。正如论文标题所言:从像素到 Token 的跨越,可能正是填补“看懂”与“做到”之间鸿沟的关键。