
PolicyGapper:利用大模型揭开 Google Play 隐私披露的不一致黑匣
PolicyGapper: Automated Detection of Inconsistencies Between Google Play Data Safety Sections and Privacy Policies Using LLMs
本文提出了 PolicyGapper,这是一种基于多 Prompt 大语言模型(LLM)流水线的自动化审计框架,旨在检测 Android 应用的隐私政策(PP)与 Google Play 数据安全栏目(DSS)之间披露的不一致性。通过在大规模真实数据集上的验证,该方法实现了跨文档的自动化隐私合规性检查。
TL;DR
隐私合规不仅是代码层面的安全,更是声明层面的诚信。本文介绍的 PolicyGapper 是首个基于 LLM 的自动化审计工具,专门用于捕获 Android 应用“隐私政策(PP)”与“数据安全栏目(DSS)”之间的罗生门。在对 330 款主流应用的扫描中,它抓到了 2,689 处瞒报、漏报行为,平均 F1-score 达 0.76。
背景定位:隐私披露的“语义断层”
自 2022 年 Google 强制要求 DSS 以来,用户可以通过简单的图表了解应用收集了什么。但问题在于:谁来保证这些图表是真的?
传统方法通常对比“代码行为 vs 声明”,但忽略了法律风险的源头——隐私政策文本。如果 PP 里写了收集位置信息,但 DSS 标签上画了勾选“未收集”,这就构成了严重的透明度欺诈。手动对比这两者需要极高的法律背景和时间成本,这正是 PolicyGapper 发挥作用的坐标。
痛点深挖:为什么不仅仅是简单的关键词匹配?
隐私政策充满法律术语和条件子句。例如,开发者可能会写:“出于技术支持目的,我们可能会暂存您的 IP 地址”,但在 DSS 中却选择不申报。根据 Google 复杂的豁免规则(如:加密传输、端到端加密、匿名处理),有些数据是可以豁免申报的。
传统的自然语言处理(NLP)难以处理这种复杂的逻辑推断,导致高误报和低召回。
方法论详解:多 Prompt 推理流水线
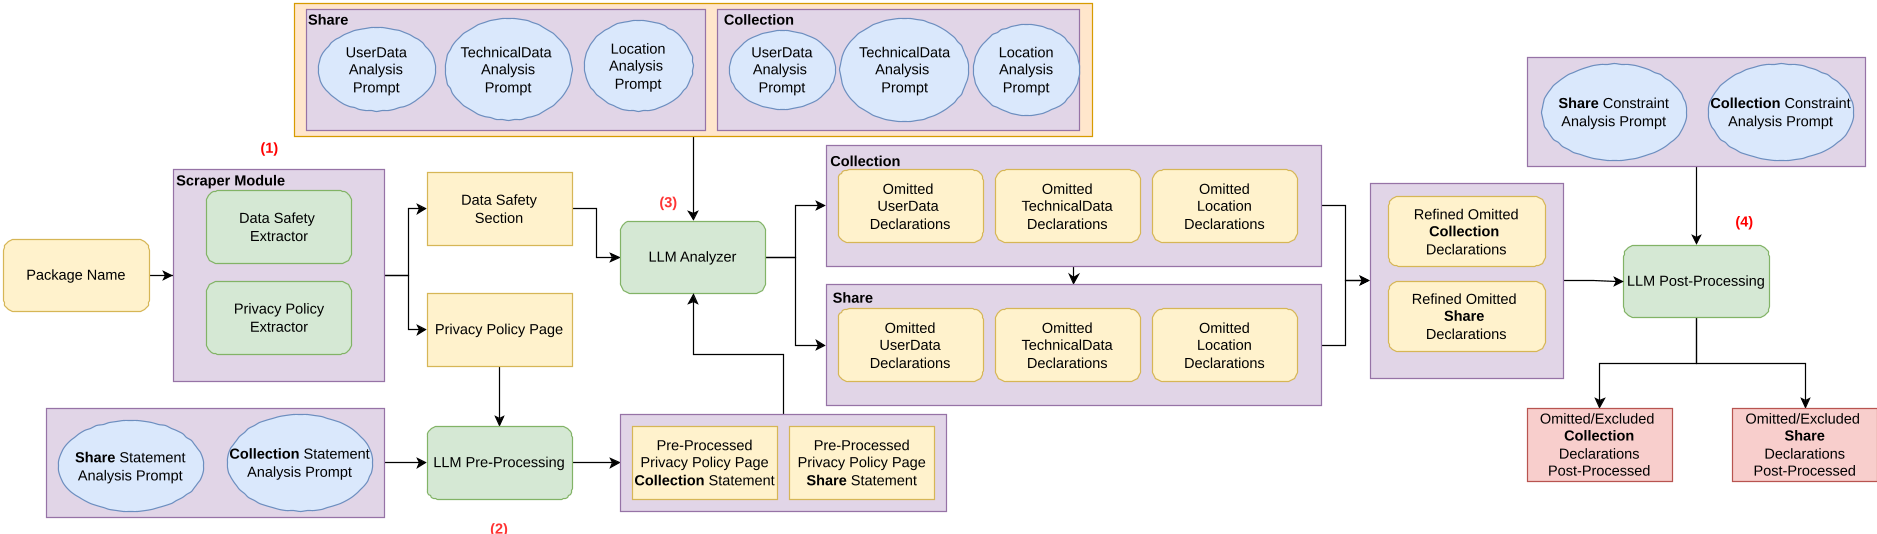
PolicyGapper 并没有尝试毕其功于一役,而是采用了多级流水线架构:
- 数据抓取与预处理:针对 PDF 格式的隐私政策进行视觉感知级的文本提取,保留文档的布局和层级。
- 语义分析模块:
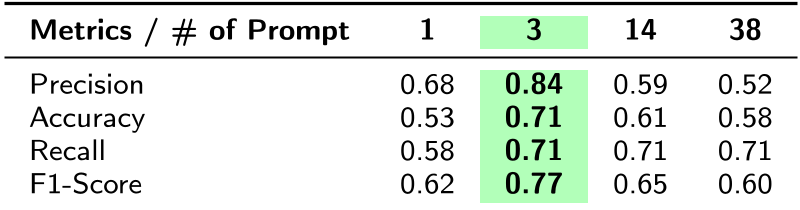
- 架构直觉:研究者发现,将 38 种数据类型一次性塞给模型会导致注意力分散。PolicyGapper 采用了 3-Prompt 策略(将数据分为设备数据、用户数据、生成内容三组),在覆盖率与精确度之间取得了最佳平衡。
- 后处理与过滤:这是系统的“守门人”。它根据 Google 的官方规范,重审模型生成的候选漏报项,剔除因“本地处理”或“端到端加密”而产生的伪漏洞,大幅减少了 LLM 的常见幻觉问题。
实验与结果:揭示合规现状
关键发现
- 瞒报率惊人:超过 95% 的受检应用存在至少一项披露缺失。
- 重灾区数据:
- 模糊位置 (Approximate Location):很多应用在 PP 中写了收集 IP 地址,但忘记了 IP 意味着模糊位置,因而在 DSS 中漏报。
- 网页浏览记录 (Web Browsing History):第三方内嵌浏览器(WebView)产生的行为极易被开发者忽略。
- 用户支付信息 (User Payment Info):涉及 115 处漏报,具有极高的隐私敏感性。
性能看板
研究对比了多种模型(Qwen3, DeepSeek, Gemini),发现 Gemini 2.5 Pro 凭借其对原生 PDF 文件的视觉理解能力和长上下文支持,在指标上全面性压倒了通过 PyPDF2 解析出的纯文本输入。
深度洞察与总结
Takeaway
- 开发者工具化:PolicyGapper 不仅是监管工具,更是开发者的辅助工具包。它能帮助开发团队在提交应用前进行自我审查,避免因文档不一致导致的下架风险。
- LLM 的新赛道:该研究证明,在垂直领域的合规审计中,Zero-shot Prompting + 细颗粒度约束过滤 的表现已优于传统的有监督微调模型。
局限性与展望
尽管精度尚可,但对于一些跨平台的“通用隐私政策”(既管网站又管 App),PolicyGapper 偶尔会产生误判。此外,对于那些把隐私政策链接直接设为失效或重定向到 2017 年旧网页的应用,自动化审计依然面临“垃圾输入,垃圾输出”的挑战。
行业启示
隐私保护正从“能不能做”向“说明白了没有”演进。PolicyGapper 代表了监管科技(RegTech)的新方向:自动化语义审计将成为应用商店的标配。
作者总结:这项工作实现了学术上的“Open Science”承诺,完整复现包及数据集已在 GitHub 开源。