
PortraitDirector:层次化解耦策略,开启实时高精度面部重演新范式
PortraitDirector: A Hierarchical Disentanglement Framework for Controllable and Real-time Facial Reenactment
本文提出了 PortraitDirector,一种基于层次化解耦框架的实时面部重演(Facial Reenactment)模型。该方法通过将面部运动分解为空间层(姿态与区域运动)和语义层(情感),实现了高保真且精细可控的角色动画,成功在单块 RTX 5090 上实现 512x512 分辨率下 20 FPS 的实时推理。
TL;DR
面部重演(Facial Reenactment)的核心挑战在于如何让“身份”、“姿态”、“表情”和“情绪”各司其职且互不干扰。PortraitDirector 给出了目前最优雅的解法:它不再将面部运动看作一个整体信号,而是通过层次化运动解耦与合成策略,将面部拆解为空间层与语义层。最惊艳的是,它能通过“情感过滤模块”彻底洗掉驱动视频中的情绪偏见,并实现了 512 分辨率下的 20 FPS 实时表现。
背景定位
在学术坐标系中,PortraitDirector 属于基于扩散模型(Diffusion-based)的控制生成研究。相比于之前依赖 3D 关键点(如 LivePortrait)或全隐藏空间编码(如 XPortrait2)的方法,它更强调物理意义上的强解耦,是追求极端可控场景下的 SOTA 级工作。
痛点深挖:为何“形似”容易“神似”难?
现有方法通常面临两个瓶颈:
- 特征纠缠(Entanglement):当你只想让角色张嘴时,驱动视频里那个人的“悲伤”情绪往往会随之“泄露”到生成结果中。
- 尺度敏感(Scale Sensitivity):如果驱动视频的人脸很大,生成的角色往往会发生形变,这是因为姿态与面部特征在编码阶段就混在了一起。
核心逻辑:从“驱动”转变为“组合”
PortraitDirector 的核心直觉是:面部动画应该是不同维度信号的“化学合成”,而非“物理搬运”。
1. 空间与语义的层次化拆解
- 空间层 (Spatial Layer):通过图像裁剪(ROI)直接隔离眼睛和嘴部。此时的运动是“冷冰冰”的物理位移。
- 语义层 (Semantic Layer):通过对运动潜矢量的临时池化(Temporal Pooling)提取全局情感,过滤掉高频的细微动作。
2. 情感过滤模块 (EFM)
这是本文的“杀手锏”。作者引入了基于**信息瓶颈(Information Bottleneck)**原理的自动编码器。
- 分析阶段:强制运动特征通过一个低容量通道,逼迫模型丢弃复杂的情感信息,只保留最基本的运动骨架。
- 合成阶段:将“洗净”后的运动与目标情感通过 Cross-Attention 重新融合。
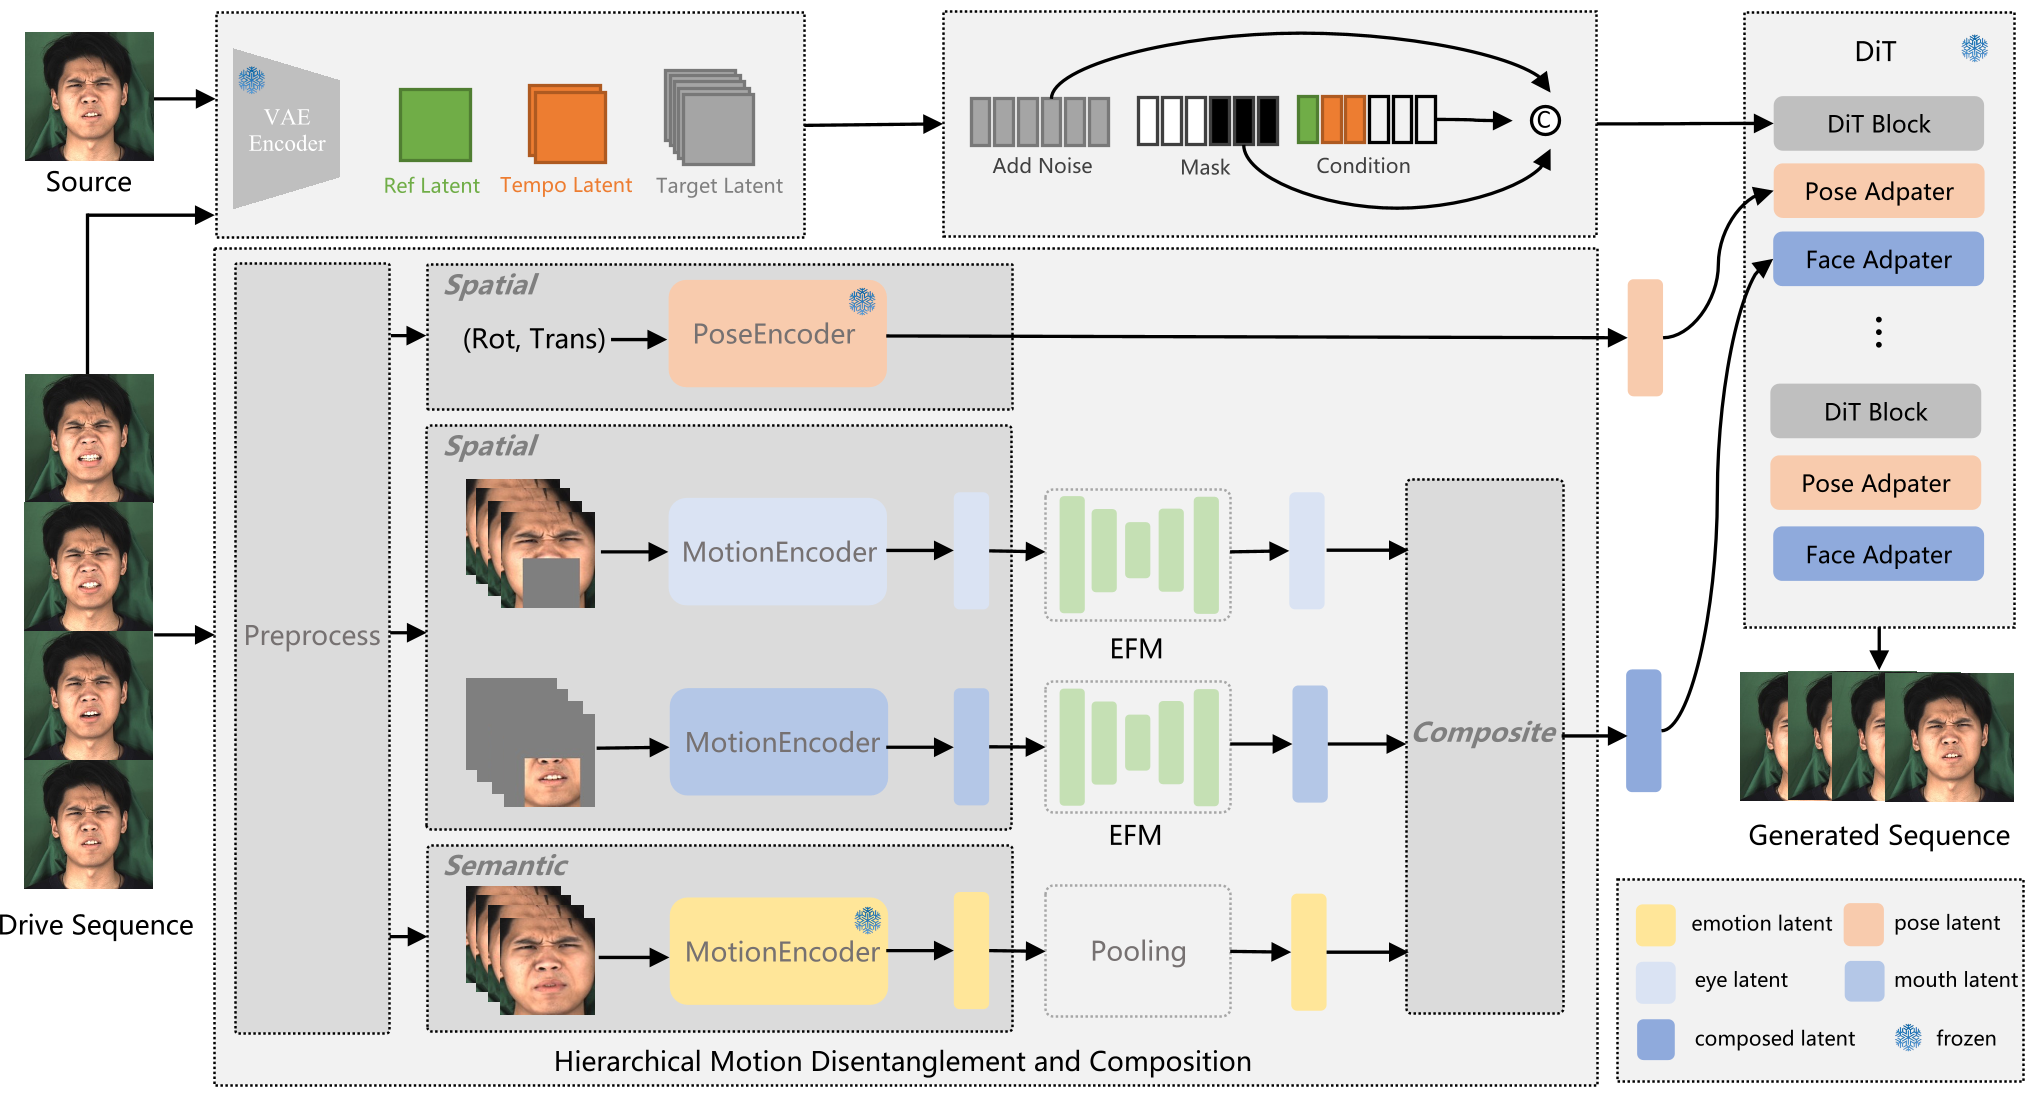 图 2:总体框架展示了从驱动序列到空间/语义层分解,再到 DiT 主干注入的全过程。
实验与结果:快且准
在实验部分,PortraitDirector 展现了极强的统治力。
- 控制精度:如表 2 所示,在姿态(Pose)和嘴部运动(Mouth)的控制误差上,显著低于 EDTalk 和 PDFGC 等基线。
- 鲁棒性验证:消融实验证明,如果不使用独立的 PoseAdapter,模型会出现严重的尺度纠缠(如图 5 所示,角色头部大小会随驱动视频剧烈变动)。而 PortraitDirector 则能保持完美的身形比例。
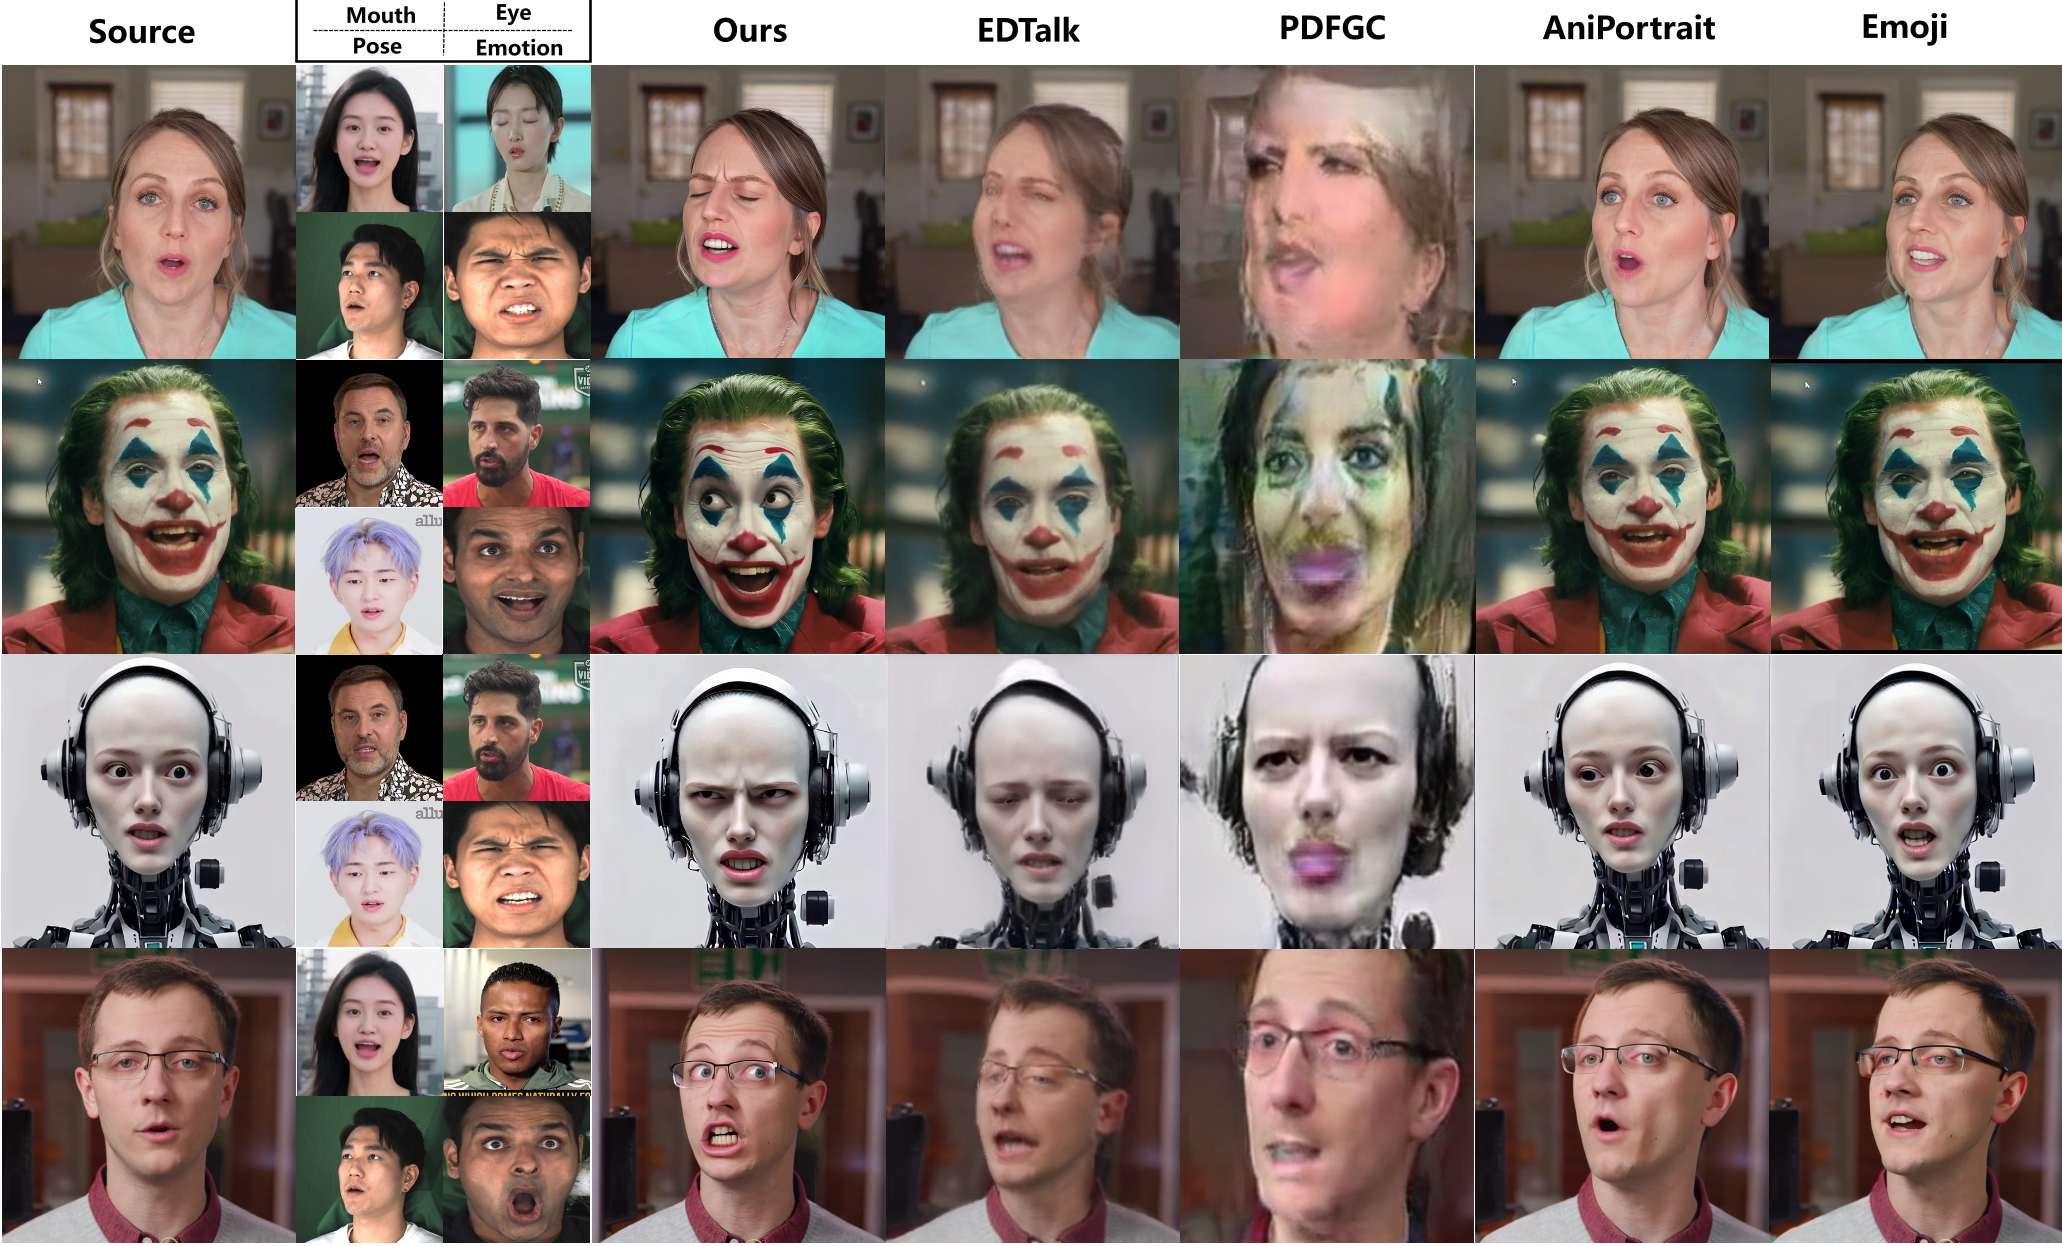 图 4:定性对比显示,PortraitDirector 在不同驱动信号下(眼睛、嘴巴单独控制)的表现远比对比方法更清晰、自然。
实时性的秘诀
为了达到 20 FPS,团队做了三项关键优化:
- DMD 蒸馏:将扩散模型的采样步数从 20 步压缩到 4 步。
- 因果注意力 (Causal Attention):适配流式推理,配合 KV Cache 消除处理长序列时的冗余。
- VAE 加速:重新设计了轻量级 VAE 解码器,参数量仅为原始版本的 1/4,但推理速度提升 4 倍。
深度洞察与总结
Takeaway:PortraitDirector 成功的关键在于它承认了面部特征的异质性。 以往我们试图用一个巨大的隐藏空间解决一切,而 PortraitDirector 告诉我们:物理运动该剪裁就剪裁,姿态信号该独立就独立。
局限性:尽管做到了实时和高保真,但对于极端的遮挡场景(如手部遮挡面部)或是极其复杂的发丝动态,模型仍有提升空间。此外,目前的 800ms 延迟对于极致的实时互动(如 VR 会话)仍有一点压力。
未来展望:这种“分层-过滤-再重组”的思路极具工程落地价值,未来很可能成为虚拟主播、实时视频通话增强等产品的底层核心架构。