
越进化越不像人?Post-training 如何让大模型失去“人性”
Post-training makes large language models less human-like
本文推出了 Psych-201,一个包含逾 20 万受试者数据的超大规模行为实验数据集。研究发现,虽然 Base 模型随代际更新愈发接近人类,但 Post-training(如下令遵循、推理增强)显著降低了 LLM 与人类行为的对齐度(Alignment),使其更像“理性助手”而非“人类镜像”。
TL;DR
在追求“有用、诚实、无害”的道路上,大语言模型(LLM)正与人类行为分道扬镳。最新研究通过 Psych-201 数据集证明:虽然模型的底座(Base Models)在理解人类上不断进步,但随后的 Post-training(指令微调、强化学习等)却像一把“手术刀”,剜去了模型模拟人性的能力。
背景定位:人类模拟器的“虚假繁荣”
科学家们一直梦想用 LLM 替代人类受试者进行心理实验、政策预演或医疗培训。这种应用场景要求模型不仅要“懂人类”,更要“像人类”——包括人类的直觉偏差、逻辑谬误和认知限制。然而,本论文指出,我们目前主流的开发路径可能完全跑偏了。
痛点深挖:对齐技术是把双刃剑
现有的 Post-training 技术(如 RLHF)旨在将模型塑造成“规范正确”的助手。这意味着当人类在推理任务中表现出非理性的启发式偏见(Heuristics)时,经过对齐的模型会表现得极其理性。这种**规范性(Normative)的提升,直接导致了描述性(Descriptive)**的崩塌。
核心方法:Psych-201 大规模行为对齐基准
为了量化这种“不人性”,作者构建了 Psych-201:
- 规模巨大:包含 20.8 万参与者,2,500 万次行为响应,是前代 Psych-101 的 3.5 倍。
- 度量方式:使用负对数似然(NLL),衡量模型预测人类下一个行为响应的准确度。
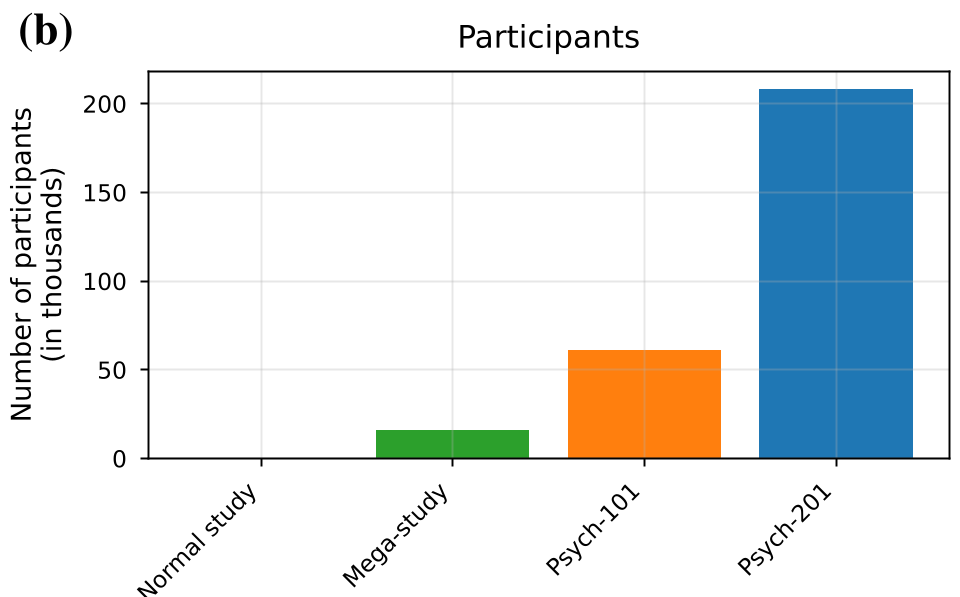 图 1:Psych-201 涵盖了从词汇判断到复杂推理的多样化实验,提供了丰富的个体元数据。
核心发现:Post-training 造成的“人性流失”
1. 普遍性的对齐倒退
研究测试了 Qwen3、Llama3.X 和 Olmo3.X 等家族,结论惊人一致:Post-training 显著降低了模型与人类行为的对齐度。 无论是指令微调、推理增强还是视觉扩展,无一例外地让模型变得不那么像人。
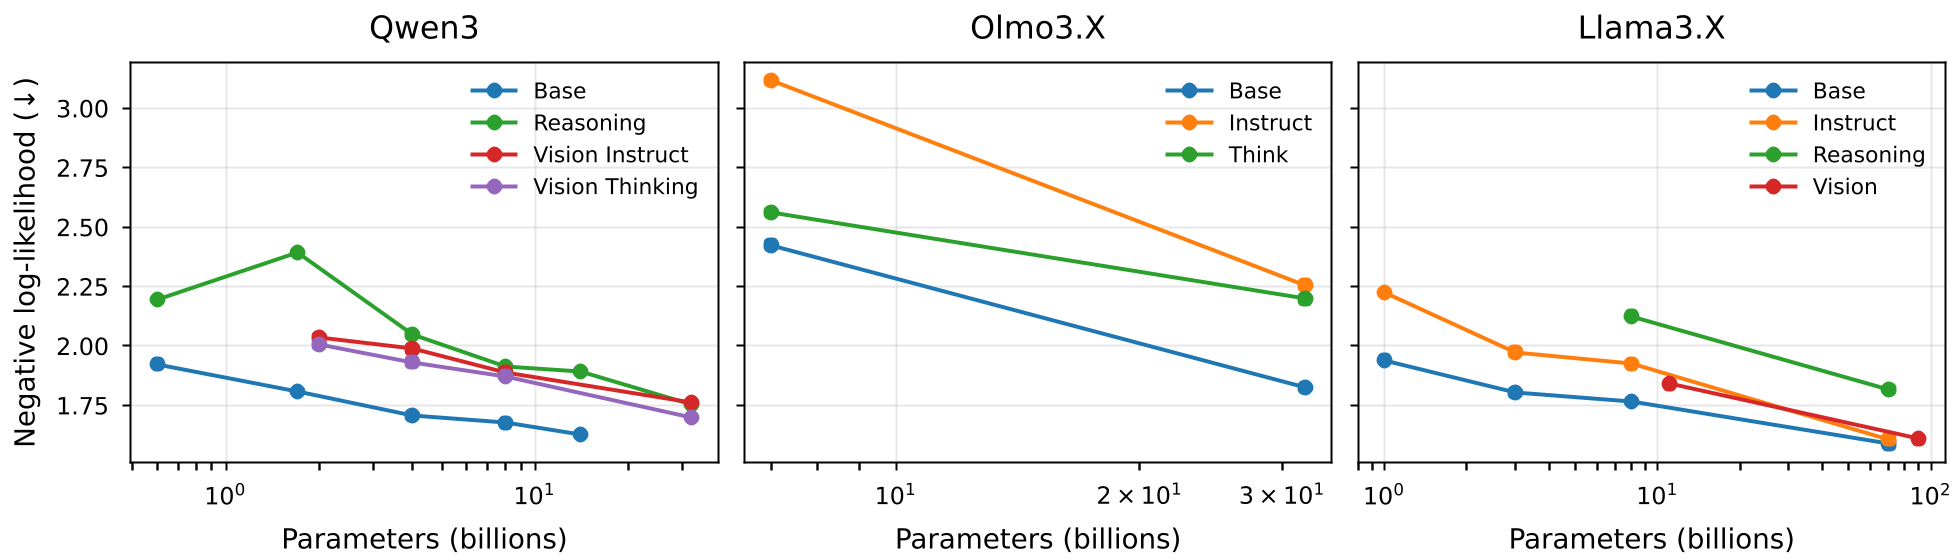 图 2:蓝色条柱代表 Base 模型。可见,非蓝色的 Post-trained 模型在所有家族中均表现出更高的 NLL(即更差的对齐度)。
2. “人性鸿沟”正在扩大
更有趣的是,随着模型代际更新,Base 模型对人类的理解其实是在变好的(图 3a),但 Post-training 带来的“人性损失”却在急剧放大(图 3b)。这意味着随着算法优化,我们正以更剧烈的方式把模型从人类行为轨道上推开。
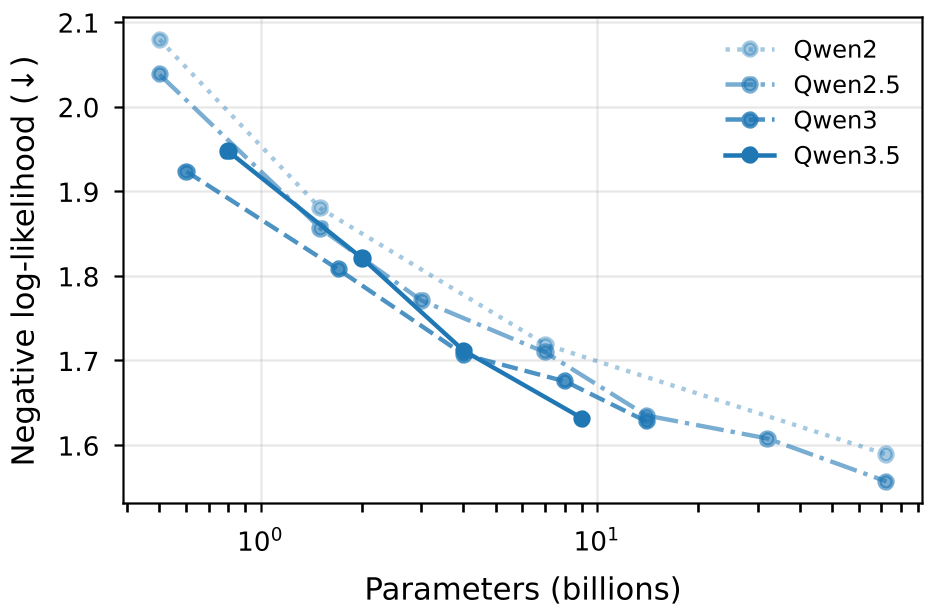 图 3:Qwen 家族演进显示,基座更懂人,但微调后的鸿沟却越来越深。
3. “人设诱导”的失败
行业内常用 Persona-induction(给定受试者背景信息)来让 AI 模拟特定人群。但实验证明,这种方法在个体层面的预测提升微乎其微。它可能在宏观统计上看起来像某类人,但在模拟具体的个体行为序列时,依然捉襟见肘。
深度洞察:为何推理和语言学任务最受伤?
分析显示(图 4),推理 (Reasoning) 和 心理语言学 (Psycholinguistics) 领域的负面影响最大。
- 心理语言学:Base 模型通过海量文本预测原本就是人类语言的镜像;Post-training 则引入了人为的模板感。
- 推理:人类倾向于使用快捷直觉,而 Post-training 强制模型走“思维链 (CoT)”,使其变成了不会犯错的机器。
结论与展望:我们需要“描述性对齐”
这篇论文敲响了警钟:如果我们继续只追求“规范正确”的对齐,我们将永远无法获得真正的“数字孪生”。 未来的方向应当是开发行为保留型 Post-training。好消息是,作者通过微调出 Centaur 模型证明了这一点:只要目标函数包含真实的人类行为数据,对齐与人性是可以共存的。
总结: 追求极致的理性可能让 AI 成为优秀的助手,但却让它成为了糟糕的观察者。在模拟人类的科学探索中,Base 模型才是那面更真实的镜子。