
PrefixGuard:告别昂贵的 LLM 判别器,实现 Agent 故障的高效在线监控
PrefixGuard: From LLM-Agent Traces to Online Failure-Warning Monitors
本文提出了 PrefixGuard,一个用于 LLM Agent 的在线故障监测框架。通过 StepView 离线诱导模块将异构轨迹转换为结构化记录,并利用监督学习训练轻量级监测器,在 WebArena、τ2-Bench 等多个基准上实现了 SOTA 故障预警性能。
TL;DR
随着 LLM Agent 开始处理长程、复杂的工具调用任务,如何在故障发生前及时“吹哨”成为了安全部署的关键。本文提出的 PrefixGuard 放弃了高成本的实时 LLM 判别,通过离线学习 Agent 轨迹特征,构建了高效的在线监测器,不仅在性能上超越了常规基线,还提供了可审计的 DFA(确定性有限状态自动机)模型。
背景定位:Agent 监控的“三大难”
在自动化软件工程、网络安全或金融管理等高风险领域,LLM Agent 的一次错误操作可能导致不可逆损失。然而,目前的监控手段面临挑战:
- 异构性:不同平台的轨迹格式迥异(浏览器 CSS 选择器 vs 命令行字符串)。
- 脆弱性:手动编写监控规则(Runtime Verification)难以应对 LLM 输出的随机性。
- 昂贵感:每一步都调用 GPT-4 进行“实时审判”在经济和延迟上都不可接受。
核心动机:从轨迹中寻找“故障前兆”
作者的直觉是:失败的 Agent 轨迹在其“夭折”前往往伴随着明显的病态特征(如死循环、无效重试、异常状态)。如果我们能将这些原始轨迹转化为一种“结构化符号流”,就能利用轻量级的序列模型(如 GRU 或 Transformer)甚至符号化模型(DFA)来进行极低延迟的风险评估。
方法论详解:PrefixGuard 的三层进化
PrefixGuard 的核心在于如何优雅地处理“脏数据”并将其转化为“预警信号”。
1. StepView:结构化适配器的离线诱导
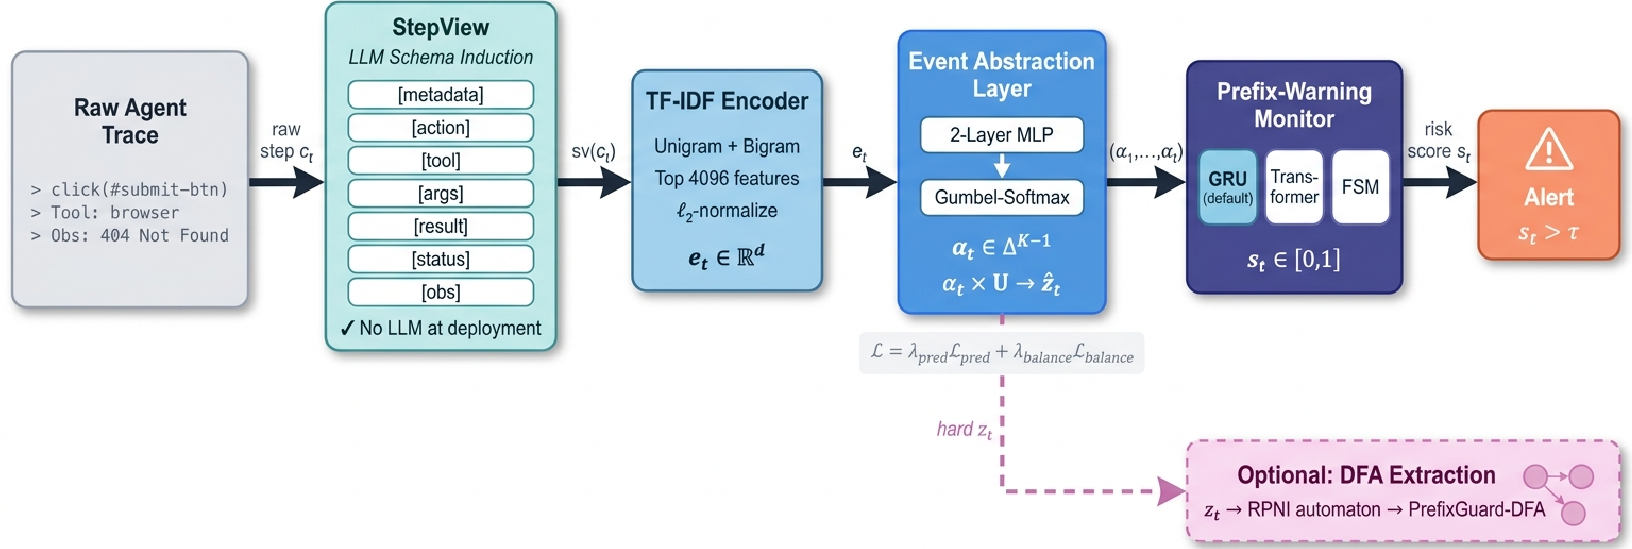
作者发明了 StepView,其巧妙之处在于:仅在离线阶段调用一次 LLM,让其针对特定基准的 12 条典型轨迹编写一个解析器(Adapter)。这个解析器会将原始轨迹映射为统一的 Metadata, Action, Result, Status 等字段。一旦生成,解析器就是确定的代码,在线部署时零 LLM 开销。
2. Differentiable Event Abstraction:让公式说话
为了支持后续的符号化审计,模型引入了一个可微抽象层。利用 Gumbel-Softmax 技巧,将连续的 TF-IDF 嵌入向量映射到 个潜在符号中。这一步实现了从“模糊语义”到“离散状态”的跃迁。
3. 多样化的监测后端
PrefixGuard 提供了四种后端:
- PrefixGuard-GRU(默认):平衡了速度与时序建模能力。
- PrefixGuard-Transformer:利用全局注意力捕捉长程依赖。
- PrefixGuard-DFA:将学习到的符号表编译成有限状态机,方便人类审计模型到底在看什么。
实验与结果:不仅是 AUPRC 的刷榜
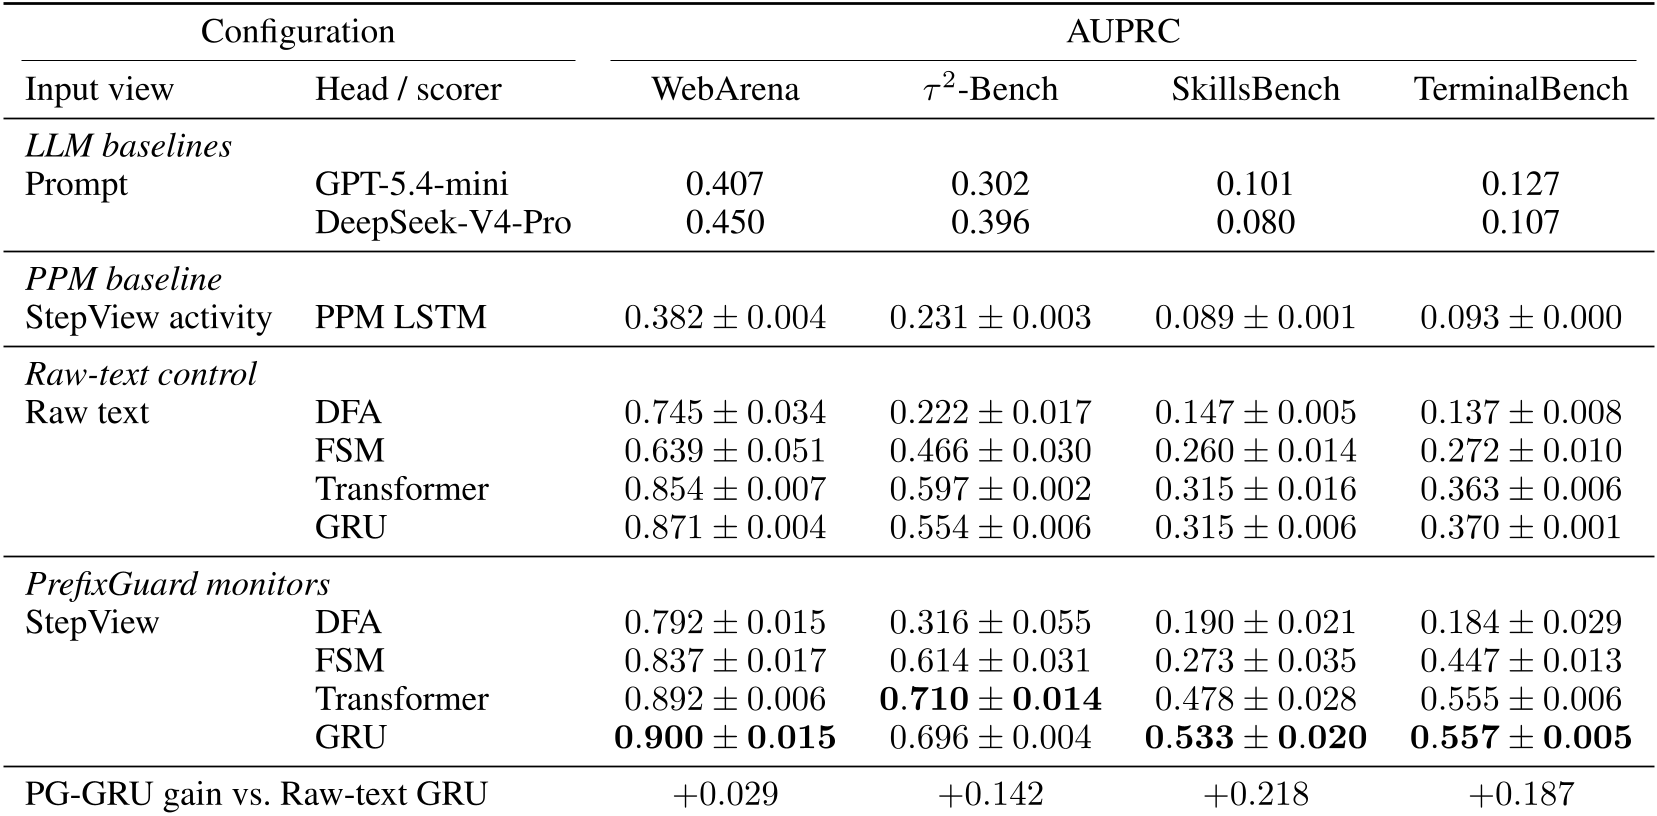
PrefixGuard 在 WebArena, τ2-Bench 等四大 benchmark 上进行了严苛测试。
- 性能制霸:在所有任务中,PrefixGuard 的表现均显著优于直接处理 Raw-text 的模型。在 WebArena 上,其 AUPRC 达到了惊人的 0.900。
- DFAs 审计:研究发现,像 WebArena 这样任务逻辑清晰的场景,仅需 29 个状态的 DFA 就能实现极佳的监控效果;而在复杂的 TerminalBench 中,DFA 状态数激增至 187 个,这揭示了复杂任务对可解释性监控的天然挑战。
深度洞察:排名好不代表真的好
本文最深刻的见解在于 RQ4 (Deployment Utility)。作者指出,高的 AUPRC 并不一定意味着模型可用于干预。
- 在 WebArena 中,虽然 AUPRC 高,但预警通常发生在故障发生的瞬间(接近窗口末端),属于“临终诊断”,留给干预的时间极短。
- 而在 τ2-Bench 和 TerminalBench 中,虽然原始分值略低,但模型能更早地发出警报,为人工或自动干预保留了宝贵的“提前量”(Lead Time)。
总结与局限
PrefixGuard 成功的关键在于通过 StepView 解决了异构 Agent 数据的接入标准问题。它证明了高效监控不需要昂贵的在线推理,而需要精准的特征归一化。 局限性:目前的模型依然依赖于“前缀中必须存在可见证据”。如果 Agent 的错误逻辑高度隐蔽(Hidden Failure),单纯依赖轨迹观测的监测器依然会面临“能力天花板”。
未来,将这种监测器与强化学习中的 Fallback 策略结合,或许能真正实现 LLM Agent 的“零故障”运行。