
规模法则的边界:当高质量数据耗尽,我们该如何挥霍算力?
Prescriptive Scaling Laws for Data Constrained Training
本文提出了针对数据受限(Data-constrained)场景的“指令性缩放法则(Prescriptive Scaling Laws)”,核心方法是为 Chinchilla Law 引入了一个加性过拟合惩罚项(Additive Overfitting Penalty)。该法则在处理重复数据训练时性能显著优于 Muennighoff 等人的现有 SOTA 模型,能精准预测过拟合导致的损失回升。
TL;DR
康奈尔大学的最新研究指出,经典的 Chinchilla Scaling Law 在数据受限时会失效。作者提出了一种包含加性过拟合惩罚(Additive Overfitting Penalty)的新缩放法则。核心结论:在固定数据量下,过度的 Epoch 重复是极其低效甚至有害的,此时应将算力花在增大模型参数而非增加训练步数上。
核心速览:数据荒下的新常态
在 AI 领域,算力的增长速度远超高质量数据的产出速度。当研究人员开始对同一份数据进行 10 轮甚至 64 轮的“反复咀嚼”时,传统的 Scaling Law 无法解释为什么 Loss 在某些时刻会不降反升。
本文在学术坐标系中属于对 Chinchilla 范式的修正与重构。它不仅在描述性上(Fit)更准,更具备“指令性(Prescriptive)”——它能直接告诉大模型开发者:在你的数据预算下,训练到第几个 Epoch 就该停手,转而把模型做大。
痛点深挖:旧法则的“色盲”问题
现有的主流方法(如 Muennighoff 等人的模型)试图通过计算“有效数据量(Effective Data)”来修正 Chinchilla Law。其逻辑是:第二次看到同一个 Token 的价值只有第一次的 0.7 倍,第三次更低,呈指数级衰减。
这种做法的本质缺陷在于:
- 无法建模“负收益”:指数衰减只能模拟收益变小,但无法模拟 Loss 因为过拟合而直接飙升的情况。
- 忽略了模型规模的交互:经验告诉我们,参数量越大的模型,在小数据集上过拟合得越快。旧法则对 100M 和 1B 的模型在处理重复数据时的区别视而不见。
方法论详解:加性过拟合惩罚
作者通过训练超过 300 个模型(参数量 15M 到 1B),提取出了由于重复训练带来的“超额损失(Excess Loss)”。
核心直觉
作者认为重复 Token 扮演着双重角色:
- 正面贡献:它们依然提供了学习机会,减少了由于数据不足带来的损失。
- 负面惩罚:随着重复次数增加,过拟合代价以超线性速度增长。
其中最精简的 1 参数形式如下: 这里, 是过拟合系数, 是重复次数。这个简洁的公式背后隐藏着一个重要的物理直觉:过拟合的程度直接取决于参数量与唯一数据量的比例(N/U_D)。
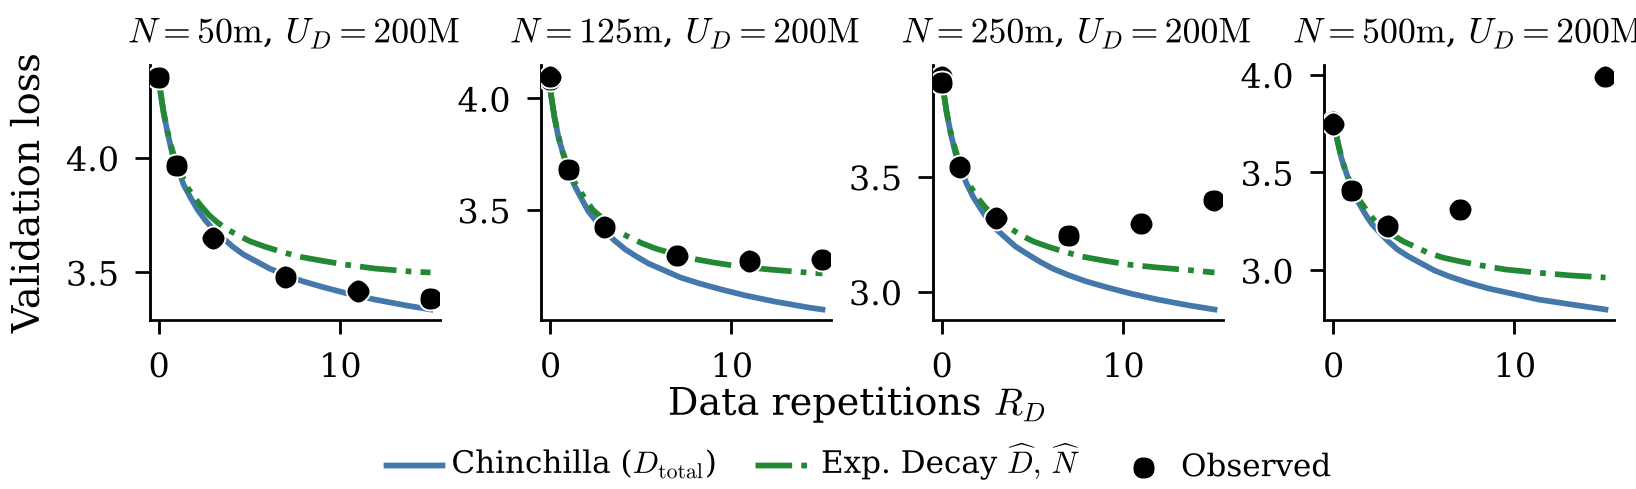 上图显示,现有法则(虚线)在重复轮数较高时显著低估了真实损失(散点),而本文的加性惩罚法则能完美追踪这一趋势。
实验与结果:算力分配的逆向思维
1. 拟合优度的碾压
在 FineWeb 数据集上,新法则的拟合优度达到了惊人的 0.997。即使是单参数的最简版,表现也远好于前人的多参数模型。
2. 算力分配的新边界
这是本文最具冲击力的发现:随着算力增加,过往的法则建议我们不断增加 Epoch,但本文法则给出的 Pareto 前沿是“往回拐”的(如下图)。
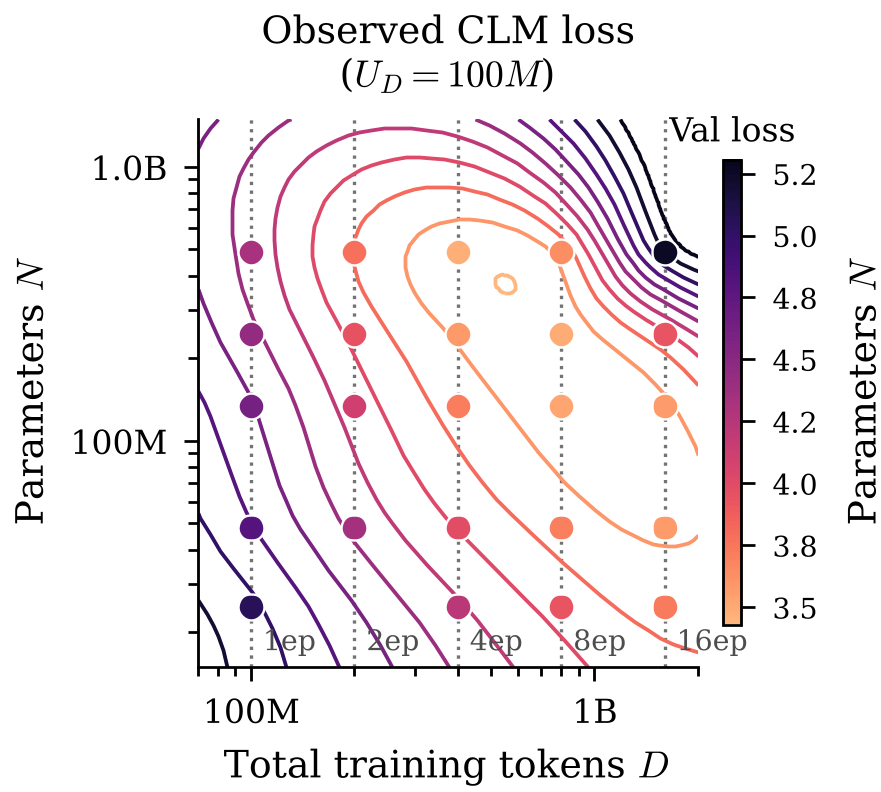 在固定数据 budget 下,当算力跨过某个阈值后,最优策略是减少训练轮数,转而增加模型规模(向上移动)。
3. 正则化的奇效
研究还发现,强权重衰减(Weight Decay ) 可以显著抑制过拟合。虽然在单轮训练中它会带来性能损失(Loss Floor 升高),但在多轮训练中,由于它将过拟合系数 P 降低了约 70%,在算力充足时,强正则化模型会反超标准模型。
深度洞察与总结
Takeaway
- 停止盲目洗数:对于特定领域的任务(如法律、医疗、代码),如果数据量已固定,不要迷信“多跑几个 Epoch 没坏处”。
- 以模型换深度:当数据受限时,训练一个参数量巨大但只跑 2-3 个 Epoch 的模型,效果优于训练一个参数适中但跑 20 个 Epoch 的模型。
局限性
- 规模外推:虽然在 1B 规模下表现稳健,但在 70B 甚至 400B 规模下,过拟合系数是否依然线性遵循该规律仍待验证。
- 正则化多样性:目前仅测试了 Weight Decay,Dropout 或其他数据增强手段对 P 系数的影响尚不明确。
在高质量数据逐渐稀缺的今天,这项研究为我们提供了一张精准的地图,告诉我们在翻过“数据贫瘠”的山丘后,应该如何正确地消耗手中的每一份算力。