
PRL-BENCH:物理科研的“终极考场”,谁能摘得 AI 科学家的桂冠?
PRL-Bench: A Comprehensive Benchmark Evaluating LLMs' Capabilities in Frontier Physics Research
本文推出了 PRL-BENCH,一个专为评估大语言模型(LLMs)在前沿物理研究中端到端能力的基准测试。该基准包含 100 个基于 2025 年后 Physical Review Letters 最新论文构建的复杂任务,涵盖天体物理、凝聚态、高能物理等五大领域。
TL;DR
随着 AI for Science 步入 Agentic Science 时代,我们不仅需要 AI 算题,更需要 AI 能够自主“做科研”。上海交通大学等多家机构联合推出了 PRL-BENCH,一个基于《物理评论快报》(PRL)最新研究构建的、具有长程探索性质的物理科研基准。实验证明,即便是最强的 GPT-5.4 或 Gemini-3.1-Pro,在面对真实的前沿物理任务时,得分也未能及格(<50分)。
痛点深挖:为何我们需要比 HLE 更有难度的 Benchmark?
在学术界,我们已经有了诸如 OlympiadBench(奥赛级)或 Humanity's Last Exam (HLE)(研究生级)这样的难度巅峰。但这些测试大多是“闭卷考试”的变体:
- 路径已知:问题通常有明确的定义,模型只需找到对应的推理链条。
- 静态评估:侧重于考察知识储备而非探索过程。
然而,真实的物理研究(如凝聚态中的拓扑相位模拟)是一个**长程(Long-horizon)**过程。研究者需要从动机出发,选择数学框架,进行复杂的符号演算,编写代码验证,再根据结果修正假设。现有 Benchmark 无法捕捉这种“在迷雾中航行”的能力。
核心方法:重塑科研任务的“物理直觉”
PRL-BENCH 的核心在于其任务设计的哲学转变。它不再是简单的问答,而是将 100 篇前沿 PRL 论文转化为 100 个科研任务:
- 探索导向 (Exploration-oriented):任务隐去了具体的解题步骤,仅给出“研究目标”。
- 异构工具链 (Heterogeneous Workflow):模型必须配合 Code Interpreter 处理复杂的算符运算和程序化校验。
- 客观验证性 (Objective Verifiability):尽管推理路径开放,但最终结果(数值、解析式)需严格对标专家校验的 Standard。
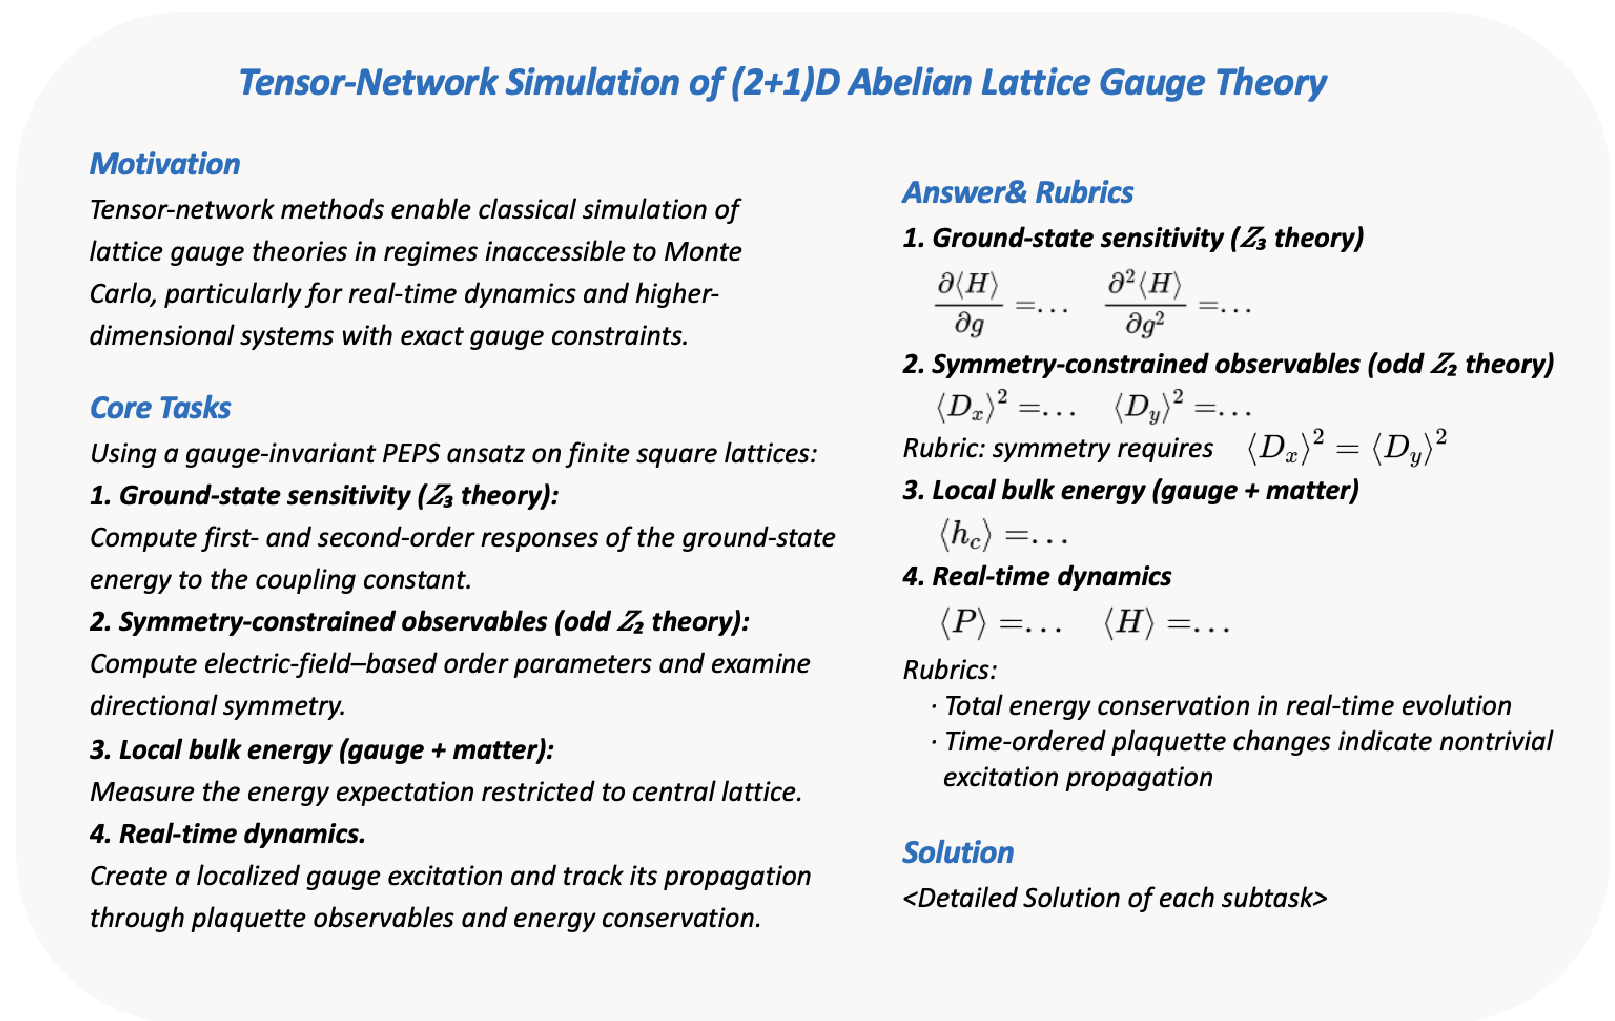
图注:上图展示了一个典型的科研任务,包含动机说明、核心挑战、以及评分准则(Rubrics)。
实验与结果:全线折戟的“前沿之战”
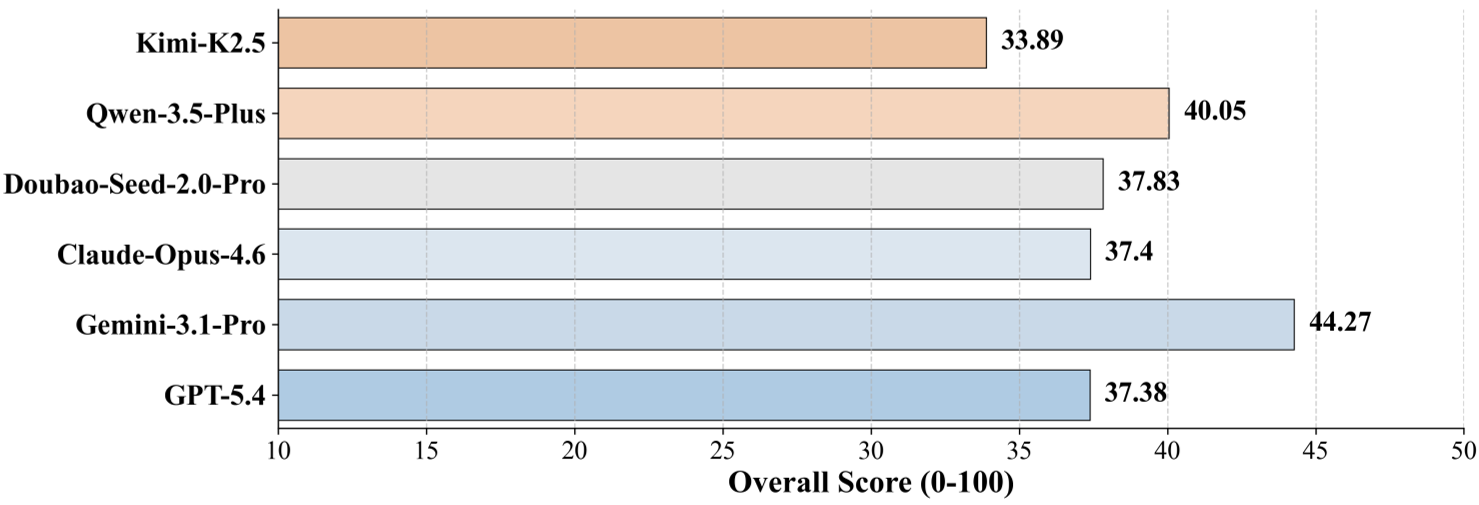
作者评估了包括 GPT-5.4、Gemini-3.1-Pro 和 Claude-Opus-4.6 在内的全球顶级模型。
1. 整体战绩:未及格的尴尬
得分最高的 Gemini-3.1-Pro 也仅获得了 44.27 分。这意味着,目前的 LLM 在处理真正的“科研级”物理问题时,极容易在中间环节“掉链子”。
2. 五大领域表现差异
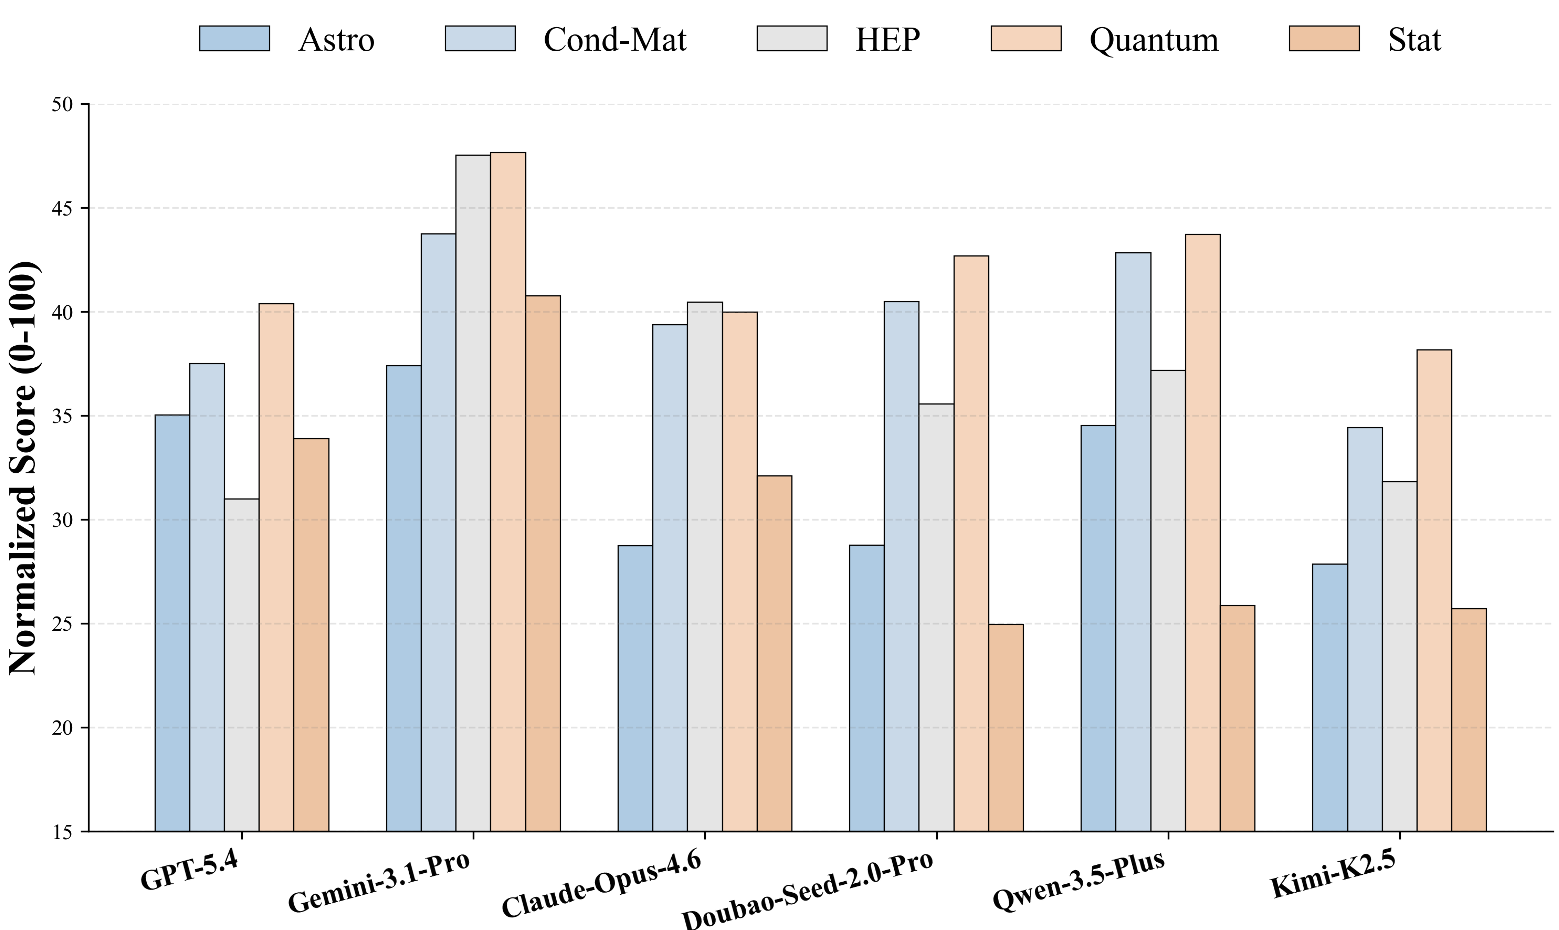
模型在凝聚态物理 (Cond-Mat) 和 量子信息 (Quantum) 领域的表现相对较好,这可能得益于该领域有较多标准化的推理模板。而在天体物理 (Astro) 和 统计物理 (Stat) 中,由于问题的高度异构性和对非标准化公式的需求,模型得分骤降。
3. 失败模式拆解 (Error Analysis)
通过对响应轨迹的深度剖析,作者发现了导致失败的四大元凶:
- 公式/概念错误 (占 ~50%):这是最大的瓶颈。模型在最开始的物理模型选择上就南辕北辙。
- 推导稳定性差 (Derivation Error):在多步符号运算中经常引入虚假假设,导致幻觉。
- 长程任务适应不良 (Incompleteness):特别是在 Claude 模型中,表现出多次尝试纠错但最终导致推理链崩溃,无法给出完整答案。
深度洞察:我们离“AI 物理学家”还有多远?
PRL-BENCH 的存在,撕开了 LLM 在前沿科学领域“无所不知”的假象。
- 知识鸿沟:即便是最先进的模型,对于 PRL 这种级别的垂直领域深度知识,训练覆盖率依然不足。
- 规划能力的缺失:自主物理研究的核心不仅是推理,更是战略性规划。如何在复杂的数学约束下找到最优解法,目前的模型尚未展现出这种“研究直觉”。
总结
PRL-BENCH 为下一代 AI Scientist 的开发确立了新的坐标。未来的 AI 系统如果想在物理学上有所突破,必须超越单纯的知识索引,在复杂长程规划和动态修正科学假设的能力上实现质的飞跃。
注:由于原论文 Markdown 中部分图片链接为示意,读者可访问 https://huggingface.co/datasets/AdrianMiao/PRL_Bench 获取完整数据集。