
ProMMSearchAgent:突破知识边界,以过程奖励重塑多模态搜索智能体
ProMMSearchAgent: A Generalizable Multimodal Search Agent Trained with Process-Oriented Rewards
本文提出了 ProMMSearchAgent,一种通过过程导向奖励(Process-Oriented Rewards)训练的多模态搜索智能体。该方法引入了离线探测机制来识别模型知识边界,并结合“从仿真到现实”(Sim-to-Real)的解耦训练范式,显著提升了多模态大模型在知识密集型视觉问答(VQA)任务中的工具使用效率。
TL;DR
在多模态理解领域,当模型遇到不认识的著名地标或时效性新闻时,调用搜索工具是本能。然而,如何让模型“聪明地调用”——在懂的时候不乱搜,在不懂的时候必搜?本文提出的 ProMMSearchAgent 通过一套内省式过程奖励机制和Sim-to-Real 训练范式,让 7B 规模的模型在视觉搜索任务上超越了强基线,准确率最高提升 11.3%。
1. 痛点:为什么 Agent 会“变笨”或“乱搜”?
在训练多模态搜索智能体时,研究者通常会遇到两个难题:
- 奖励-动作不匹配 (Reward-Action Mismatch):为了防止模型变成“搜索狂”,前人常设置工具使用惩罚(Tool Penalty)。但这产生了冲突:当问题确实难到必须搜索才能解决时,模型因为选了“正确动作”反而被扣分。
- 不稳定的真实环境:直接在 Google 或 Bing 等实时 API 上跑 RL 训练,不仅昂贵、缓慢,而且网络环境的波动让实验结果极难复现。
2. 核心机理:内省式过程奖励 (Process-Oriented Reward)
作者的核心 Insight 是:模型应该奖励的是“决策与知识边界的一致性”。
2.1 行为元数据引擎 (Behavioral Metadata Engine)
在正式训练前,作者先让模型对训练集进行 8 次“闭卷考试”。
- 如果 8 次都答错,标记为
tool-required(必须搜索)。 - 如果任一次答对,标记为
tool-free(具备内生知识)。 这组数据成为了 RL 阶段的“金标准”,模型只有在需要搜的时候搜,才能拿到高额的过程分。
2.2 奖励函数的解耦
不同于传统的混合奖励,本文将奖励拆解为: 其中 重点奖励行为对齐性(即模型动作是否符合上述元数据标记)。
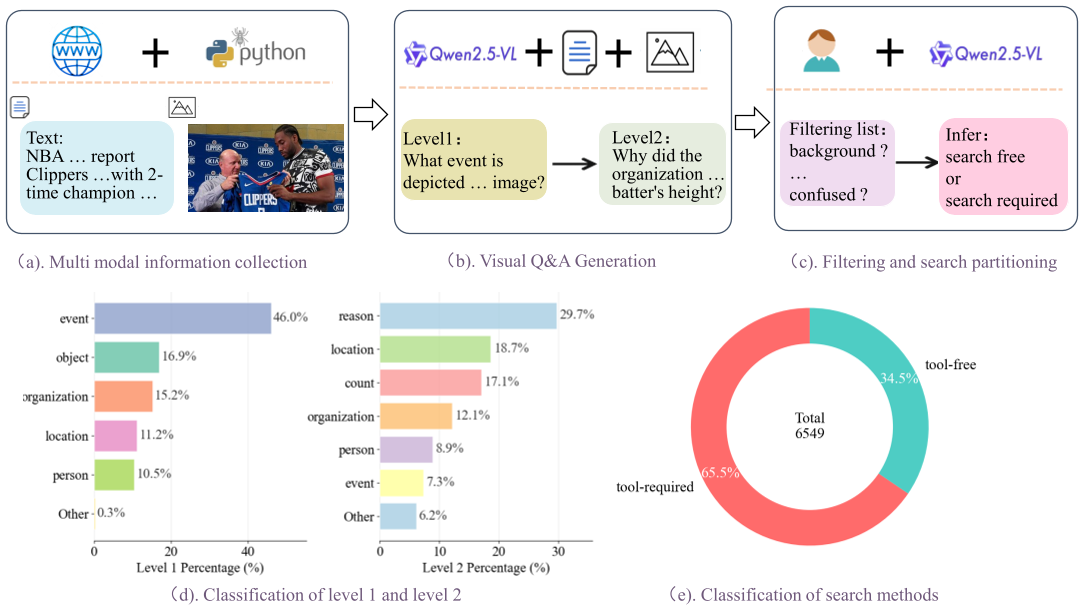 图 1:ProMMSearchAgent 的系统架构与奖励分解示意图
3. 训练范式:从沙盒到现实的跨越 (Sim-to-Real)
为了解决训练效率问题,作者构建了一个本地工具沙盒。
- 文本端:使用 2025 年 Wikipedia 离线库。
- 图像端:通过 Google Lens 预计算所有图片的 top-K 相似图并本地缓存。
在确定性的沙盒里,模型专注于学习“查询词构造”和“证据融合”的逻辑。实验证明,这种在本地学到的“搜索逻辑”是高度泛化的,训练完的模型直接接入实时 Google API(Zero-shot Transfer),性能不但没崩,反而更强了。
4. 实验战绩:超越 32B 甚至更强的闭源模型
在 FVQA、InfoSeek 和 MMSearch 等五个知识密集型榜单上,ProMMSearchAgent 展现了统治力。
| 模型 | FVQA-test | InfoSeek | MMSearch |
|---|---|---|---|
| Qwen2.5-VL-32B (ReAct) | 51.3 | 38.0 | 27.3 |
| MMSearch-R1 | 58.0 | 49.0 | 43.9 |
| ProMMSearchAgent (7B) | 63.1 | 55.3 | 55.2 |
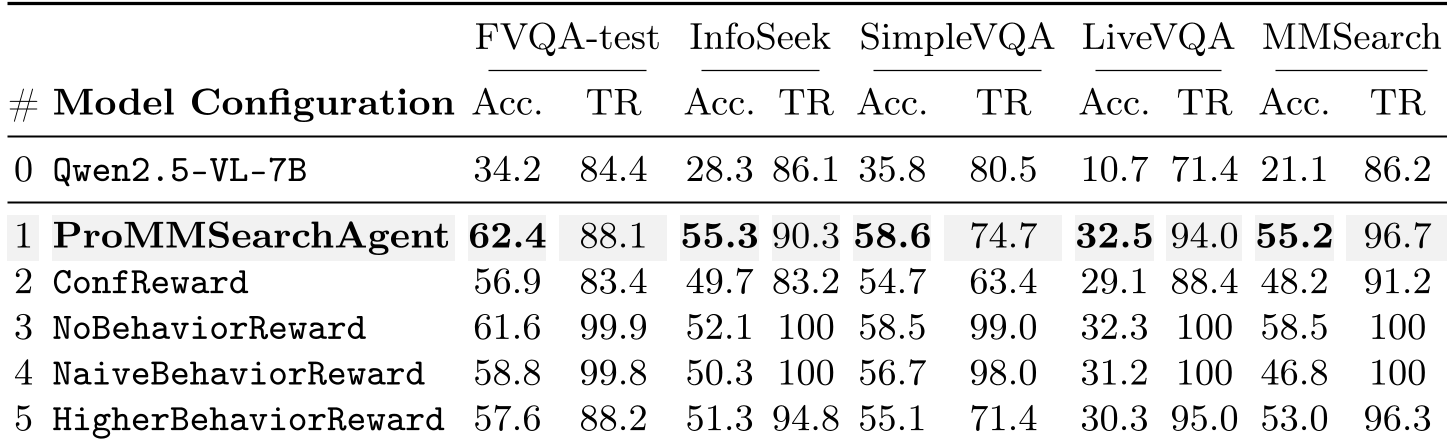 图 2:消融实验对比,展示了行为奖励(Row 1 对比 Row 3/4)对工具调用准确率(Acc)与比例(TR)的优化作用
5. 深度洞察:工具调用的“自适应性”
通过观察发现,ProMMSearchAgent 表现出了一种元认知校准能力:
- 在简单任务(如 SimpleVQA)上,它自发减少了 5.8% 的工具调用,因为内生知识已够用。
- 在高难度任务(如 LiveVQA)上,它将调用率从 71.4% 提到 94.0%,且准确率翻了三倍。
这说明通过过程奖励,我们真正教会了模型“反思”自己的能力极限,而非简单地模仿某种格式。
6. 总结与局限
ProMMSearchAgent 通过“离线探测边界+在线过程奖励+本地沙盒训练”三位一体,解决了多模态 Agent 训练难、贵、乱的问题。 局限性:尽管检索逻辑可迁移,但本地沙盒的知识覆盖范围仍限制了模型在训练阶段的想象力。未来如果能引入更动态的、基于大规模合成数据的模拟环境,Agent 的搜索策略可能会进化出更复杂的长程规划能力。
Takeaway: 真正的自律源于对无知的自觉。如果你想训练一个好 Agent,别只看它最后对不对,要看它在犹豫时是否拿起了正确的放大镜。