
RAG 的下半场:检索“思考轨迹”而非“文档”
RAG over Thinking Traces Can Improve Reasoning Tasks
本文提出了针对推理任务的 RAG 新范式,核心方法是将检索对象从传统的外部文档切换为“思考轨迹 (Thinking Traces)”。通过名为 T3 (Transformation of Thinking Traces) 的离线转换技术,将冗长复杂的推理过程转化为结构化片段,在 AIME、GPQA-Diamond 等基准测试中显著提升了 GPT-5、Gemini-2.5-Flash 等顶级模型的逻辑推理能力。
TL;DR
长期以来,学术界普遍认为 Retrieval-Augmented Generation (RAG) 擅长背书(事实性任务)但不擅长做题(理性任务)。UC Berkeley 的最新研究挑战了这一共识:RAG 无效不是检索的问题,而是语料的问题。 通过检索高水平模型的“思考轨迹 (Thinking Traces)”并利用 T3 (Transformation of Thinking Traces) 框架进行转换,GPT-5 在 AIME 竞赛上的表现得到了进一步提升,而 Gemini-2.5-Flash 更是实现了惊人的 56% 性能飞跃。
背景:RAG 在推理任务上的“滑铁卢”
传统的 RAG 依赖于 Wikipedia 或网页快照,这在回答“地球到月球的距离”时非常有效。但对于“如何解复杂的几何证明题”,这些文档往往爱莫能助。现有工作的局限性体现在:
- 缺乏过程信号:事实性文档只给结论,不给解题的“心路历程”。
- 噪音干扰:通用语料包含大量无关信息,往往会误导模型的推理逻辑。
核心 Insight:将解题经验“外部化”
作者认为,推理能力的提升需要学习“如何思考”。既然顶级模型(如 Gemini-2-thinking)在思考时会产生详尽的轨迹,为何不把这些轨迹存起来,作为其他模型解题时的参考书?
T3 框架:对原始轨迹的高级加工
直接检索原始轨迹(Raw Traces)通常效果不佳,因为它们太长、太乱。T3 为了让这些数据变得“检索友好”,设计了三种变换模式:
- Struct(结构化规范):将解题过程拆解为标准步骤(Step 1, Step 2...),保留算法逻辑。
- Semantic(语义蒸馏):提取核心思想(Core Insight),剔除繁琐的代数运算过程。
- Reflect(错误反思):以对比形式列出“这里容易掉进什么坑”、“应该如何检查”,极具启发性。
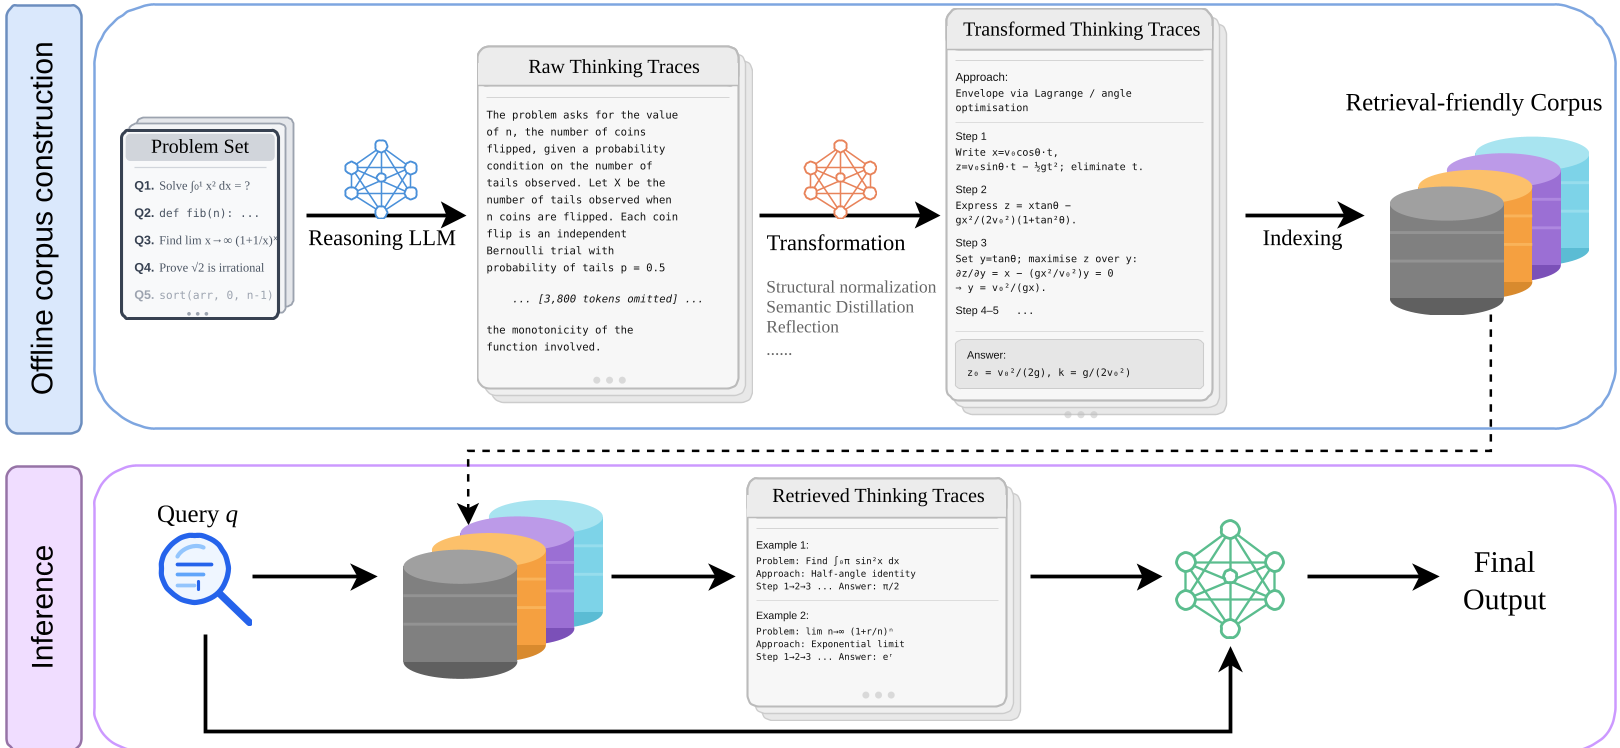 图 1:T3 离线生成语料与在线检索推理的工作流
实验战绩:推理能力的集体飞跃
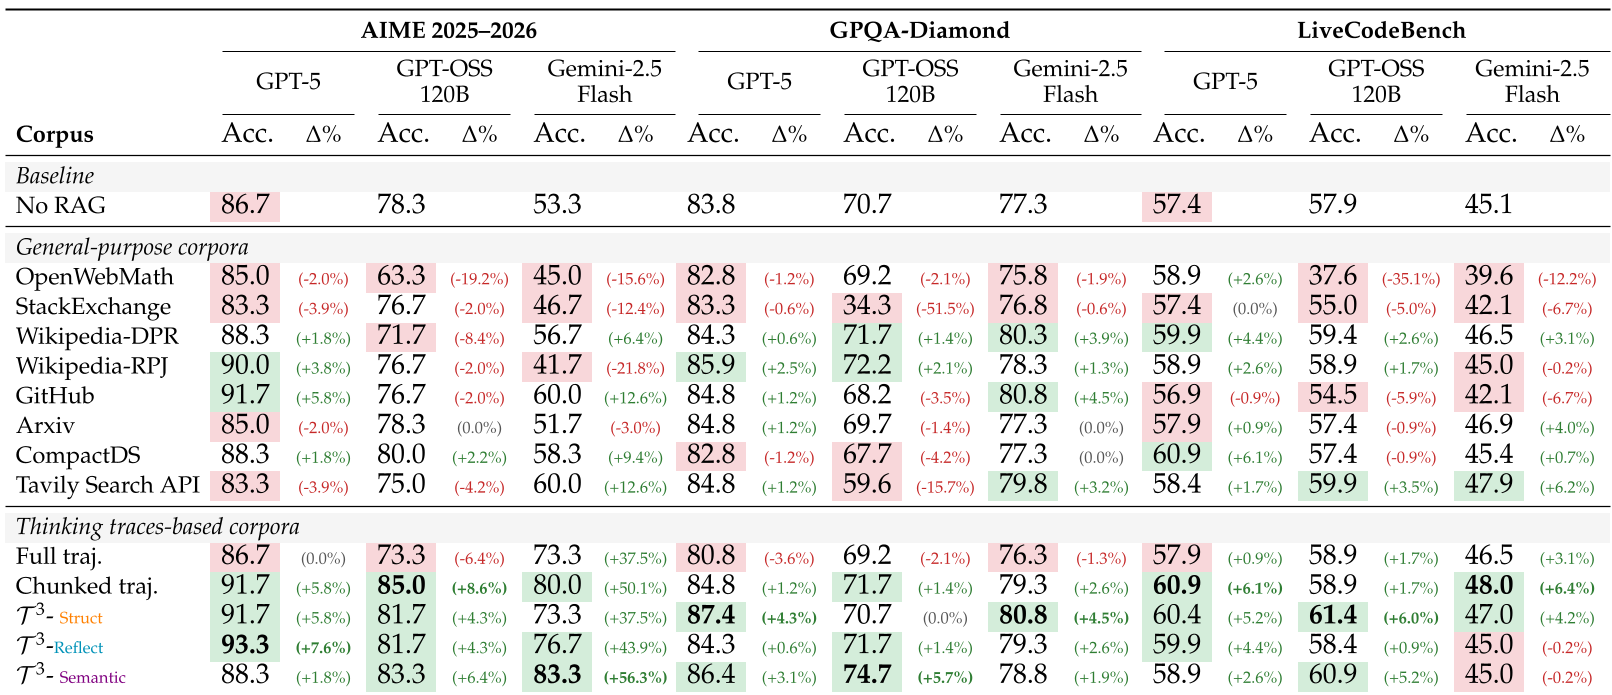
研究者在 AIME 2025-2026、GPQA-Diamond 和 LiveCodeBench 三大高难度基准上进行了测试。
1. 显著的性能增长
如下表所示,检索“思考轨迹”比检索普通“网页文档(OpenWebMath)”效果好得多。尤其是在 AIME 数学竞赛中,即使是本身已经极强的 GPT-5,在辅助下准确率也从 86.7% 提升到了 93.3%。
2. 成本-精度的帕累托优化
一个有趣的发现是,利用 T3 后的 RAG 有时比 No RAG 还要省钱。
- 原理:高质量的检索内容充当了预置的“思维导图”,使模型不再需要反复试错和产生冗长的中间文字,从而减少了输出 Token 数。
- 数据:GPT-5 在性能提升的同时,单次查询成本降低了约 15%。
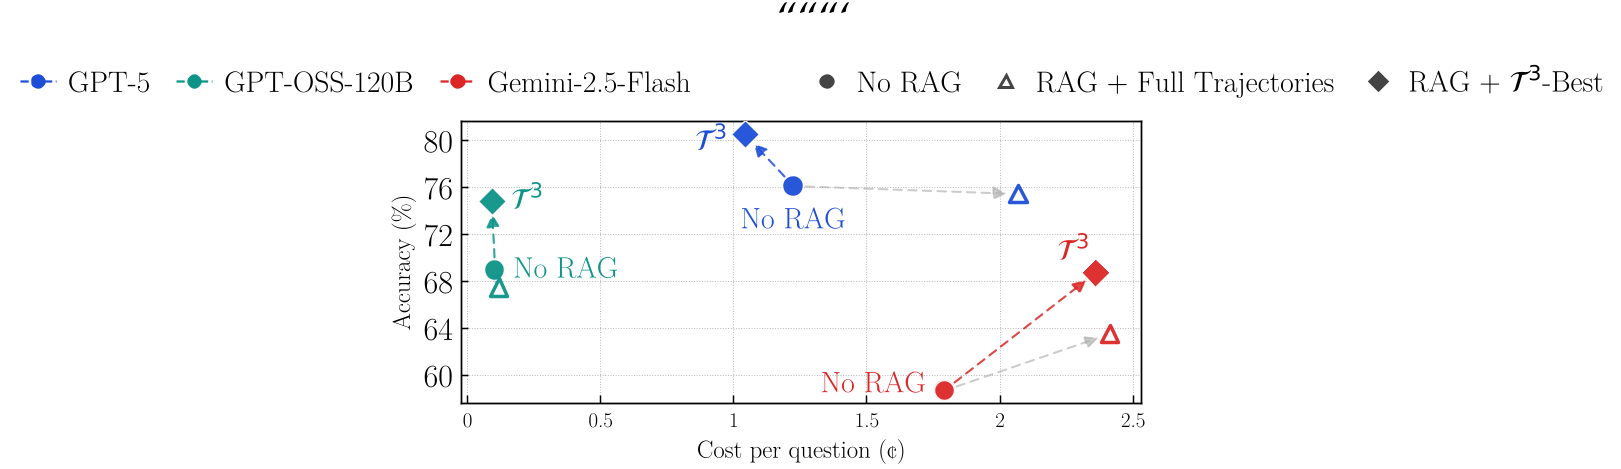 图 2:T3 框架在成本与精度上表现出更优的权衡
深度观察:跨模型的“思考传递”
实验还证明了一个极具行业潜力的现象:推理经验是可迁移的。 即便是使用 QwQ-32B(体量较小)产生的思考轨迹,依然能帮助 Gemini 或 GPT 这样的大模型解决难题。这意味着我们可以用昂贵的大模型生成“白皮书”,然后存入知识库,长期赋能更轻量、低成本的推理模型。
局限与未来展望
尽管 T3 表现卓越,作者也指出了目前的局限:语料库目前高度集中在数学领域。未来,如果能将这套方法扩展到法律推理、医学诊断或复杂的策略游戏(RL)领域,RAG 的天花板将被彻底打破。
总结
这篇论文有力地回击了“RAG 对推理无用论”。它向我们展示:思考本身也是一种可以被存储和索引的知识。 当我们将 RAG 的检索对象从“世界知识”升级为“人类与人工智能的思维模板”时,通用推理引擎的进化才刚刚开始。