
[CVPR 2026] Rays as Pixels: 统一视角下的视频生成与相机位姿估计
Rays as Pixels: Learning A Joint Distribution of Videos and Camera Trajectories
本文提出了 Rays as Pixels (Raxels),这是一个将视频生成与相机位姿估计统一在单个视频扩散模型(VDM)下的框架。通过将相机射线参数编码为与 RGB 图像空间一致的 3 通道“像素级射线图”,该模型实现了视频与相机轨迹的联合分布学习,在相机控制视频生成和位姿估计任务中均达到了 SOTA 水平。
TL;DR
传统的 3D 视觉管线中,相机位姿估计和新视角合成一直是“各扫门前雪”。本文提出的 Rays as Pixels (Raxels) 打破了这一隔阂。通过将相机射线编码成“像素”,作者在一个 20B 参数的视频扩散模型中实现了视频内容与相机轨迹的联合分布建模。这意味着同一个模型,既能根据轨迹生视频,也能根据视频算位姿,甚至能左右互搏进行自检。
痛点深挖:被割裂的“几何”与“生成”
在处理稀疏视角的 3D 重建时,我们经常陷入一个死循环:
- 位姿估计器 (SfM) 需要足够的重叠度才能解算出准确的相机参数。
- 生成模型 (NVS) 需要准确的相机参数作为控制条件才能生成连贯的新视角。
一旦输入只有区区几张图,COLMAP 挂了,生成模型也就成了无头苍蝇。作者认为,视频轨迹与其视觉表现本质上是高度耦合的,应该用一个单一的生成概率分布 来描述,而不是简单的条件概率 。
核心方法:Raxels —— 让相机参数“图像化”
为了让视频扩散模型(如 Wan 2.1)理解相机几何,作者提出了 Raxel。
1. 射线即像素 (Rays as Pixels)
传统的相机参数是 4x4 矩阵,属于低维全局向量,这与 DiT 处理的稠密空间 Token 格格不入。作者通过以下公式将每个像素 投影为世界坐标系下的射线方向 和原点 : 这得到了一张 3 通道的“相机图”。这种设计的妙处在于:它与 RGB 图像具有相同的空间拓扑结构,可以直接塞进预训练好的 VAE Encoder,共享相同的潜空间偏移和 RoPE 位置编码。
2. 解耦自-交叉注意力 (Decoupled Self-Cross Attention)
视频帧包含高频纹理,而射线图包含平滑的几何梯度。为了防止两种模态在 Self-Attention 中互相干扰,作者设计了 DSCA 模块:
- Intra-Modal Self-Attention:视频处理视频的流畅性,射线处理轨迹的平滑性。
- Inter-Modal Cross-Attention:视频 Token 询问“我的几何在哪?”,射线 Token 询问“这里的视觉内容长啥样?”,实现几何约束。
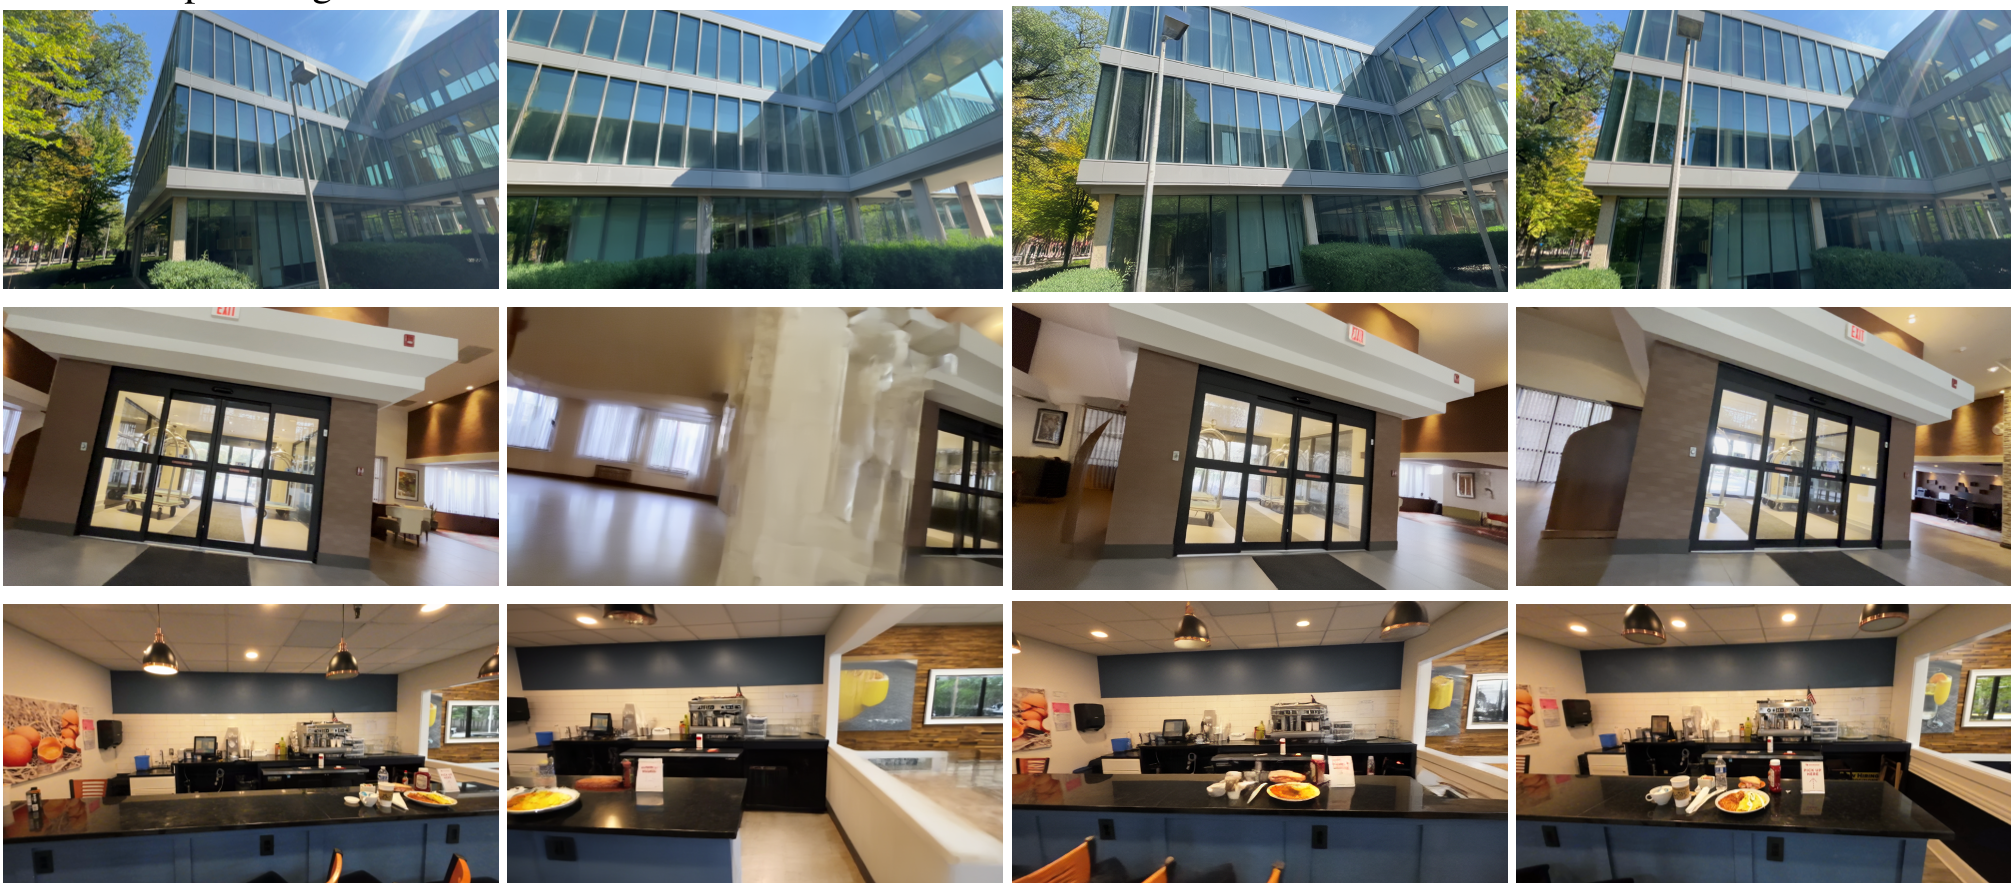 图 2 & 4:Raxels 框架概览与 DSCA 模块细节。可以看到射线图与视频帧是如何被并行处理并交叉影响的。
实验与结果:不仅能生,还能算
1. 闭环自一致性测试 (Cycle Self-Consistency)
这是本文最惊艳的评价方式:
- 首先,给模型一段视频,让它预测相机轨迹(Inverse Process)。
- 接着,把预测的轨迹再喂给模型,让它重新生成视频(Forward Process)。 实验证明,由于学习的是联合分布,模型生成的视频与原视频高度契合,这种“自我印证”的能力是传统单向模型(如 MotionCtrl 等)完全不具备的。
2. SOTA 性能对比
在 DL3DV 和 Tanks and Temples 这种复杂场景下,Raxels 的生成质量(FID)和时间连贯性(FVD)均大幅领先于目前的最强基线 Kaleido 和 Wonderland。
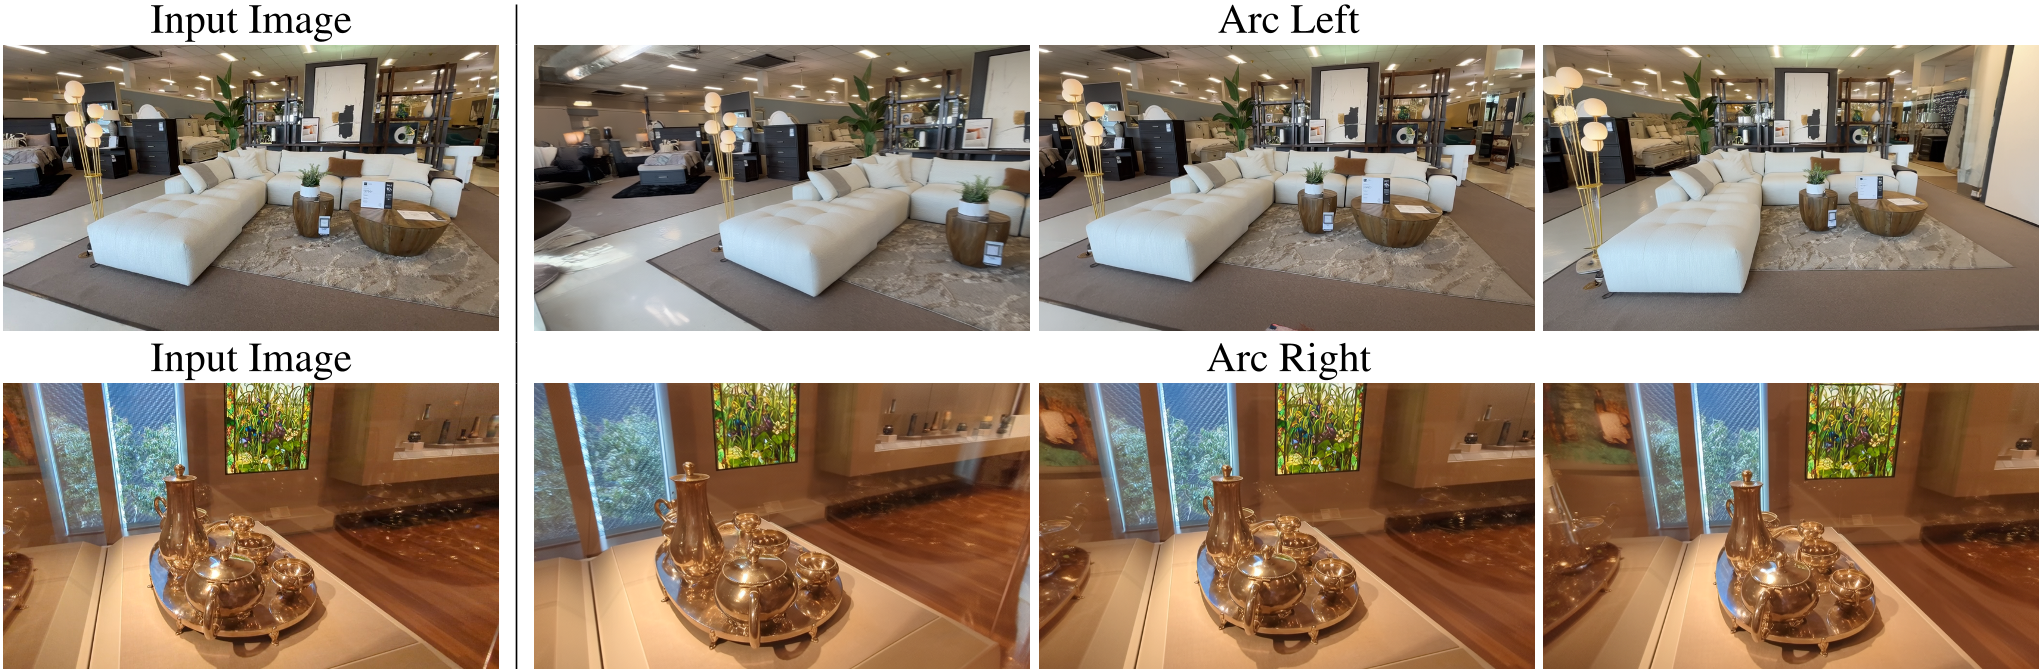 图 5:在复杂反射面和杂乱场景下,模型依然能精准遵循定义的“弧形向左/向右”轨迹进行高质量合成。
深度洞察
Raxels 的成功揭示了一个趋势:基础模型正在吞噬传统的几何管线。
- Inductive Bias 的平移:通过将几何信息 Raxel 化,模型利用了在大规模视频中学到的视觉先验来辅助几何推理。
- 多模态的终局:相机参数不应只是“外挂”,而应作为模型的一种内生模态。
局限性:目前的训练数据主要集中在静态场景。对于动态物体(如街头走动的人)与相机运动叠加的复杂场景,模型解耦运动归因的能力仍有提升空间。
总结
Rays as Pixels 不仅仅是一个更好用的相机控制工具,它为具身感知提供了一个新思路:当 AI 能够联合建模“我看到的图”和“我移动的径”,它才真正开始理解这个三维世界。