
RCoT-Seg:让视频分割学会“思考”与“纠错”——基于强化学习的智能选帧策略
RCoT-Seg: Reinforced Chain-of-Thought for Video Reasoning and Segmentation
本文提出了 RCoT-Seg,一种基于强化学习的视频推理分割(VRS)框架。该方法通过引入“视频思维链”(Video-of-Thought),将任务分解为时序视频推理(TVR)和关键帧目标感知(KTP),并利用 GRPO 强化学习算法优化智能关键帧选择与目标定位,实现了 SOTA 性能。
TL;DR
传统的视频推理分割(VRS)模型往往在选关键帧时“一锤子买卖”,选错了就全盘皆输。哈工大、鹏城实验室等机构的研究者提出了 RCoT-Seg,它为模型装上了“脑子”:通过强化学习(GRPO)训练,模型不仅会选帧,还会自我评价——“这张图证据够吗?不够我再换一张”。这种将 Chain-of-Thought (CoT) 变成可执行状态的策略,配合 SAM2,在多个 VRS 榜单上刷新了记录。
痛点深挖:选帧的“单向盲目性”
在处理如“分割那个在跳舞前换了衣服的人”这种涉及复杂时序逻辑的指令时,模型必须在数以百计的视频帧中找到最关键的那一刻。
先前的模型(如 VISA, GLUS)通常采用简单的启发式采样或辅助模型选帧。核心问题在于:关键帧选择被视为一个不可逆的预处理步骤。如果初始选中的帧里目标被遮挡,或者时序证据不足,下游的分割模块即使再强,也无法基于错误的信息生成正确的 Mask。
核心方法:两阶段的“思维进化”
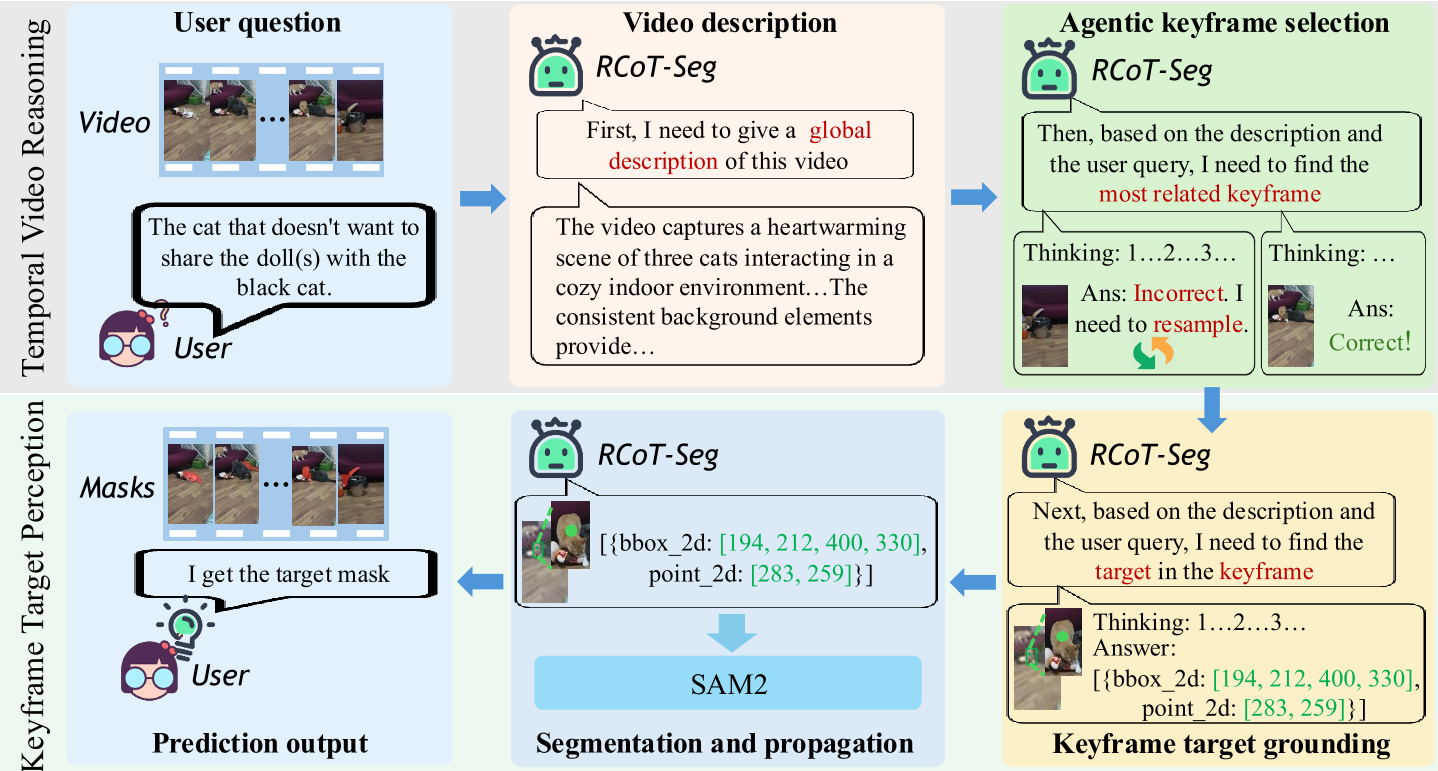
RCoT-Seg 将 VRS 任务解耦为两个相互耦合的子过程:时序视频推理 (TVR) 和 关键帧目标感知 (KTP)。
1. 智能关键帧选择 (AKS) —— 赋予模型“反思”能力
这是本文最有洞见的改进。AKS 不仅仅输出一个帧索引,还会进入一个轻量级的自我批判循环。
- Actionable CoT:模型生成一段推理思路,判断当前帧是否满足查询指令的条件。
- 重新决策:如果判断结果为“不满足”,模型会自动触发重选,直到找到最优证据帧。
2. 匈牙利算法驱动的 GRPO 强化学习
为了训练这一套流程,作者借鉴了 DeepSeek-R1 的 GRPO (Group Relative Policy Optimization) 公式。针对分割任务中常见的多目标混淆,作者设计了一个基于匈牙利算法 (Hungarian-based) 的奖励函数。
- 它能在大模型预测的一堆 Bounding Boxes 和 Ground Truth 之间进行最优匹配,从而为每一个预测对象分配准确的奖励信号(Credit Assignment),解决了复杂场景下 RL 训练不稳定的问题。
实验与结果:小参数博大位
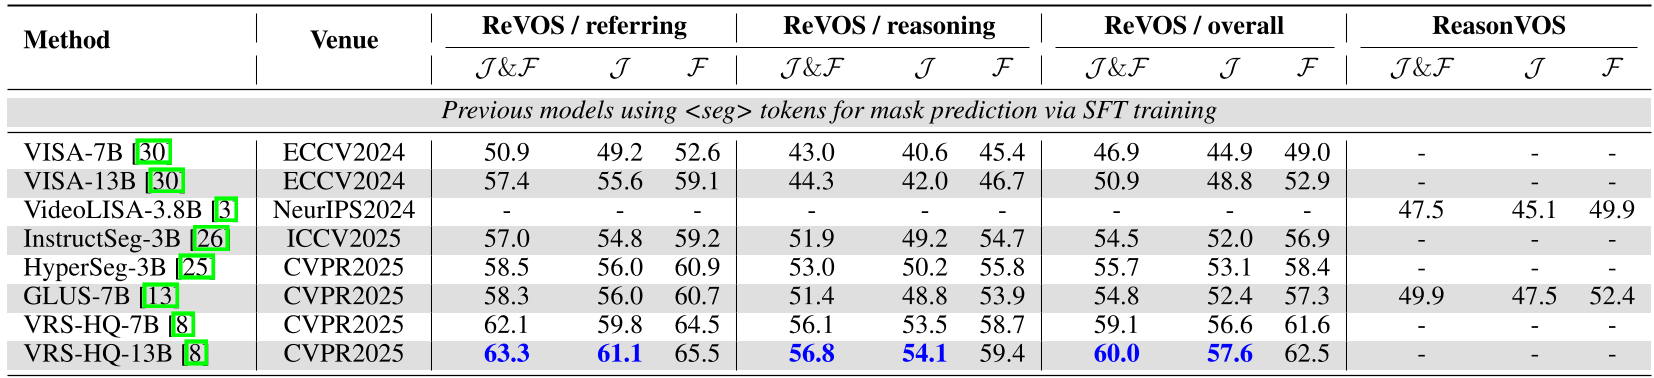
尽管 RCoT-Seg 基于 Qwen2.5-VL-3B 构建,但其表现却超越了许多 13B 甚至更大的模型。
- 高性能表现:在 ReVOS 整体测试中达到 61.2 J&F,显著优于 VRS-HQ-13B。
- AKS 的真实增益:消融实验表明,开启 AKS 后,模型在 DAVIS17 等数据集上的感知面积比(Area Ratio)提升了 10%-20% 以上,证明了“重选”机制确实找准了目标。
深度洞察:为什么这种解耦有效?
- 分治思想的胜利:大模型在全视频低分辨扫描时擅长“逻辑推理”,但在高像素分割时擅长“空间定位”。RCoT-Seg 让 TVR 在低分辨下找逻辑,KTP 在高分辨下抠细节,各司其职。
- CoT 的工程实用化:在这篇论文里,CoT 不再只是写给人类看的“解释”,而是模型逻辑流转的中间变量。这种“执行过程中的逻辑验证”是未来构建复杂代理型(Agentic)视觉系统的关键。
总结与启示
RCoT-Seg 的成功标志着视频理解正在从“黑盒映射”向“结构化推理”转变。利用强化学习来对齐推理路径与分割结果,是一个非常有前景的方向。
局限性:目前该模型在“零目标分割”(即视频中不存在指令所述物体)时仍会出现误报,这需要在未来通过更丰富的数据对比(Negative Samples)来进一步优化。
本博客由资深技术主编深度解读。