
自动驾驶中的博弈实时求解:Newton-type 时间分布式迭代的力量
Real-Time Solution-Seeking for Game-Theoretic Autonomous Driving via Time-Distributed Iterations
本文提出了一种基于时间分布式迭代(Time-Distributed Iterations)的博弈论模型预测控制(GT-MPC)框架,旨在解决自动驾驶中多智能体纳什均衡(Nash Equilibrium)求解的高计算复杂度问题。通过结合 Newton 方法和 Newton–Kantorovich 方法,该方案在每个采样周期仅执行有限次迭代,实现了实时交互式决策。
TL;DR
在复杂的路口穿行或变道场景中,博弈论模型预测控制(GT-MPC)被认为是捕捉多车交互的“金标准”。然而,由于计算量巨大,GT-MPC 往往只存在于仿真环境中。本文介绍了一种基于 Time-Distributed Iterations 的全新架构,通过 Newton 和 Newton–Kantorovich 方法,将复杂的博弈计算拆解到每一帧的采样周期中,实现了自动驾驶博弈决策的实时化。
背景定位:博弈虽好,实时太难
传统的自动驾驶决策模型往往将周边车辆视为移动障碍物(Obstacle-based),忽略了“我动你也动”的反馈互动。**博弈论模型(Game Theory)**通过寻找纳什均衡(NE)来模拟这种互动,但其代价是在每个 MPC 步长内都要解一个高度非线性的优化问题。这在算力有限的车载环境中几乎是不可能完成的任务。
本文的研究直觉在于:交通流是一个连续的过程,相邻时间步之间的博弈解具有高度的相似性。 如果我们不再追求要在每一个时刻“一步到位”地算出完美的 NE,而是利用历史信息通过有限次迭代进行“在线追踪”,就能大幅降低单步计算负荷。
核心架构:分布式求解策略
作者提出了两种 NE 求解路径,并为其设计了二阶加速算法:
- 势博弈优化(Potential Function Optimization):通过构造一个全局势函数 ,将寻找 NE 转化为单一的最小化问题。
- 最优反应动态(Best-Response Dynamics):每个智能体交替优化自己的目标函数,直至系统稳定。
为了加速这两者的求解,文章引入了 Newton–Kantorovich (N-K) 方法。相比传统的 Newton 法每步都要重新计算复杂的 Jacobian 矩阵,N-K 方法通过固定 Jacobian 矩阵并复用计算结果,大幅度消减了二阶导数计算带来的计算开销。
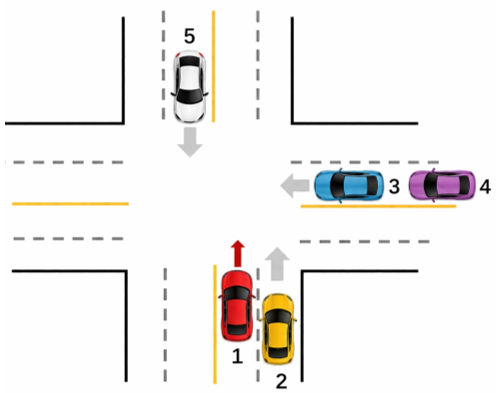 图 1:自动驾驶 5 车交叉路口交互场景示意图
关键技术:时间分布式的魔力
该方法的核心步骤如下:
- 热启动 (Warmstart):利用 时刻的策略序列进行 horizon-shift,作为 时刻的初始值。
- 有限迭代 (Fixed K Iterations):不在单步内追求完全收敛,而是仅执行 (如 2 或 3)次 Newton 更新。
- 误差收敛:随着系统随时演进,即使单步不收敛,多步后解也会迅速逼近最优 NE 情况。
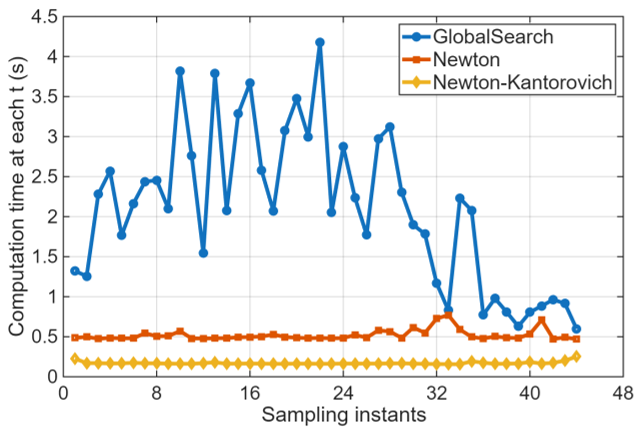 图 2:Newton 与 N-K 方法在势函数优化下的计算耗时,远低于 GlobalSearch
实验与洞察
在 5 辆车穿行无信号灯路口的实验中,我们可以观察到几个有趣的现象:
- 交互强度决定误差:只有当车辆进入路口中心、交互最为剧烈时(强相互作用力),追踪误差才会短暂上升;一旦离开交互区,误差迅速归零。
- N-K 的性价比:尽管 Newton 方法在单次迭代中更精确( 时误差较小),但 Newton–Kantorovich (N-K) 每次迭代的速度快得惊人。在实际工程中,我们可以用增加迭代次数 的方式来弥补 N-K 雅可比矩阵不更新的微小精度损失,从而换取更高的整体吞吐量。
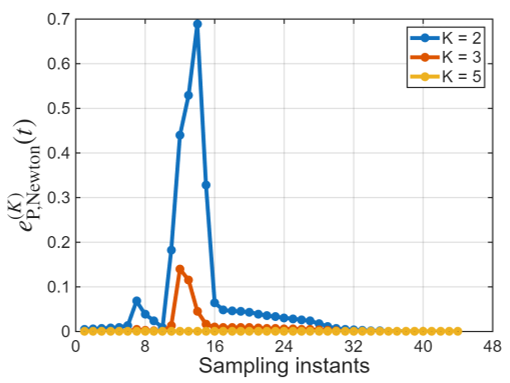 图 3:随着迭代次数 K 的增加,近似误差轨迹显著下降
总结与未来展望
核心价值: 本文证明了 GT-MPC 不需要昂贵的超级计算机,通过巧妙的数学迭代设计(Time-Distributed Iteration),在普通桌面 CPU 甚至车载 SoC 上即可实现 5 智能体级别的博弈决策。
局限性: 该方法目前依赖于势博弈(Potential Game)的特殊结构以保证收敛性。对于更通用的、包含非对称博弈或硬性安全约束(Hard Constraints)的场景,如何保证即便在迭代未完全收敛时的安全性,依然是一个值得探讨的方向。
这篇工作为自动驾驶从“单车智能规划”向“群体博弈交互”的迈进,补齐了最后一块名为“硬件加速”的拼图。