
[Top Tech Review] 推理的本质:LLM 如何通过“把不确定性说出来”实现顿悟?
Understanding Reasoning in LLMs through Strategic Information Allocation under Uncertainty
本文提出了一个信息论框架,将大语言模型(LLM)的推理分解为程序性信息(Procedural Information)和元认知言语化(Epistemic Verbalization)。研究表明,模型在推理过程中的“顿悟”(Aha moments)本质上是内部不确定性的外部化,这种机制在程序性推理陷入停滞时对于实现“信息充分性”至关重要。
TL;DR
为什么 DeepSeek-R1 这种模型在推理时会说“Wait”?这仅仅是格式要求吗?本研究通过信息论证明:这种“元认知言语化”(Epistemic Verbalization)是大模型在处理复杂难题时,将内部隐含的不确定性转化为可交互信息的关键手段。没有它,模型在走入死胡同时将永远无法回头。
1. 顿悟的幻象与真实的算法困境
在过去的一年里,我们见证了 O1、R1 等推理模型产生的“Aha moments”。但学术界一直在争论:这些自我修正行为究竟是真正的逻辑感知,还是仅仅是对高熵 Token 的表面模仿?
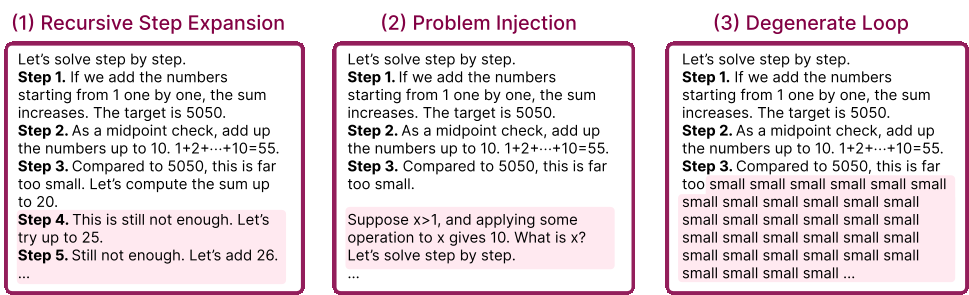
作者指出,目前的 程序性推理(Procedural Reasoning) 存在一个 fatal flaw:一旦进入错误的执行路径,后续的步骤往往具有局部逻辑一致性,但在全局上却信息匮乏。 这会导致模型陷入“推理崩溃”,表现为:
- 递归步骤扩张:陷入暴力代换。
- 问题注入:为了掩盖错误,隐式地改变了原本要解决的问题。
- 退化循环:机械重复相同的结构。
2. 核心假设:推理即不确定性下的战略信息分配
论文提出了一个优雅的数学框架,将推理状态 拆解为: 其中 是解决问题的具体步骤,而 是元认知组件。
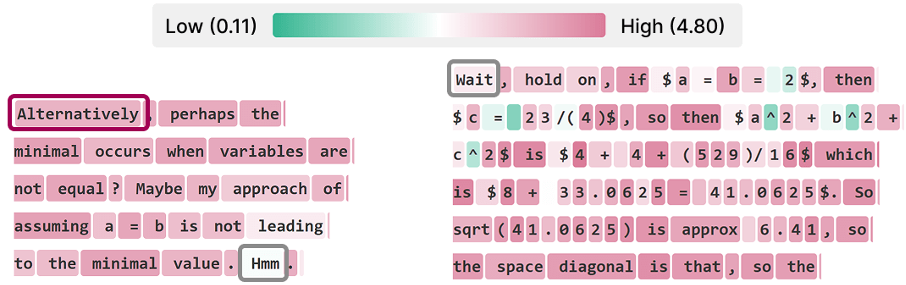
核心直觉 (Insight): LLM 的内部不确定性如果不排泄到文本(Token)中,它就是“惰性”的,无法参与后续的自回归预测。只有当模型写出“ Wait... ”或“ Is that correct? ”时,其内部的不确定性才变成了可调节的外部状态。
论文通过图表证明,普通的 Token 熵(Token-level Entropy)无法区分对错,但 互信息峰值(MI Peaks) 却往往出现在这些元认知言语化的瞬间。
3. 实验发现:越“小”的模型可能越焦虑
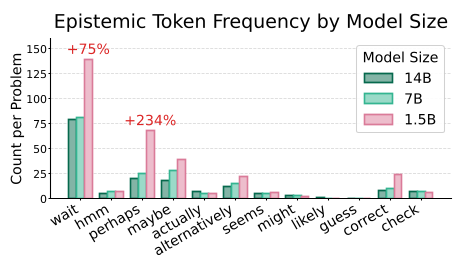
研究人员发现了一个有趣的现象:在相同难度的题目下,参数量较小的模型反而会产生更多的元认知 Token。 这符合直觉:小模型在处理 AIME 等难题时更容易感到“不确定”,因此更频繁地触发元认知言语化来尝试自救。
此外,单纯删除这些 Token 会导致强大的 R1 模型性能大幅缩水。而如果我们在蒸馏(Distillation)时只保留“正确的推理轨迹”而剔除这些“犹豫”的过程,模型的性能会发生灾难性退化。这意味着,那些看起来“废话”的元认知文字,其实是推理模型不可或缺的生存策略。
4. 深度洞察:为什么“Less is More”有时会失效?
最近社区热议 LIMO(Less Is More for Reasoning)现象,即极其少量的(如 800 条)高质量数据就能大幅提升推理能力。本文给出了一个深刻的解释: 蒸馏成功的关键在于“分布对齐”。 如果基座模型的能力(Support)无法覆盖教师模型产生的元认知 Token 分布,训练就会失败。这解释了为什么 Qwen 系列在某些蒸馏任务上远好于 Llama 或 Math 专用模型——因为后者的先验分布可能已经排斥了这些“不确定”的表达。
5. 总结与展望
这篇文章为我们提供了一个审视 LLM 推理的全新坐标系。
- 不要盲目追求 CoT 的极简:剔除元认知言语化可能会切断模型的“纠偏信号”。
- 重视基座模型的“预热”:一个好的推理模型首先需要具备表达“我不确定”的能力。
未来的研究方向应当是如何更高效地、有针对性地强化模型的控制行为,让它在不确定性最高的时候精准地触发“顿语”,而不是漫无目的地长篇大论。
注:本文基于 2026 年最新论文分析。对于开发者而言,如何在微调中保护这些 Epistemic 信息,将是超越现有 SFT 范式的关键。