
重构还是语义?揭秘机器人世界模型的“隐空间”之争
Reconstruction or Semantics? What Makes a Latent Space Useful for Robotic World Models
本文系统性地评估了不同隐空间(Latent Space)对机器人动作条件视频扩散世界模型(LDM)的影响,涵盖了 VAE 等重构型编码器和 V-JEPA、DINO 等语义型编码器。研究发现,虽然重构型编码器在像素级指标上表现出色,但基于语义隐空间的世界模型在规划、下游策略评估(OpenVLA)以及动作恢复力方面更具优势。
TL;DR
在机器人领域,一个能生成“高清大片”的世界模型,未必是一个“好老师”。本文通过严谨的受控实验证明:语义对齐(Semantic-aligned)的隐空间比单纯追求像素重构(Reconstruction-aligned)的空间更有助于机器人学习操控逻辑。 即使 VAE 生成的画面更清晰,但在执行规划(Planning)和策略评估时,V-JEPA 或 SigLIP 等语义模型展现出了无可比拟的鲁棒性。
核心矛盾:好看的皮囊 vs. 有用的灵魂
目前机器人视频生成模型(如 Sora 类架构)大多基于 Latent Diffusion Models (LDM)。通常的做法是找一个性能强劲的 VAE,将图像压入隐空间再做预测。
然而,作者指出:像素重构并不等同于动力学理解。 一个 VAE 可能会完美还原背景的纹理,却在关键的机械臂与物体接触点(Contact Point)出现物理逻辑错误。为了验证这一点,作者对比了六种不同的编码器,试图回答:什么样的隐空间最适合机器人?
方法论:构建语义扩散世界模型 (Semantic WM)
由于语义编码器(如 DINOv2)的输出维度通常远高于 VAE(1024D vs 16D),直接进行扩散训练会导致采样不稳定。作者采用了两种策略:
- S-VAE 适配器:将高维特征压缩至 96 维的紧凑空间。
- DDT (Decoupled Diffusion Transformer):使用宽投影头直接处理原生特征。
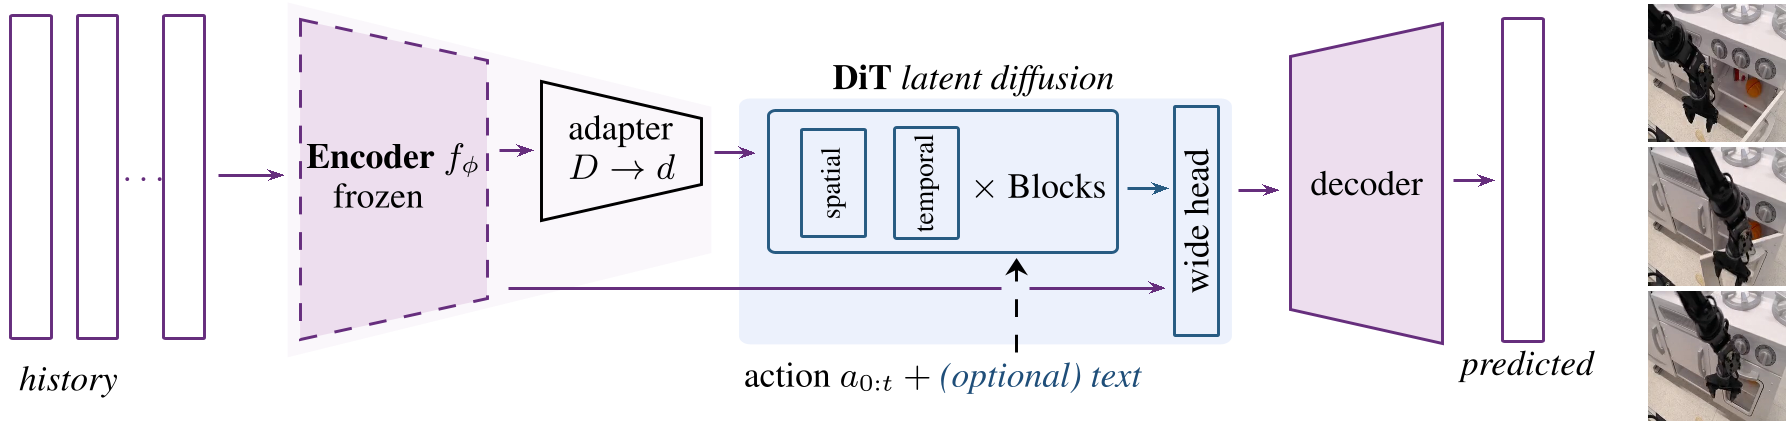 图 1: 实验流程——固定 DiT 骨架,仅更替隐空间接口,测试其对下游任务的影响。
实验洞察:三大评估维度的对撞
1. 动作恢复力 (Action Recoverability)
作者通过逆动力学模型 (IDM) 探测隐空间:仅仅给两帧隐变量,模型能猜对中间执行了什么动作吗?实验显示,语义模型(V-JEPA 2.1)的 Pearson 相关系数显著高于重构模型。这意味着:语义空间天生就对“动作引起的改变”更敏感。
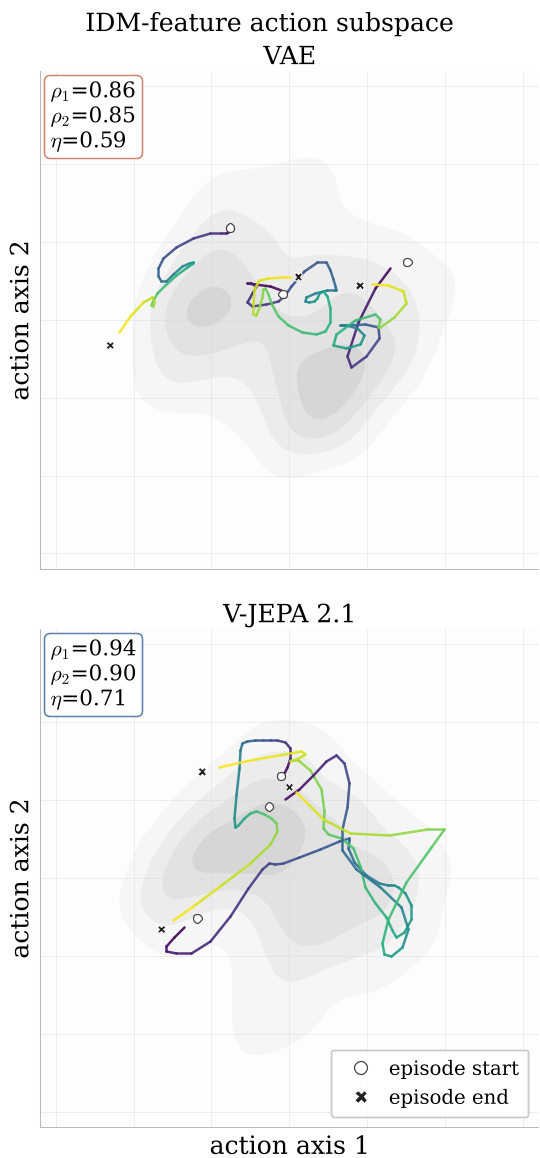 图 2: 不同编码器空间诱导的动作轨迹。语义空间(如 V-JEPA)展现出更强的动作对齐特性。
2. 策略评估 (Policy-in-the-loop)
将 OpenVLA 策略放入这些世界模型生成的“虚拟环境”中闭环运行。结果令人惊讶:VAE 虽然画面精美,但策略在其中的成功率(Success Rate)极低;而语义模型即使画面在像素级上有轻微模糊,却能引导策略完成复杂的折叠衣服、开关抽屉任务。
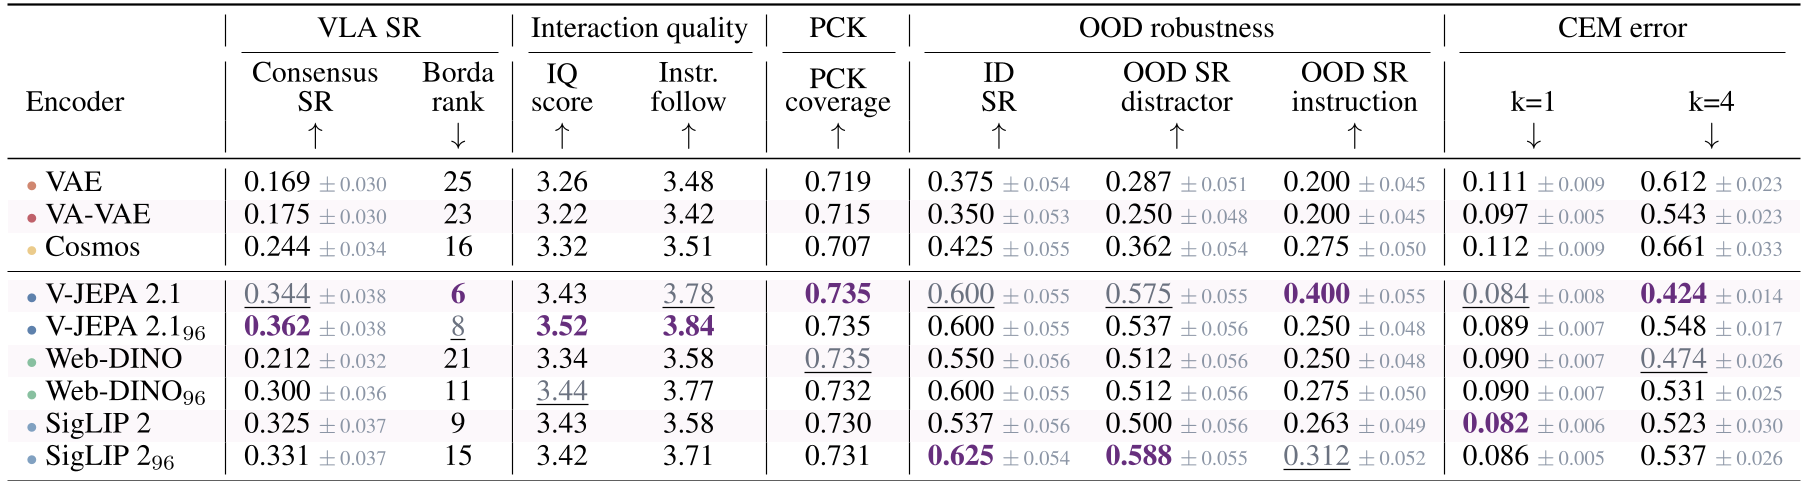 表 1: 不同编码器在 VLA 策略成功率和 CEM 规划误差上的表现。
3. OOD 鲁棒性:谁更听话?
在面对 OOD (分布外) 指令时(例如原本是“叠衣服”改为“铺平衣服”),重构模型往往会陷入死循环,继续生成之前看到的动作模式;而语义模型能够更敏锐地感知指令变化,生成符合新语义的结果。
深度思考:未来的“食谱”
作者为构建机器人世界模型提供了一套“参考路径”:
- 不要只盯着图像质量看:SSIM 或 PSNR 高不代表模型有用。
- 首选语义编码器:V-JEPA, Web-DINO 和 SigLIP 2 是目前最稳健的隐空间基座。
- 适配器权衡:适配器虽然减小了计算量,但可能会稍微损害微观动作的几何精度。
结论
这项研究有力地挑战了“像素即真理”的观念。在具身智能的语境下,隐空间的作用不仅仅是数据的压缩,更是特征的提纯。与其训练一个完美的绘图员,不如训练一个懂物理和任务逻辑的观察家。
局限性:目前实验主要集中在 BridgeV2 单一机器人平台,未来在多模态、跨机器人形态上的泛化能力还有待验证。