
[arXiv 2026] RefineAnything: 局部细节修复的终极方案,实现像素级背景锁定
RefineAnything: Multimodal Region-Specific Refinement for Perfect Local Details
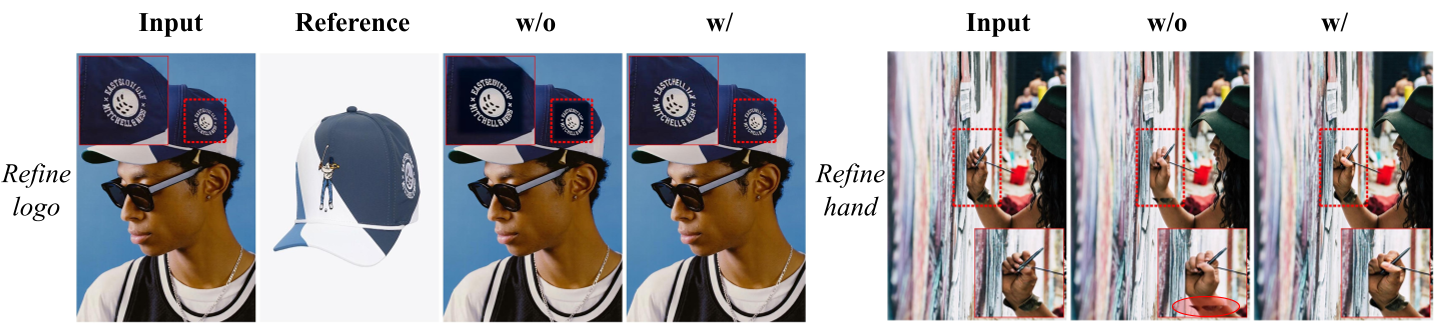
本文提出了 RefineAnything,一个专为区域特定图像细化(Region-Specific Refinement)设计的框架,旨在修复局部细节(如扭曲的文字、徽标)同时严格保持背景不变。该方法基于 "Focus-and-Refine" 策略,在固定分辨率预算下通过局部裁剪放大显著提升了 VAE 的重建质量,在 RefineEval 评测中达到了近乎完美的背景保真度。
TL;DR
在 AI 图像生成的下半场,我们不再仅仅追求“画得出来”,而是追求“画得精准”。针对图像中文字、徽标、人脸等关键局部细节经常崩溃的问题,浙江大学与哈佛大学的研究团队推出了 RefineAnything。它通过一种“反直觉”的局部聚焦策略,在不改变模型架构的前提下,实现了极高精度的局部修复,并彻底解决了“动了局部、变了背景”的行业顽疾。
痛点深挖:为何局部细节总是“画烂”?
当前的 SOTA 模型(如 FLUX, SD3, Qwen-Image)在生成宏观构图时表现惊艳,但在处理微小局部时却经常力不从心:
- VAE 的瓶颈:大多数模型在 VAE 潜空间运行。当一个文字区域仅占全图 5% 时,它在 Latent 层面的像素表达极度贫乏,解码后自然会出现笔画断裂或文字扭曲。
- 控制权的缺失:现有工具如
InstructPix2Pix往往是全局扩散,很难做到“只改这里,别处不动”。 - 背景漂移:即便是局部重绘(Inpainting),边缘处也常有突兀感,且背景色调往往会产生无法察觉但致命的偏移。
核心直觉:重新分配“像素预算”
作者提出了一个非常有意思的观察:如果你把一个模糊的局部裁剪出来,通过插值放大到 1024x1024,即便没有增加新信息,送入 VAE 后的重建效果竟然比原图更好。
这说明:问题的关键不是信息缺失,而是模型的能力被稀释了。
Focus-and-Refine 架构
RefineAnything 的核心流程分为三步:
- 局部定位(Focus):根据用户涂鸦或框选,自动扩展一个 Margin 区域,裁剪并放大到模型处理的标准分辨率。
- 精准修复(Refine):利用基于 Qwen-Image 的多模态扩散模型,结合 VLM 提供的语义理解和 VAE 提供的视觉上下文,对放大后的局部进行修复。
- 无缝回贴(Paste-Back):使用一种柔化的混合掩码将修复后的局部贴回原图。

消除“边界感”:边界一致性损失
为了解决贴图容易出现的缝隙问题,团队引入了 Boundary Consistency Loss (BCL)。该损失函数会自动识别编辑区域与原始区域的交界带,并在训练时加大该区域的权重。这迫使模型在生成的过程中,主动去对齐背景的纹理和光影。
实验战绩:近乎完美的背景保持
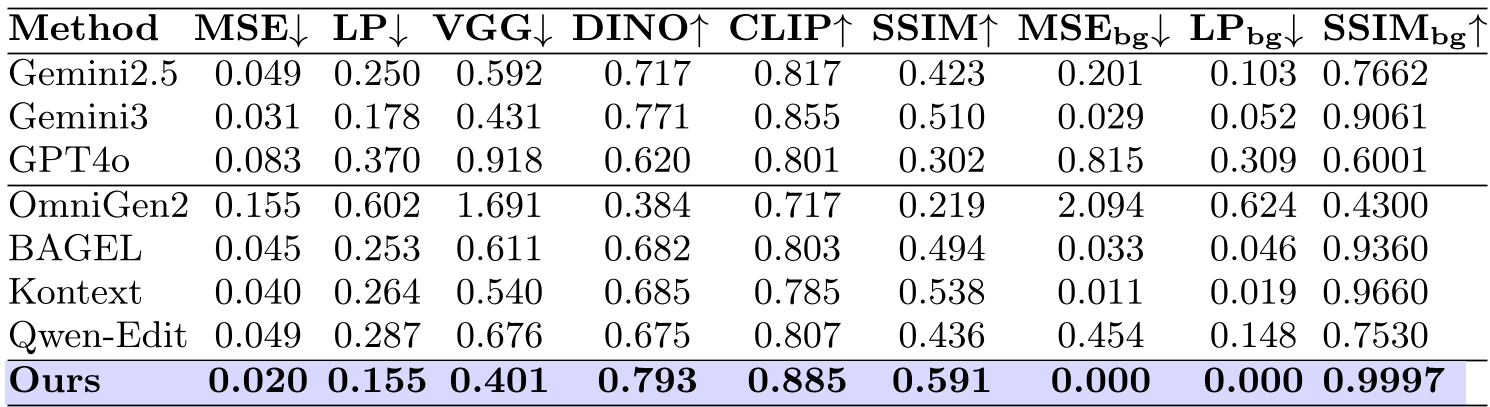
在自建的 RefineEval 基准测试中,RefineAnything 展现出了统治级的实力:
- 背景一致性:MSE_bg 降至 0.000。这意味着对于用户说“不要动”的地方,模型真正做到了物理意义上的像素不变。
- 局部保真度:在修复 Reference-based 任务(如根据 Logo 参考图修复商品上的字)时,DINO 和 CLIP 相似度大幅领先基线模型 10% 以上。
深度洞察:为什么这很重要?
RefineAnything 的出现,标志着图像编辑从“艺术创作型”向“生产工具型”的转变。在电商、UI 设计、指示牌修正等严肃场景中,这种像素级的稳定性和对微小文字的精准把控是商业落地的先决条件。
总结 (Takeaway): 该工作不仅提供了一个强力的修复工具,更揭示了扩散模型在处理局部任务时的一个重要 Inductive Bias:通过 空间重参数化(Spatial Re-parameterization) 重新对齐分辨率预算,可以极大地榨取现有模型的潜在性能。
局限性与未来
虽然该模型在静态局部修复上表现优异,但对于涉及大幅度姿态改变或大面积遮挡修复的任务,由于“回贴”机制的存在,可能会受到一定限制。未来如何将这种 Focus 机制与更复杂的全局非线性编辑结合,将是一个有趣的课题。