
ReflectDrive-2:基于离散扩散自编辑的端到端驾驶规划新标杆
ReflectDrive-2: Reinforcement-Learning-Aligned Self-Editing for Discrete Diffusion Driving
ReflectDrive-2 是理想汽车(LiAuto)提出的一种基于掩码离散扩散(Masked Discrete Diffusion)的 VLA 自动驾驶规划器。它通过目标点后验(Goal Posterior)生成行为假设,利用并行的离散 Token 解码生成轨迹,并引入 AutoEdit 机制实现原位的轨迹自编辑,在 NAVSIM 榜单上取得了 91.0 PDMS(纯视觉)和 94.8 PDMS(Oracle)的 SOTA 战绩。
TL;DR
理想汽车发布的 ReflectDrive-2 彻底改变了自动驾驶规划的“一次性”生成逻辑。它将规划过程拆解为“决策(Goal)- 草拟(Draft)- 反思(Reflect)”三个阶段。通过在离散 Token 空间内引入内置的 AutoEdit 机制,并利用强化学习(RL)将编辑过程与最终驾驶结果深度耦合,该模型在 NAVSIM 纯视觉任务中刷新了纪录,且在 NVIDIA Thor 平台上实现了端到端 31.8ms 的极速推理。
背景定位:从“一次性作画”到“反复微调”
目前的端到端规划器(如 UniAD, VAD 等)大多像是在进行一次性的“盲画”,一旦模仿学习产生的偏差累积,模型很难在同一帧内感知并修正错误。虽然基于 VLA(视觉-语言-动作)的模型引入了强大的先验,但其自回归解码的特性使得“修改”成本极高。
ReflectDrive-2 的核心直觉在于:规划错误往往是有规律的。要么是纵向冲过头了,要么是横向压线了。那么,能不能让模型先画个草图,然后自己识别出这些规律性错误,并在同一空间内进行“修笔”?
核心架构:决策-草拟-反思 (Decision-Draft-Reflect)
ReflectDrive-2 采用了一个统一的离散 Token 底座,将视觉、指令、状态和轨迹全部 Token 化。
- 目标决策(Decision):模型先预测一组离散的目标点(Goal Points),每个点代表一个行为假设(如左转、跟车、超车)。
- 并行草拟(Drafting):基于目标点,通过掩码离散扩散(Masked Discrete Diffusion)并行生成初始轨迹。
- 原位反思(AutoEdit):这是本作的精华。模型不需要额外的修正网络,直接利用当前的轨迹 Token 作为输入,识别潜在风险并原位重写 Token。
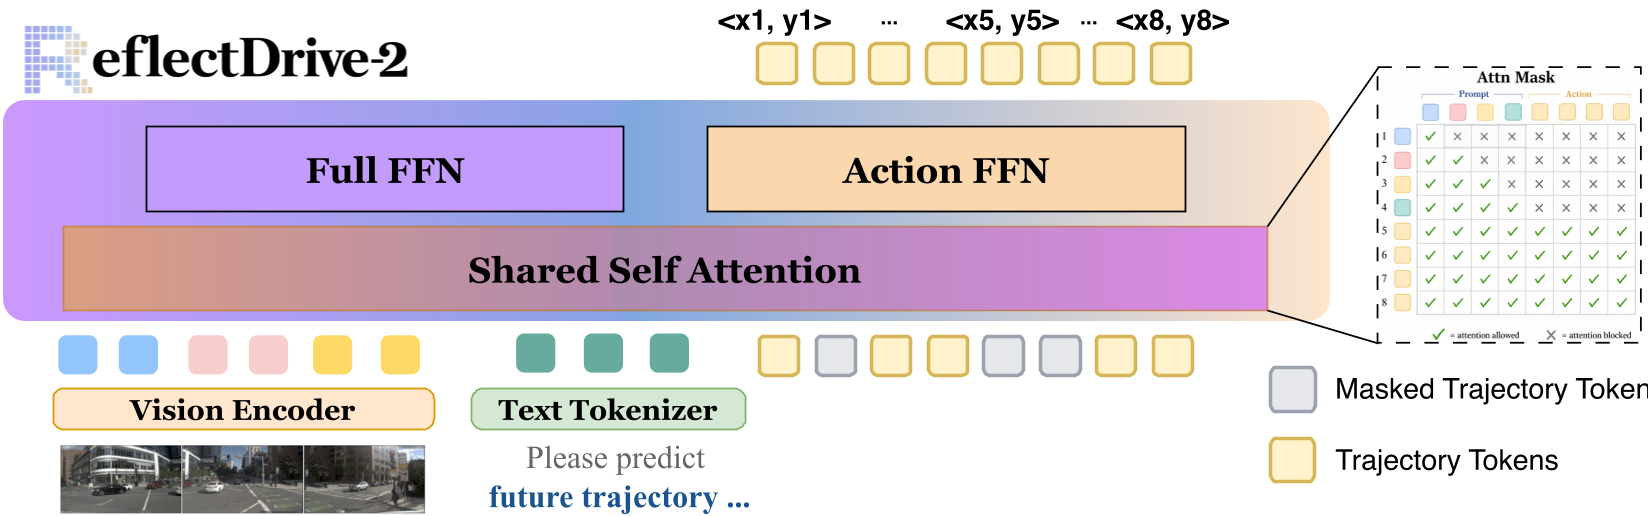 图 1:ReflectDrive-2 架构,展示了共享后端的 Vision/Language/Action 处理流程及其因果掩码模式。
技术突破 1:为什么 RL 是 AutoEdit 的灵魂?
作者发现,如果只用监督学习(SFT),AutoEdit 对性能的提升微乎其微(仅 0.3 PDMS)。原因在于:草拟器不知道编辑器能改什么,编辑器也不知道改了之后对闭环驾驶效果有什么实质帮助。
ReflectDrive-2 引入了全流程 RL 耦合优化:
- 它将“草拟+编辑”视为一个完整的马尔可夫链。
- 奖励信号(R)只在编辑完成后给出。
- 通过策略梯度,奖励会同时回传给生成器和编辑器。
这种耦合迫使生成器生成“易于精修”的初稿,并让编辑器学会为了更高的闭环得分(而非单纯的 Token 准确度)去调整轨迹。这一改进直接将 AutoEdit 的增益从 0.3 放大到了 1.9 PDMS。
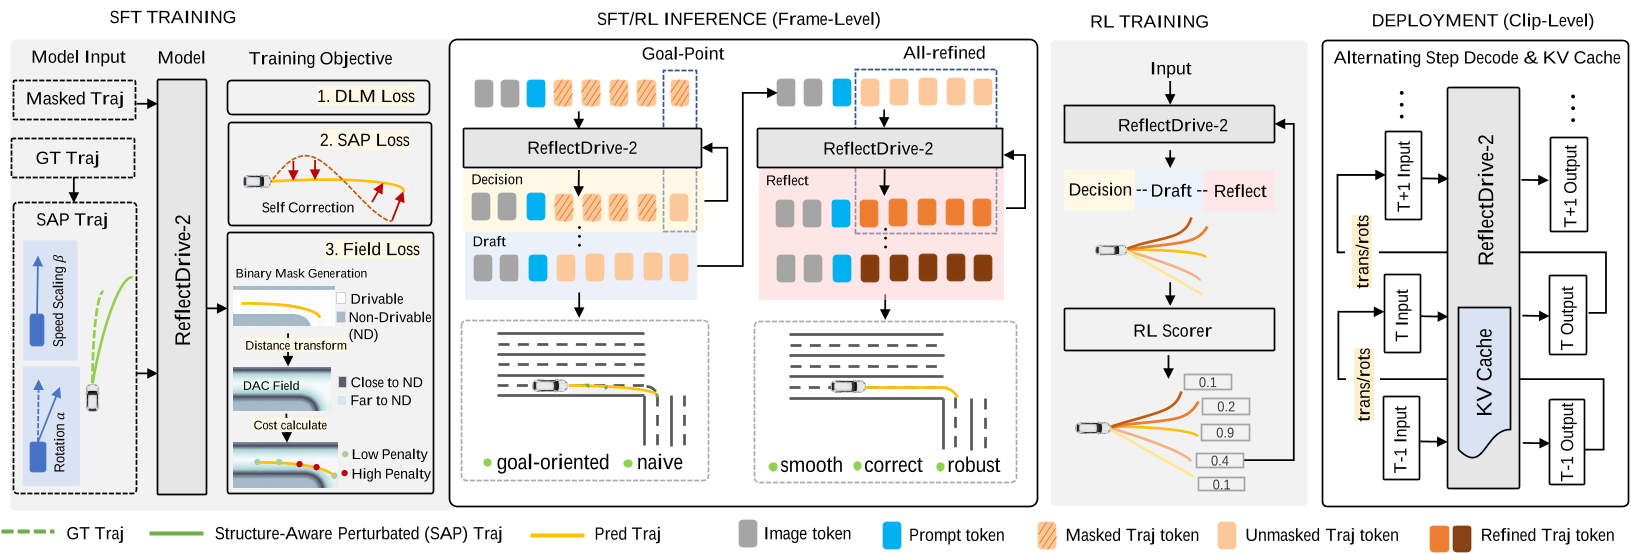 图 2:训练、推理与部署的三位一体流程。注意 RL 如何覆盖全路径的 Token 转移。
技术突破 2:针对驾驶特征的“结构化扰动”
为了训练编辑器的纠错能力,作者不仅随机 MASK,还专门针对驾驶痛点设计了结构化扰动(Structure-aware Perturbations):
- 纵向扰动:缩放轨迹的进度(模拟刹车太晚或加速过快)。
- 横向扰动:旋转轨迹(模拟转向过度或不足)。 这种“喂错”训练让模型在看到类似的偏差时能产生强烈的纠偏本能。
实验战绩:SOTA 与 实时性
在 NAVSIM 闭环测试中:
- 纯视觉 SOTA:91.0 PDMS,超越了所有已知的 Cam-only VLA 模型。
- 多目标多样性:通过 Best-of-6 Oracle 选择,得分飙升至 94.8,达到了人类驾驶水平的参考值,证明了其目标后馈预测的有效性。
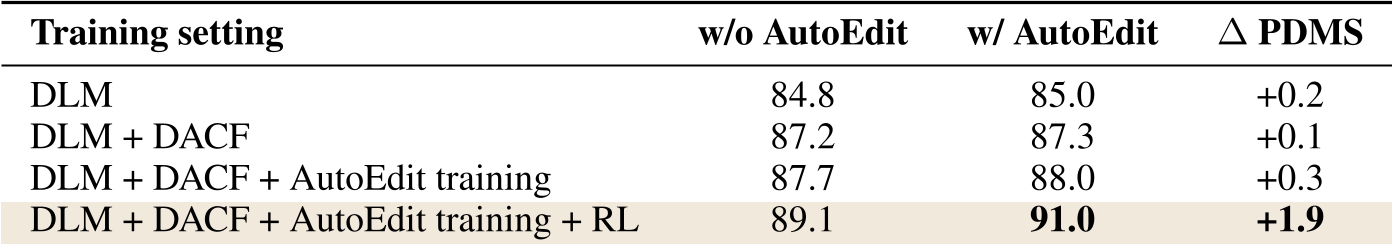 表 1:RL 对 AutoEdit 性能的巨大放大效应对比。
此外,为了解决扩散模型推理慢的通病,ReflectDrive-2 采用了 ASD (Alternating Step Decode)。它将相邻帧视为时间上的编辑器,新的一帧不需要从头生成,而是对上一帧轨迹进行空间变换后,直接用 AutoEdit 进行精修。这使得在高性能车载芯片上的运行速度大幅提升。
总结与洞察
ReflectDrive-2 的成功证明了:在自动驾驶领域,“能够后悔”的离散扩散架构比“一板一眼”的自回归模型更具潜力。
但我们也应看到其局限性:依赖固定分辨率的 BEV 网格 Token 会限制轨迹的绝对空间精度。未来如果能结合连续残差回归与离散编辑,可能会进一步提升控制的细腻度。对于追求极致闭环鲁棒性的端到端研究者来说,ReflectDrive-2 提供的“生成-反思”闭环框架是非常值得复现和深挖的范式。