
RELO:告别热图,用强化学习解锁目标跟踪的“直觉”定位
RELO: Reinforcement Learning to Localize for Visual Object Tracking
本文提出了 RELO,一种基于强化学习的视觉目标跟踪定位方法。该方法将目标定位建模为马尔可夫决策过程(MDP),通过强化学习直接优化跟踪评价指标(IoU 和 AUC),在 LaSOT 榜单上取得了 75.1% 的 SOTA AUC 成绩。
TL;DR
传统的视觉目标跟踪器(Visual Object Tracking)通常通过预测“热图”(Heatmap)来寻找目标。然而,热图是人造的代理标签,并非跟踪的最终评价标准。本文介绍的 RELO 转变了思路:它不再猜测热图,而是将定位建模为一个马尔可夫决策过程 (MDP)。通过强化学习直接优化 IoU 和 AUC 奖励,RELO 在多个权威榜单上刷新了记录,证明了“奖励驱动”比“先验驱动”更具鲁棒性。
核心速览
- 定位范式转移:从“拟合预设分布”转向“探索高奖励动作”。
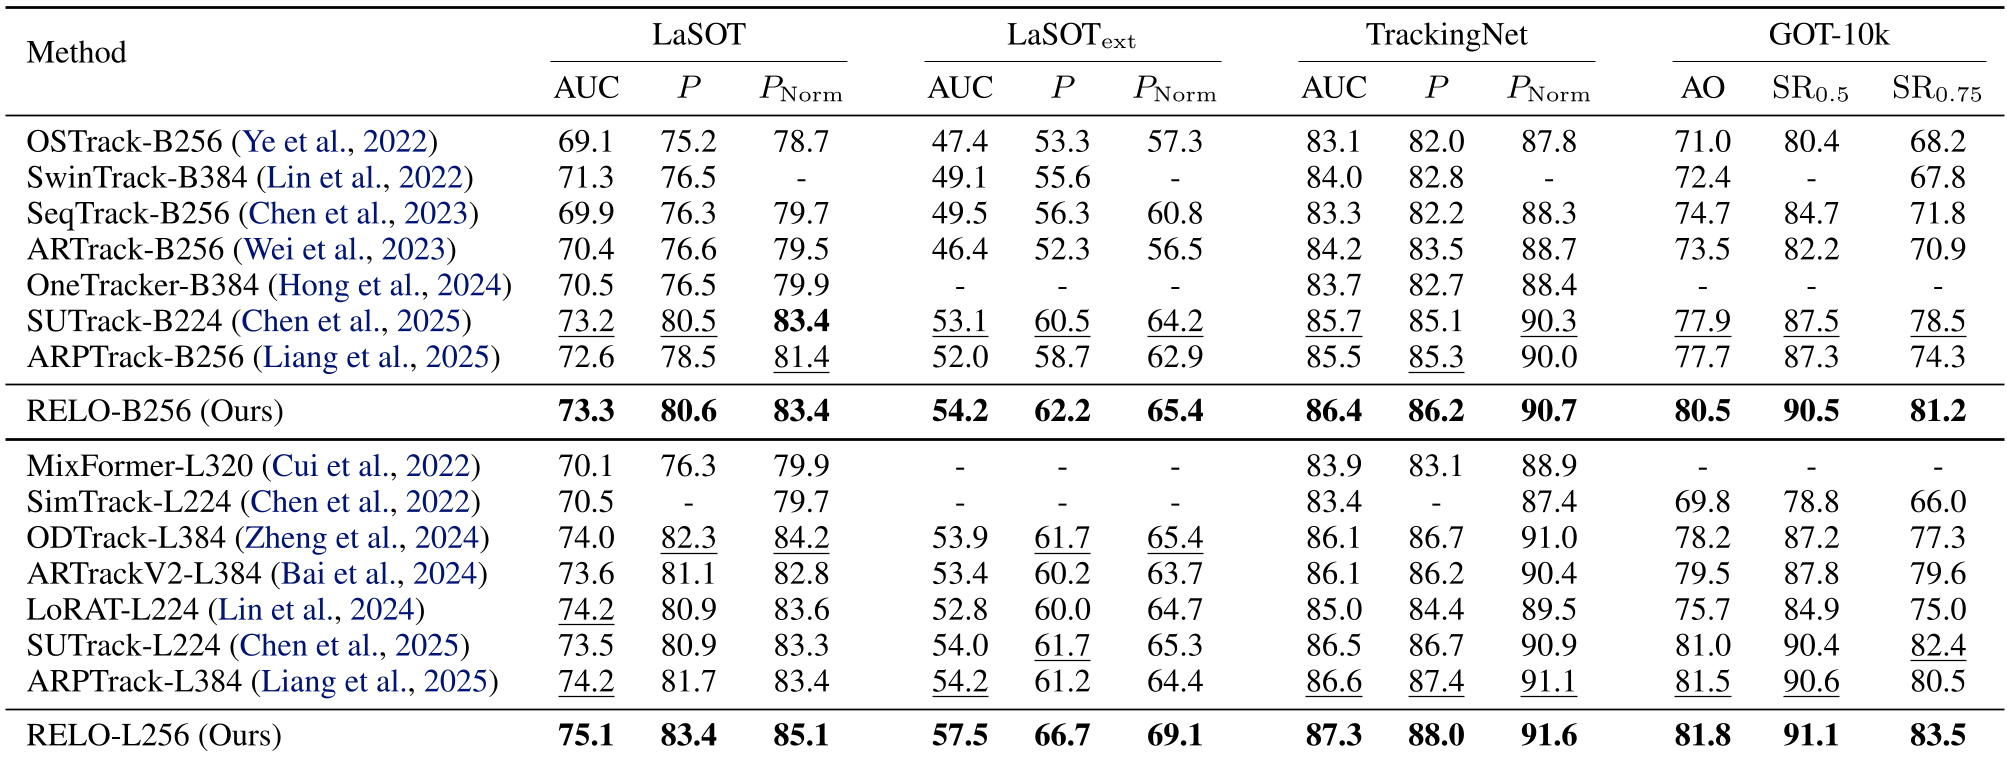
- 关键性能:在物理属性极具挑战的 LaSOText 上取得 57.5% AUC,领先当前主流 Transformer 跟踪器。
- 技术坐标:属于 One-stream Transformer 架构的进阶改良,首次深入将 RL 集成为定位的核心驱动力,而非简单的框微调。
痛点深挖:热图的“谎言”
在目标跟踪领域,SOTA 模型(如 OSTrack, MixFormer)大多依赖手工设计的空间先验(Handcrafted Spatial Priors)。
- 评价不一致:我们在训练模型预测一个高斯分布的中心点,但测试时却在考查 IoU。这种“牛头不对马嘴”的监督信号限制了模型的上限。
- 鲁棒性陷阱:当你给模型喂了太多的“中心先验”时,一旦目标发生快速运动或暂时消失,模型往往会死板地盯着搜索区域中心,导致丢失目标后难以找回(如图 5 所示)。
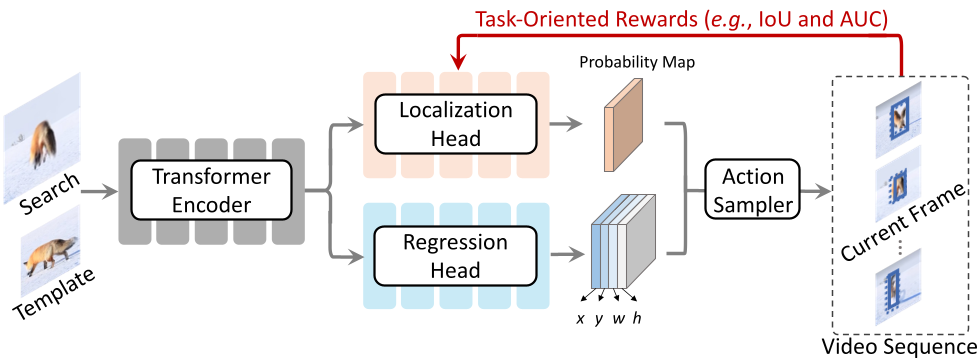 (上图展示了从先验驱动到 RL 奖励驱动的逻辑转变)
RELO 的方法论:学会“做出决定”
1. 将定位视为动作选择
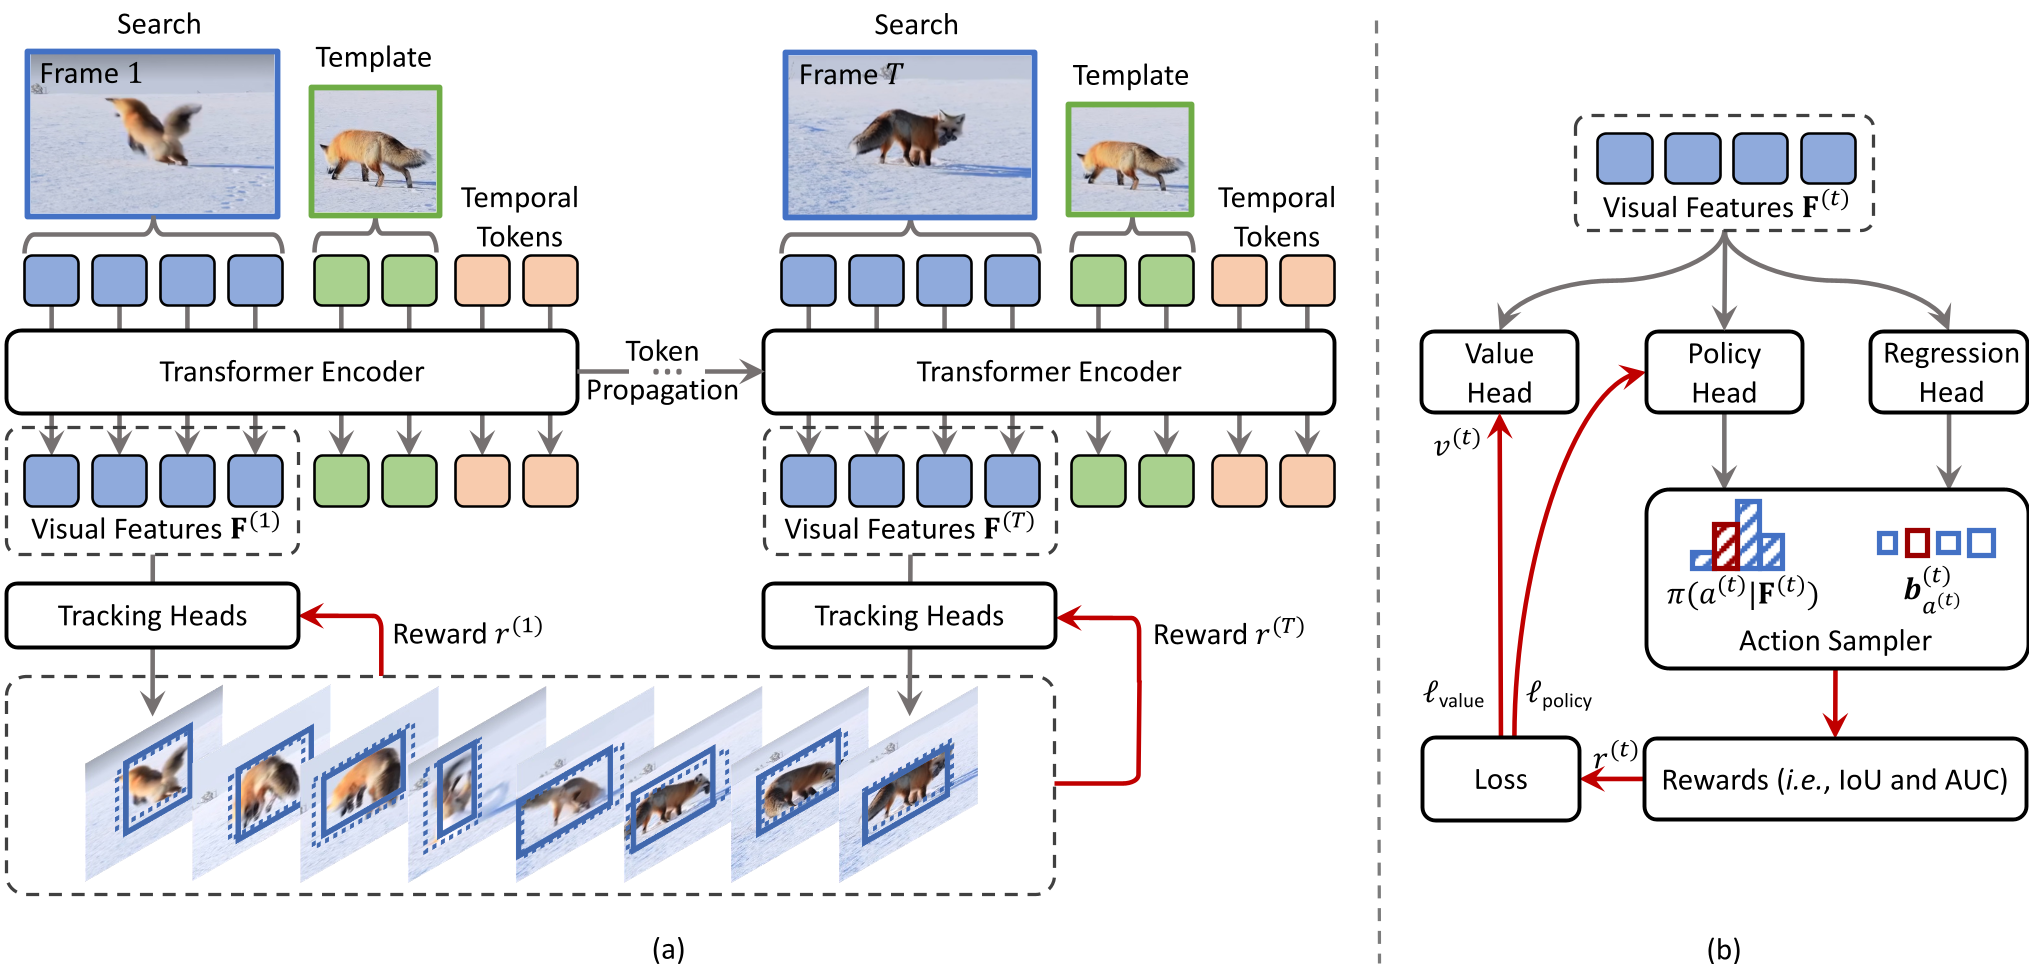
RELO 并不输出一个概率图,而是让 Policy Head 在特征图的每个空间位置上输出一个 Logit。每一个位置坐标 就是一个待选的 Action。
- Actor:选择最有潜力的定位位置。
- Regressor:针对选定的位置,预测目标的 Bounding Box。
- Reward:结合当前帧的 IoU 和整个视频序列的 AUC。这意味着模型不仅要看现在准不准,还要看这一套操作打出的“连招”是否让整段视频跟踪成功。
2. 训练的三板斧
直接从零开始 RL 是极难收敛的。作者设计了精妙的流程:
- Regression Warmup:先训练模型“如何在给定位置画框”,此时不教定位,只教回归。
- Policy Optimization:冻结回归头,开启强化学习,利用 Actor-Critic 算法通过优势函数(Advantage)更新策略。
- Layer-Aligned Token Propagation:为了让模型有“记忆”,作者将上一帧不同深度的 Token 对齐传给当前帧的对应层,避免了语义断层。
实验战绩与深度洞察
泛化能力的降维打击
RELO 最亮眼的表现是在 LaSOText 榜单上(该榜单专门测试模型从未见过的类别)。
- RELO-L256 达到了 57.5% AUC,比传统的中心先验方法高出约 3-4 个百分点。
- 原因分析:因为 RELO 学会的是根据评价指标来寻找目标的“直觉”,它不依赖特定的某种外观先验,因此在跨类别跟踪时,即便目标长得奇形怪状,只要能获得高奖励,模型就能迅速定位。
离群目标的捕获
消融实验证明,序列级 AUC 奖励(Sequence-level Reward) 是成功的关键。如果在训练中缩短序列长度(T=2),性能会大幅下降。这说明模型确实在学习一种长期策略,具备了一定的“大局观”。
总结与未来展望
RELO 的成功通过数据证明了:在视觉感知任务中,过度依赖人工设计的先验(Inductive Bias)有时会适得其反。将感知问题转化为决策问题,利用强化学习的探索特性,可以让模型在复杂、变化的现实场景中展现出惊人的生命力。
局限性: 目前的奖励函数(IoU/AUC)虽然比热图好,但处理极端遮挡和目标完全消失后的重新检测仍有提升空间。未来,将 RL 扩展到多目标跟踪(MOT)中的 ID 匹配及复杂系统控制,将是视觉跟踪领域的一个极具吸引力的方向。