
ReActor:基于双层强化的物理感知运动重定向,让机器人告别“滑步”与“穿模”
ReActor: Reinforcement Learning for Physics-Aware Motion Retargeting
本文提出了 ReActor,一个基于双层优化(Bilevel Optimization)和强化学习(RL)的物理感知运动重定向框架。该方法能将人类动作高质量地迁移到不同形态的机器人(如双足、四足)上,在 Unitree G1 等平台上不仅消除了足部滑动和穿模,还显著提升了下游模仿学习的成功率。
TL;DR
迪士尼研究院(Disney Research)推出的 ReActor 框架,通过引入物理仿真和双层优化(Bilevel Optimization),解决了运动重定向中长期存在的物理不一致问题。它不仅能让机器人精准模仿人类动作,还能自动修复动画数据中的“足部滑动”和“身体穿模”等缺陷,为机器人模仿学习提供高质量的“教科书级”参考数据。
背景:重定向的物理鸿沟 (The Embodiment Gap)
在人形机器人领域,模仿学习(Imitation Learning)是获取灵巧动作的关键。通常我们会先将人类的 Mocap 数据“重定向”到机器人的骨架上。然而,由于机器人与人类的质量分布、关节限位和形态差异极大,传统的几何重定向方法极易产生以下问题:
- Physical Inconsistencies:动作看起来很合理,但在仿真里会摔倒。
- Artifacts:著名的“凌波微步”(Foot Sliding)和身体自穿模(Self-penetration)。
这些错误的参考信号会给下游的 RL 训练带来巨大噪声,导致策略难以收敛或在真机上表现糟糕。
核心机制:双层优化 (Bilevel Optimization)
ReActor 的核心洞察在于:不应将重定向与控制分离。它将问题定义为一个嵌套的优化过程:
- 底层 (Lower-level):强化学习策略 学习如何控制机器人在物理引擎中跟踪当前的参考动作。为了处理某些极其困难的动作(如倒立),允许使用微小的残差力(RFC)。
- 顶层 (Upper-level):优化重定向参数 (包括局部坐标偏移和旋转)。它观察底层的模拟结果,如果发现机器人跟不上或动作扭曲,就调整映射关系,使参考动作更符合机器人的物理特性。
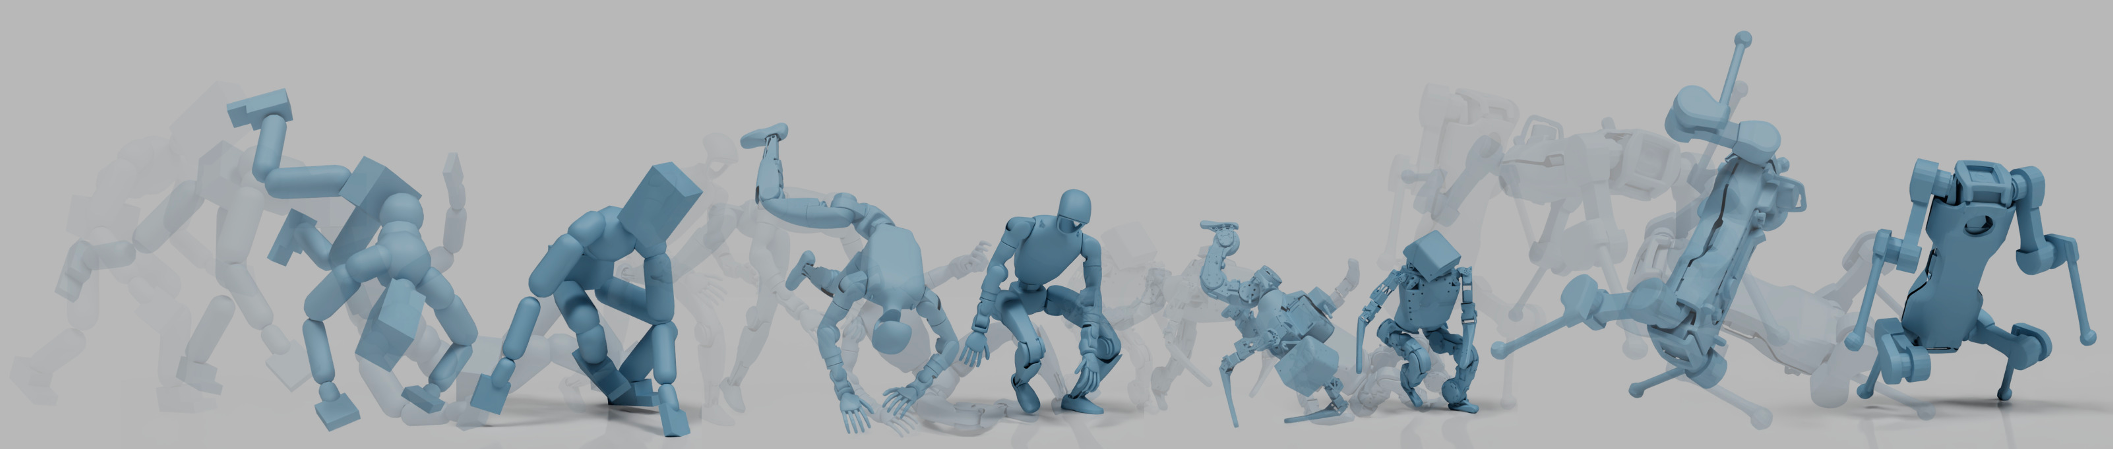 图 1: ReActor 支持将人类动作重定向到不同尺度的双足机器人及四足机器人 ANYmal 上。
梯度估计的数学直觉
传统的双层优化需要计算隐函数导数,这涉及到昂贵的 Hessian 矩阵逆运算。ReActor 的作者提出了一个极简的梯度估计: 他们直觉地假设底层 RL 策略对参考动作的改变是“部分自适应”的( 因子),从而绕过了复杂的敏感度分析,使得在大规模数据集(如 AMASS)上进行端到端优化变得可行。
实验战绩:全方位的 SOTA
作者在 Unitree G1 和 Lima 机器人上进行了详尽对比。
1. 物理质量的质变
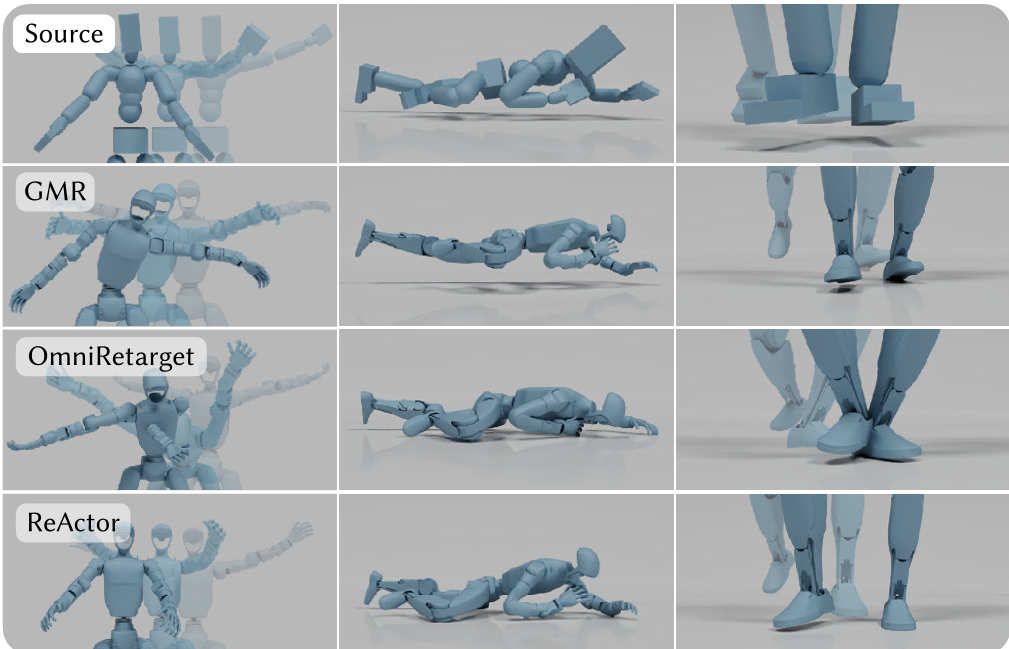
对比 GMR 和 OmniRetarget 等 SOTA 方法,ReActor 在保持运动特征的同时,实现了:
- 地面/自穿模时间绝对清零(Time=0.00)。
- 足部滑动速度显著降低:从 2.00 cm/s 降至 0.17 cm/s(在 G1 上)。
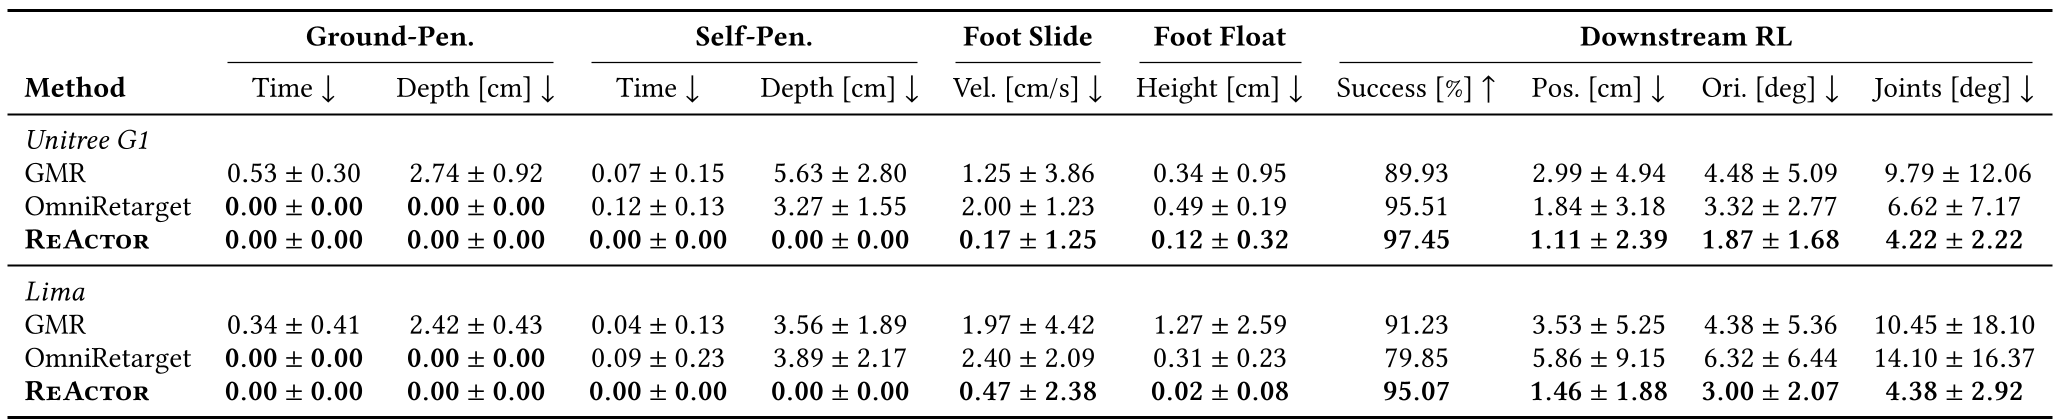 表 1: 定量对比显示,ReActor 在物理指标和下游 RL 成功率上全面领先。
2. 消融实验:双层优化的必要性
如下图所示,开启双层优化后(橙色线),跟踪奖励(Tracking Reward)明显高于静态参数下的表现。这证明了模型能够通过迭代,找到最适合当前机器人硬件的运动映射参数。
深度洞察:为什么这很重要?
- Inductive Bias 的引入:通过将控制策略放入重定向回路,ReActor 实际上将“物理可行性”作为一种归纳偏置注入到了动作映射中。
- Sim-to-Real 的助推器:在 Lima 机器人上的真机部署证明,由于重定向过程已经考虑了物理约束,这种方法生成的策略具有极强的现实迁移能力。
- 局限性:目前重定向参数在单条序列内是固定的。对于某些高度动态变化的动作,未来可能需要引入时间相关的(Time-varying)参数优化。
总结
ReActor 为机器人动画和控制提供了一个优雅的闭环方案。它告诉我们,最高质量的运动数据不是“调”出来的,而是通过物理仿真“炼”出来的。对于追求完美动作表现的人形机器人团队来说,这是一个非常值得复现的 Baseline 线。