
Render, Don’t Decode:NOVA 开启权重空间世界模型新范式
Render, Don't Decode: Weight-Space World Models with Latent Structural Disentanglement
本文提出了 NOVA (Neural Ontology for Visual Abstraction),一种全新的权重空间世界模型框架。该方法将系统状态表示为辅助隐式神经常微分表示 (INR) 的权重和偏置,通过分析化渲染取代传统的像素解码器,在 Moving MNIST 和 PhyWorld 等数据集上实现了高效、可解释且支持零次学习超分辨率 (Zero-shot Super-resolution) 的视频预测。
TL;DR
传统的视频生成和世界模型习惯于“编码-压缩-解码”的套路,但这种方式往往让模型背负着沉重的解码器负担,且 Latent 空间像个黑盒。今日发表的 NOVA (Neural Ontology for Visual Abstraction) 提出了一种大胆的替代方案:直接在权重空间 (Weight-Space) 演化动力学。通过将每一帧图像视为一个隐式神经表示 (INR) 的参数集合,NOVA 实现了真正的背景、内容与运动的结构化解耦,并原生支持任意分辨率的渲染。
背景定位
目前 SOTA 的世界模型(如 Dreamer, Genie)大多基于补丁 (Patch) 或 Token。NOVA 则另辟蹊径,属于权重空间学习 (WSL) 的演进。它的核心直觉是:如果一个神经网络(INR)可以代表一张图像,那么预测视频就是在这个 INR 的参数空间内寻找一条演化轨迹。
痛点深挖:解码器的“紧箍咒”
- 资源冗余:在大规模视频分词器中,解码器往往占据了高达 87% 的参数,这限制了模型的可部署性。
- 分辨率锁定:一旦训练完成,解码器的输出维度就固定了,想看 4K 画质?只能重新训练或依赖后期 Upsampling。
- 解耦困难:在抽象的 Latent 向量里,你很难通过手动修改某个维度来单独改变“物体颜色”而不影响“运动轨迹”。
NOVA 架构解析:三层本体论的优雅解耦
NOVA 通过一个简单的加法结构构建了其核心动力学:
- 基准锚点 ():全局共享,负责吸收静态背景(如图 11 所示的 Moving MNIST 黑色背景)。
- 内容偏移 ():编码前景物体的 Identity(它是“5”还是“1”)。
- 动作信号 ():由逆动力学模型 (IDM) 提取,专门控制物体位移。
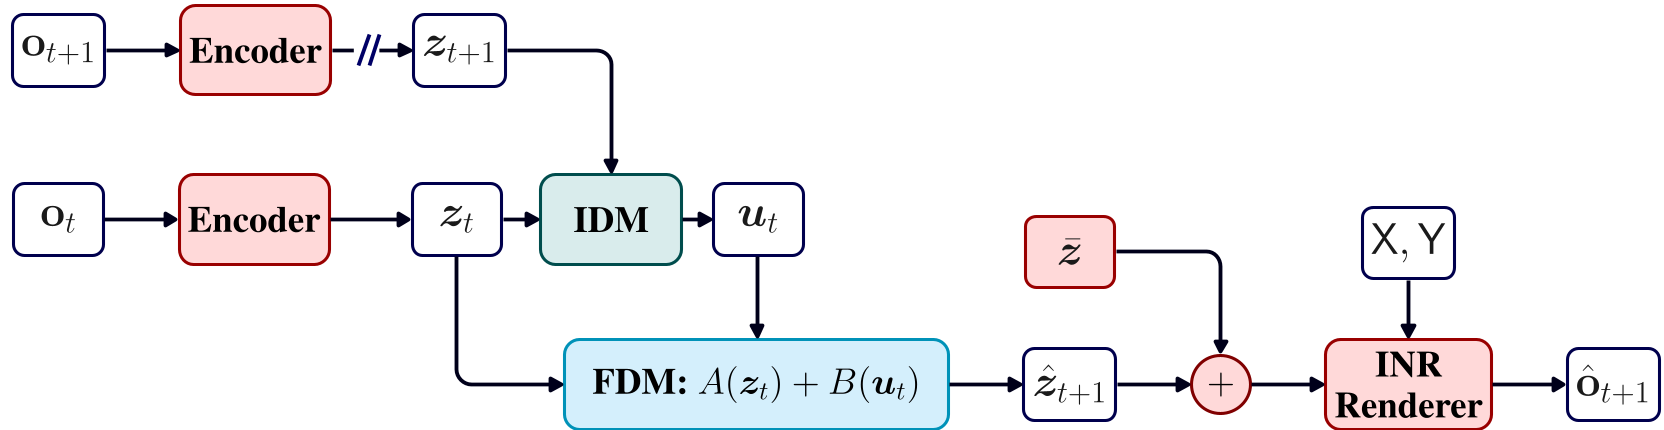 NOVA 架构:Encoder 映射到权重偏移,渲染器则是无参数的分析函数。
这种设计的妙处在于:所有的渲染都是“算”出来的,而不是“猜”出来的。渲染器 (Renderer) 不需要训练,它就是一个带有 Fourier Feature 的多层感知机。
实验战绩:长期主义与零次超分
1. 1000 步长期预测不崩坏
在 Moving MNIST 实验中,传统 baseline 到后期往往会陷入“平均模糊”(像素均值化)或彻底“黑屏”(LAPO 崩溃)。而 NOVA 因为在权重空间操作,能始终保持物体边界的尖锐度和身份的一致性。
 长期预测指标对比:NOVA 在 median SSIM 和 JSD 距离上展现了极强的防御能力。
2. 零次学习超分辨率 (Zero-shot Super-Resolution)
在 WeatherBench 地球大气温度预测任务中,NOVA 展示了其连续场表示的威力。即使训练在 32x64 的极低分辨率下,推理时只需改变坐标查询的密度,即可获得极其平滑的高清气流图,且无混叠伪影(Aliasing)。
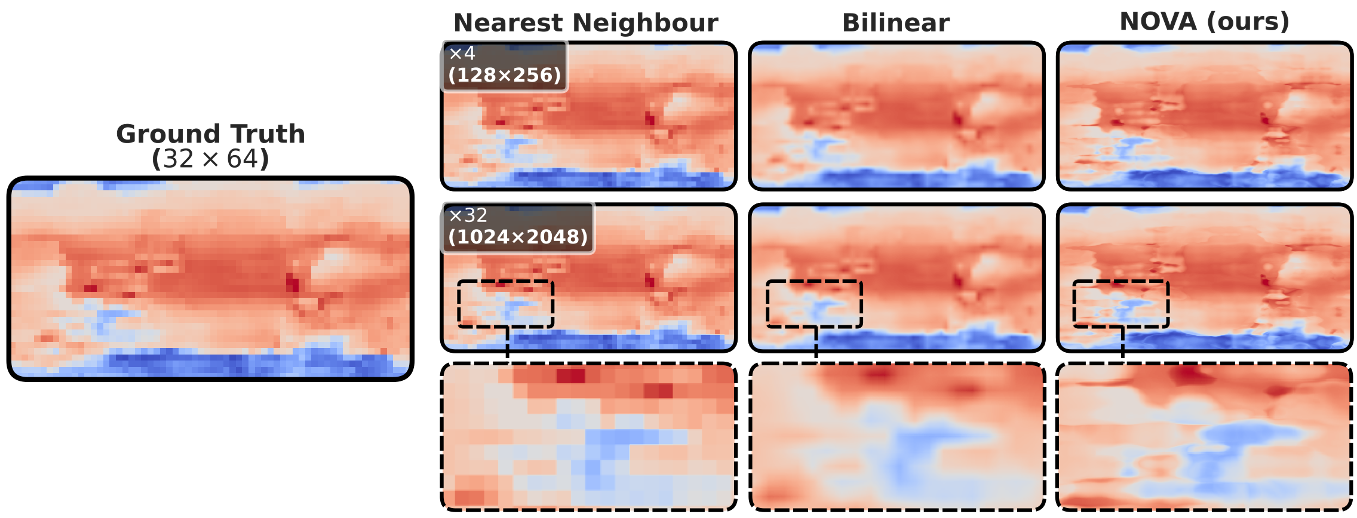 NOVA 与双线性插值对比:在 32x 缩放时,NOVA 依然能保持宏观结构的准确性和连贯性。
深度洞察:物理一致性的“意料之外”
在 PhyWorld 刚体碰撞测试中,研究者发现了一个惊人的现象:如果强行把“小球 A”的 identity 注入到“小球 B”的演化路径中,NOVA 会自动根据新 identity 的物理参数(如半径、质量)实时更新碰撞后的速度。这说明模型并没有死记硬背像素移动,而是捕捉到了潜藏的物理定律。
局限性与未来展望
尽管 NOVA 在解耦和超分上表现惊艳,但它仍面临“隐性相关”的问题——例如在某些情况下,改变物体内容会轻微影响到 y 轴位置,这说明权重空间的完全解耦仍需更强的正则约束。作者指出,未来引入微分方程(ODE/PDE)结合权重空间学习,将是通往“物理 AI”的下一站。
总结
NOVA 告诉我们:世界模型不一定非要通过解码像素来“理解”世界。 通过利用 INR 的结构化特性,我们可以在权重空间中实现既轻量又可控的动态演化。对于数字艺术家和地球物理学家来说,这种“所见即所参数化”的模式将开启全新的创作与预测范式。