
REASONMAXXER:推理提升不需要重型 RL,只需在关键决策点“拉一把”
Rethinking RL for LLM Reasoning: It's Sparse Policy Selection, Not Capability Learning
本文提出了 REASONMAXXER,一种针对大语言模型(LLM)推理能力的极简后训练方法。该研究指出,强化学习(RL)对推理能力的提升本质上是“稀疏策略选择”而非“能力获取”,据此通过仅在少量高熵决策点进行对比微调,实现了与全量 RL 相当的性能。
TL;DR
在学术界和工业界疯狂卷 RL(强化学习)算力时,南加州大学的一项最新研究泼了一盆冷静的凉水。论文指出:RL 并没有教给模型新本事,它只是在模型犹豫不决的“岔道口”推了一把。 基于这一发现,作者提出了 REASONMAXXER,仅需几美元的单机算力、几十个题目,就能在数学推理任务上干掉那些烧了数十万美金算力的全量 RL 方案。
核心直觉:RL 到底在改什么?
传统的观念认为,RL 像是在下围棋一样让模型通过自我博弈发现“新策略”。但本文的分析显示,这纯属过度解读。
通过对 Qwen、DeepSeek 等模型在 RL 前后的 Token 级别对比,研究者发现了三个惊人的事实:
- 修改极度稀疏:RL 实际上只改变了 1% 到 4% 的 Token 选择。
- 极其保守:RL 选中的 Token,竟然 100% 都在基座模型原本预测的 Top-5 候选词里。也就是说,模型“本来就想过要这么写”,RL 只是确认了眼神。
- 热点集中:这些修改点都精准地落在基座模型原本就“熵很高”(即非常不确定)的决策位置。
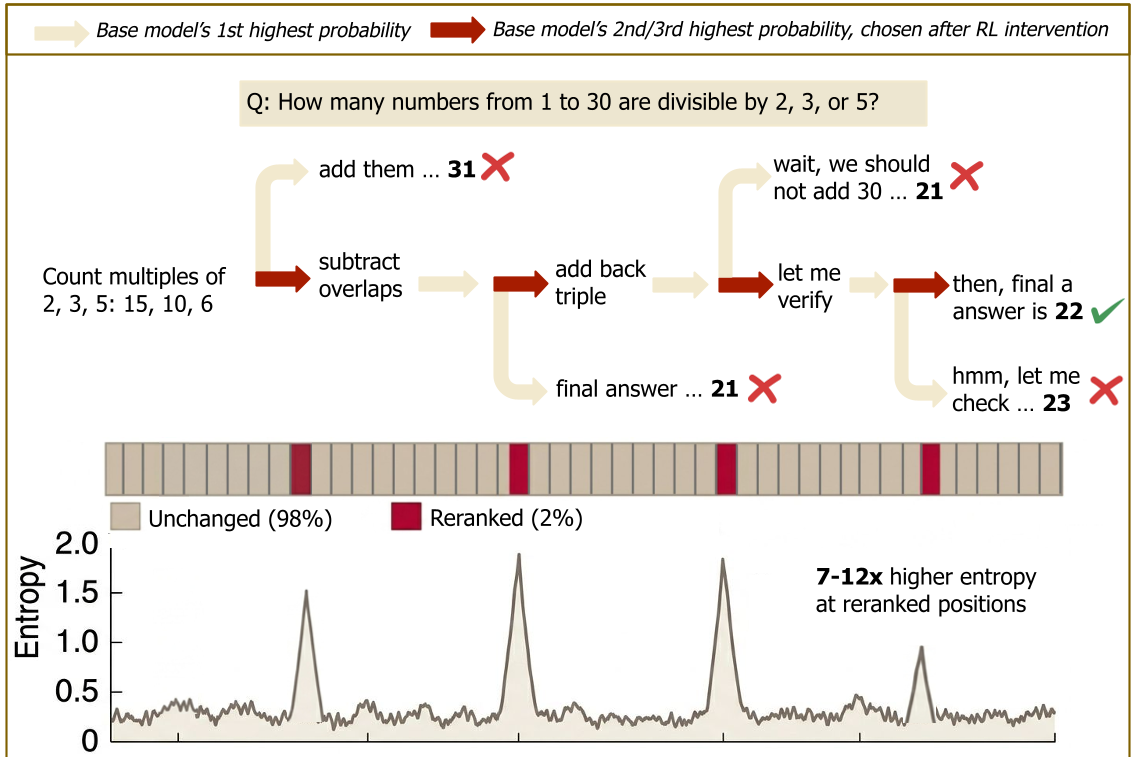 图 1:RL 的修改集中在高熵点,且基本不引入 Top-5 之外的新词。
技术秘密:REASONMAXXER 的精准打击
既然 RL 的工作只是在关键时刻做“选择题”,那我们为什么还要费力去跑庞大的 PPO 或 GRPO 框架?
REASONMAXXER 的流程简单得令人发指:
- 筛选边缘题目:只选那些基座模型“有时能做对,有时会做错”的题目。因为如果全对或全错,就没有对比学习的信号。
- 熵门控定位 (Entropy Gating):不需要老师模型,直接看基座模型自己的熵。哪里熵高,哪里就是我们要优化的“决策点”。
- 对比微调 (Contrastive FT):在这些决策点上,如果这条路径最后通向了正确答案,就增加它的概率;如果通向错误,就减小它。
- 基座锚定 (Base Anchoring):在其余 97% 的位置,强迫模型保持和基座一模一样。
这种做法在参数空间也是极简的,仅仅通过一个秩(Rank)为 32 的 LoRA 适配器(占总参数量不到 0.5%)就吸收了 RL 的所有红利。
实验战绩:极致的性价比
研究者在 6 个数学推理基准测试(如 MATH-500, GSM8K, AIME)上进行了测试。结果显示,REASONMAXXER 在 Qwen2.5-7B 上的表现几乎等同于甚至超过了使用全量 GRPO 训练的版本。
最震撼的是成本对比:
- Open-Reasoner-Zero (RL): 耗资约 $6,300。
- REASONMAXXER: 耗资约 $5。
这是三个数量级(1000倍)的效率提升。
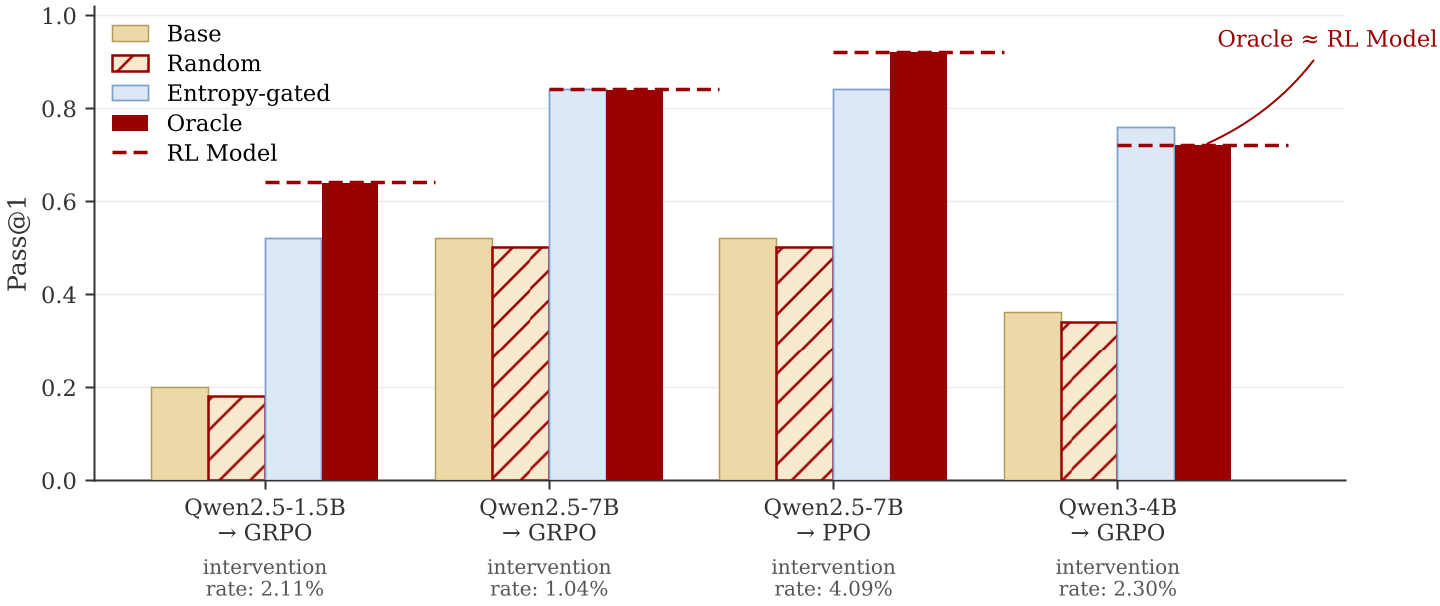 图 2:简单的熵门控干预(红色)就能追平昂贵的 RL 模型(虚线)。
深度思考:重型 RL 是否过誉了?
这项研究给当前的“推理模型热”提了一个醒。如果 RLVR(可验证奖励的强化学习)在推理任务中扮演的角色仅仅是稀疏策略选择(Sparse Policy Selection),那么我们可能高估了 RL 在后训练阶段“创造新知识”的能力。
局限性分析: 虽然 REASONMAXXER 在数学、代码等结果可验证的任务上表现优异,但如果任务本身没有明确的判断标准(如创意写作),这种基于结果的对比信号就会变得模糊。此外,这种方法极度依赖基座模型本身的“潜力”,如果基座模型在采样中一次都做不对,这种方法也无从谈起。
总结
REASONMAXXER 告诉我们,LLM 就像一个聪明的学生,他其实知道怎么解题,只是在某些关键步骤容易犹豫。我们不需要逼他从头重学,只需要在他犹豫的时候告诉他:“相信你的第二个直觉,那是对的。”这种“轻量化”的方向,或许才是未来个人或小团队训练强推理模型的正确姿态。