
严谨的可解释性:从“事后说明”进化为“深层评估”
Rigorous Interpretation Is a Form of Evaluation
本文提出将可解释性(Interpretability)视作一种更深层次的模型评估形式。作者论证了当可解释性满足证伪性、可复现性和预测性这三大科学标准时,它不仅是诊断工具,更是超越表面性能指标、能够洞察模型内部机制可靠性的评估手段。
TL;DR
在当今追求 SOTA 榜单的 AI 浪潮中,我们是否满足于模型给出的“正确答案”?本文提出一个激进且深刻的观点:可解释性即评估(Rigorous Interpretation Is a Form of Evaluation)。作者指出,仅仅依靠 Benchmark 的准确率只是捕捉了“表面能力”,真正的评估应当深入模型机制。只有当可解释性方法满足证伪性、可复现性和预测性时,我们才能真正识别模型是“真聪明”还是“走捷径”。
1. 痛点:Benchmark 的“欺骗性”
目前的模型评估大多依赖于行为快照(Behavioral Snapshots)。例如,一个在医学影像分类上达到 99% 准确率的模型,它可能真的学会了识别病灶,也可能只是发现了扫描仪型号与病症之间的虚假关联(Spurious Correlation)。
- Prior Work 的局限:传统的静态基准测试无法解释“为什么失败”,更无法在模型给出正确输出但推理过程错误时发出警告。
- 作者的 Insight:如果可解释性能够满足科学标准,它就能将评估从“事后总结”转变为“前瞻性的机制审查”。
2. 三大支柱:可解释性如何成为评估?
作者将可解释性的评估潜力拆解为三个必经阶段:
A. 证伪性:实现精准 Debug (Falsifiability)
证伪性是指解释必须能够被实验反驳。如果你声称某个神经元代表“性别”,那么当你干预(Intervene)这个神经元时,模型的输出必须发生预期的改变。
- 成功案例:概念瓶颈模型 (CBM) 在医疗 X 光片分析中,允许专家直接修正模型依赖的内部特征,从而提高稳健性。
- 挑战:当前的稀疏自编码器 (SAE) 在干预时往往表现出不一致性,同样的特征在不同语境下表现不同,这削弱了其作为 Debug 工具的可靠性。
B. 可复现性:通过机制检测欺骗 (Reproducibility)
当评估目标本身很模糊(例如“偏见”的定义)时,可复现的解释能帮我们看透本质。以西译英翻译为例,当模型将“医生”翻译为“He”时,可解释性工具能揭示模型是基于上下文确定的性别,还是仅仅依赖“医生 = 男性”这一训练集中的虚假统计。
C. 预测性:预见未来的崩盘 (Predictivity)
这是最难的一步。科学意义上的预测意味着我们仅通过分析内部几何结构(如 Embedding 空间的线性关系),就能预测模型在从未见过的数据集上哪里会跌倒。
3. 核心架构与现状剖析
论文分析了当前主流可解释性技术在科学标准下的表现。
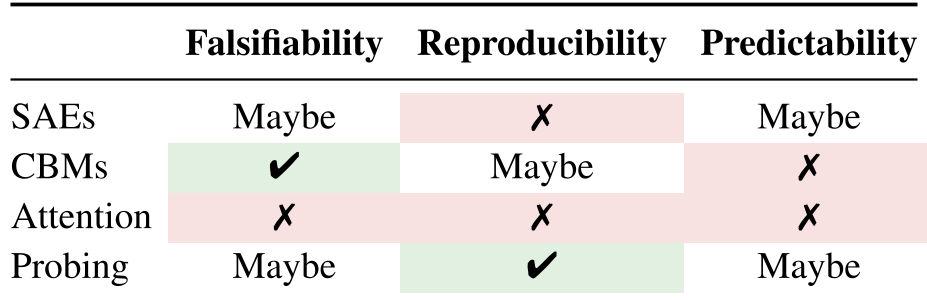
注:从上表可见,我们最常用的 Attention (注意力机制) 可视化,在证伪性、可复现性和预测性上全部折戟。这意味着“看一眼加权图”根本算不上科学评估。
4. 深度洞察:线性表示假设与几何结构
论文重点讨论了线性表示假设 (Linear Representation Hypothesis)。这一假设认为高层概念在表征空间中呈现为特定的方向。
- Why it Matters:如果这个假设成立,我们就可以通过计算子空间的对齐角度、流形偏移等几何指标,在模型部署前就预测其 OOD(分布外)的失效模式。
- 现实骨感:当模型遭遇极端异域数据时,这种线性结构会崩塌,导致所有预测性失效。这提醒我们,可解释性工具本身也需要“稳健性保证”。
5. 局限性与未来展望 (Critical Analysis)
尽管愿景宏大,但本文直言不讳地指出了稀疏自编码器 (SAE) 等当前热门工具的脆弱性:
- 数据依赖:在聊天数据上发现的“拒绝触发特征”,换到网页文本可能完全失效。
- 因果困惑:经验风险最小化(ERM)倾向于让模型学习所有能降低预测误差的特征,无论这些特征在逻辑上多么荒诞。
总结建议:研究者不应再单纯追求“易读”的概念图,而应致力于开发能够经受住因果干预和跨分布测试的可解释性方法。只有解释变得“硬核”且“可证伪”,可解释性才能从 AI 论文的配图,晋升为 AI 安全的守门人。
结语
正如论文标题所言,严谨的解释即评分。当我们不再满足于“它预测对了”,而是去追问“它为什么这么想”,AI 才真正从黑盒迈向透明。