
SCALELOGIC:逻辑表达力是解锁长程推理 LLM 的关键钥匙
Can RL Teach Long-Horizon Reasoning to LLMs? Expressiveness Is Key
本文提出了 SCALELOGIC,一个用于研究大语言模型(LLM)强化学习(RL)后训练规模效应的合成逻辑推理框架。该框架通过独立控制推理深度和逻辑表达力,揭示了 RL 训练计算量与任务难度之间的幂律关系(Power Law)。
TL;DR
强化学习(RL)已被证明能有效提升 LLM 的推理能力,但我们对其背后的“规模增长规律”知之甚少。本文引入了 SCALELOGIC 框架,首次量化了逻辑复杂度与训练成本之间的关系。核心结论:训练计算量随推理深度呈幂律增长,且逻辑越复杂,增长越陡峭。 此外,在具备“复杂逻辑”的合成数据上训练,对下游数学和通用推理任务的提升最为显著。
背景定位:逻辑推理的“可控实验”
在大模型后训练(Post-training)领域,DeepSeek-R1 等工作证明了 RL 的巨大潜力。然而,研究者们一直苦于无法在数学或代码任务中精确调节“难度”。SCALELOGIC 像是一个“逻辑实验室”,它允许我们在两个维度上拨动旋钮:
- 推理深度 (Depth):证明链条有多长?
- 表达力 (Expressiveness):是简单的“如果 A 则 B”,还是包含“并非、所有、或者”的复杂推理?
核心方法:逆向证明树构建
SCALELOGIC 的精妙之处在于它的**逆向构建(Backward Construction)**机制:
- 从结论出发:先确定一个根结论,再递归地添加前提(Premises)。
- 精确控制:根据预设的逻辑等级(如 Implication, +Conjunction, +Quantification),动态生成不同类型的逻辑规则。
- 硬核干扰:为了防止模型走捷径(Shortcuts),框架会生成多个看起来很像但逻辑不通的干扰选项,并随机篡改其中一个事实,使任务变成“多选一”的验证问题。
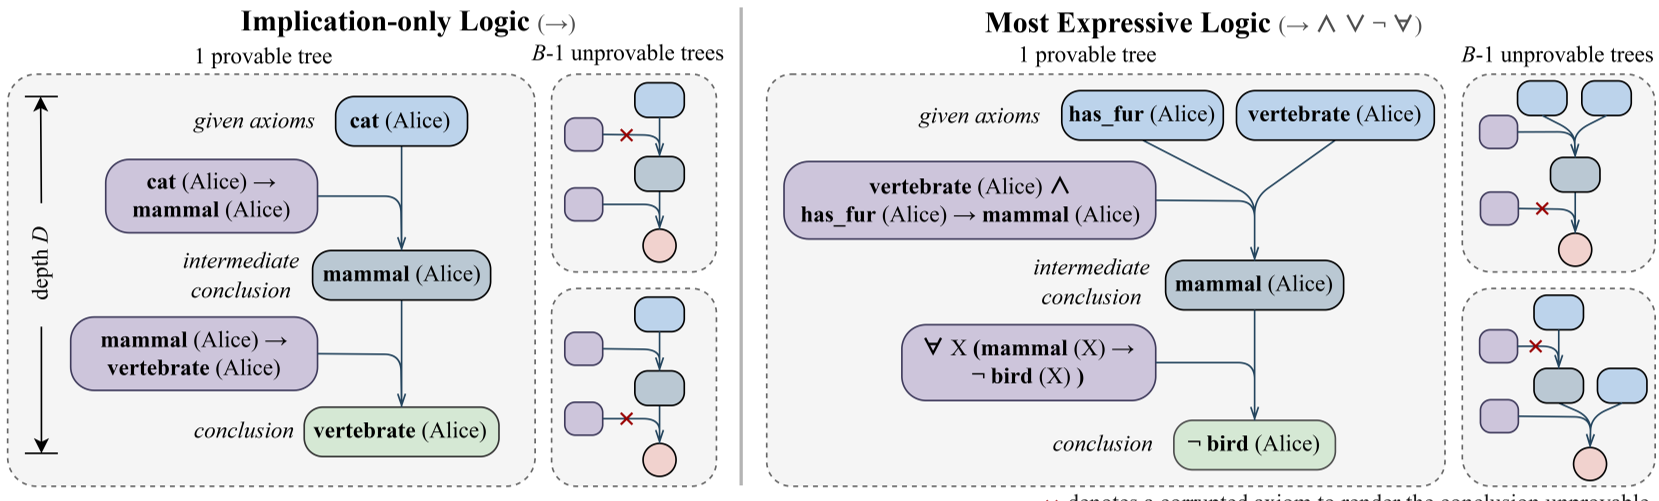 左侧为简单蕴含逻辑,右侧为包含全称量词的高级逻辑设置。
关键发现 1:训练成本的幂律法则
通过在大规模实验中拟合数据,作者发现 RL 训练步数 与证明深度 严格服从 :
- 简单逻辑 ():成本随深度线性增长。模型只需要学会“再多串联一步”。
- 复杂逻辑 ():成本呈非线性爆发。逻辑算子的引入(如“与”门、全称量词)让推理步数的叠加变得极其昂贵。
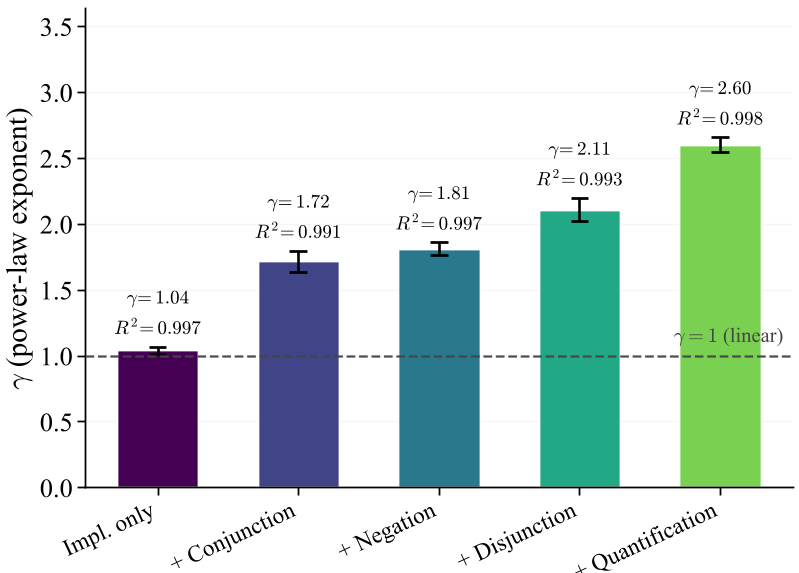 可以看到,表达力越强(+Quantification),拟合线的斜率(指数 γ)越陡峭。
关键发现 2:表达力决定迁移上限
这是一个令人振奋的结论:在合成逻辑数据上的训练能显著提升模型在 MATH-500、AIME 等真实竞赛题目上的表现。 实验显示,仅在简单逻辑上训练,下游性能会迅速遇到瓶颈;而只有在包含“全称量词(Quantification)”的复杂设置下训练,模型才表现出持续的性能增长(+10.66 分)。这说明逻辑表达力的深度直接影响了模型提取通用推理模式的能力。
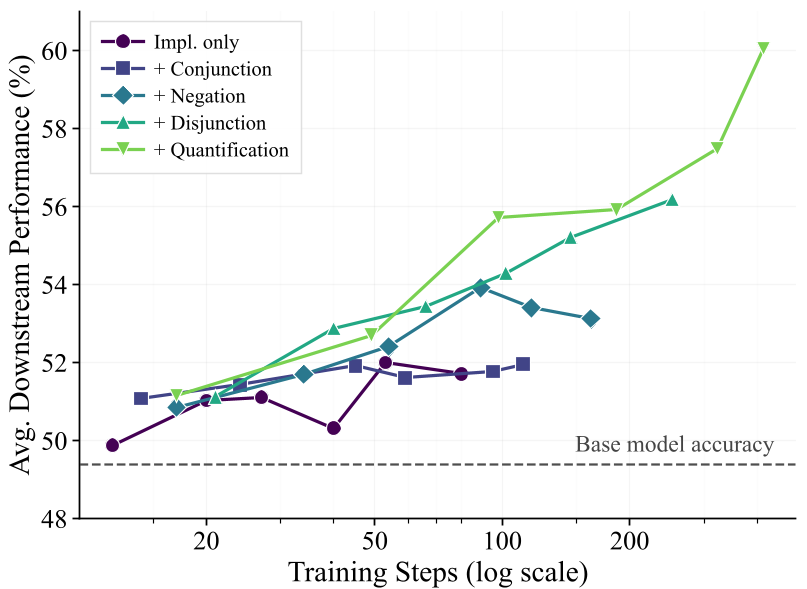 不同表达力下的下游性能迁移曲线:表达力决定了模型的天花板。
定性观察:模型变得“深思熟虑”
在对 MATH-500 的案例分析中,作者发现经过 SCALELOGIC 训练的模型展现出了更系统的分支枚举和边界验证策略。在处理复杂的对数方程时,基础模型往往漏掉分类讨论,而 RL 训练后的模型学会了像人类专家一样拆解 Case 并逐一验证约束。
深度洞察与总结
- 课程学习(Curriculum)是良药:研究发现,先从浅层深度练起,再逐步增加深度,能显著降低幂律指数 ,提高训练效率。
- 表达力即能力:这项研究告诉我们,合成数据的价值不在于“量”,而在于其中的“逻辑结构”。
- 局限性:实验目前主要在 Qwen-4B/8B 规模上验证,更大参数量下 γ 是否会改变仍待观察。
总结: SCALELOGIC 不仅仅是一个数据集,它为 LLM 逻辑能力的“工业化生产”提供了一套度量衡。它告诉我们,要教 LLM 学会长程推理,不仅要让它走得远(Depth),更要让它面对复杂的逻辑丛林(Expressiveness)。