
RLDX-1:突破通才边界,迈向具备功能性认知的灵巧人形机器人
RLDX-1 Technical Report
RLDX-1 是由 KAIST 与 RLWRLD 共同开发的通用机器人策略模型,旨在通过 Multi-Stream Action Transformer (MSAT) 架构统一视觉-语言-动作(VLA)能力。该模型实现了灵巧操作中的运动感知、长期记忆和物理传感功能,并在 ALLEX 人形机器人复杂任务中达到了 86.8% 的成功率,显著超越 π0.5 和 GR00T N1.6 等前沿模型。
TL;DR
机器人学界的“通才”模型(Generalist VLAs)目前正面临从“会看会听”到“会动会感”的跨越。KAIST 推出的 RLDX-1 报告了一个系统级的重磅工作:它不仅通过 MSAT 架构整合了视觉、语言、扭矩和触觉,还通过创新的运动感知和显式长期记忆模块,在复杂的人形机器人灵巧操作中刷新了 SOTA。其在实机 ALLEX 机器人上的表现证明了功能性认知(Functional Capabilities)对于真实物理交互的重要性。
背景:为什么通才 VLA 往往“眼高手低”?
目前的 VLA 模型(如 OpenVLA, π0)擅长在互联网规模的视觉-文本海量数据中汲取常识,但在真实工厂或家庭环境中经常吃瘪。
- 动态性缺失:面对输送带上的移动物体,单帧或短序列观察无法准确定位。
- 记忆剥离:如果一个物体被遮挡或移动到盒子里,缺乏显式记忆的模型会瞬间“忘掉”目标。
- 触觉盲区:在插拔插头或抓取脆弱物体(如鸡蛋)时,仅靠眼睛看是无法精确控制力矩的。
核心方法论:Multi-Stream Action Transformer (MSAT)
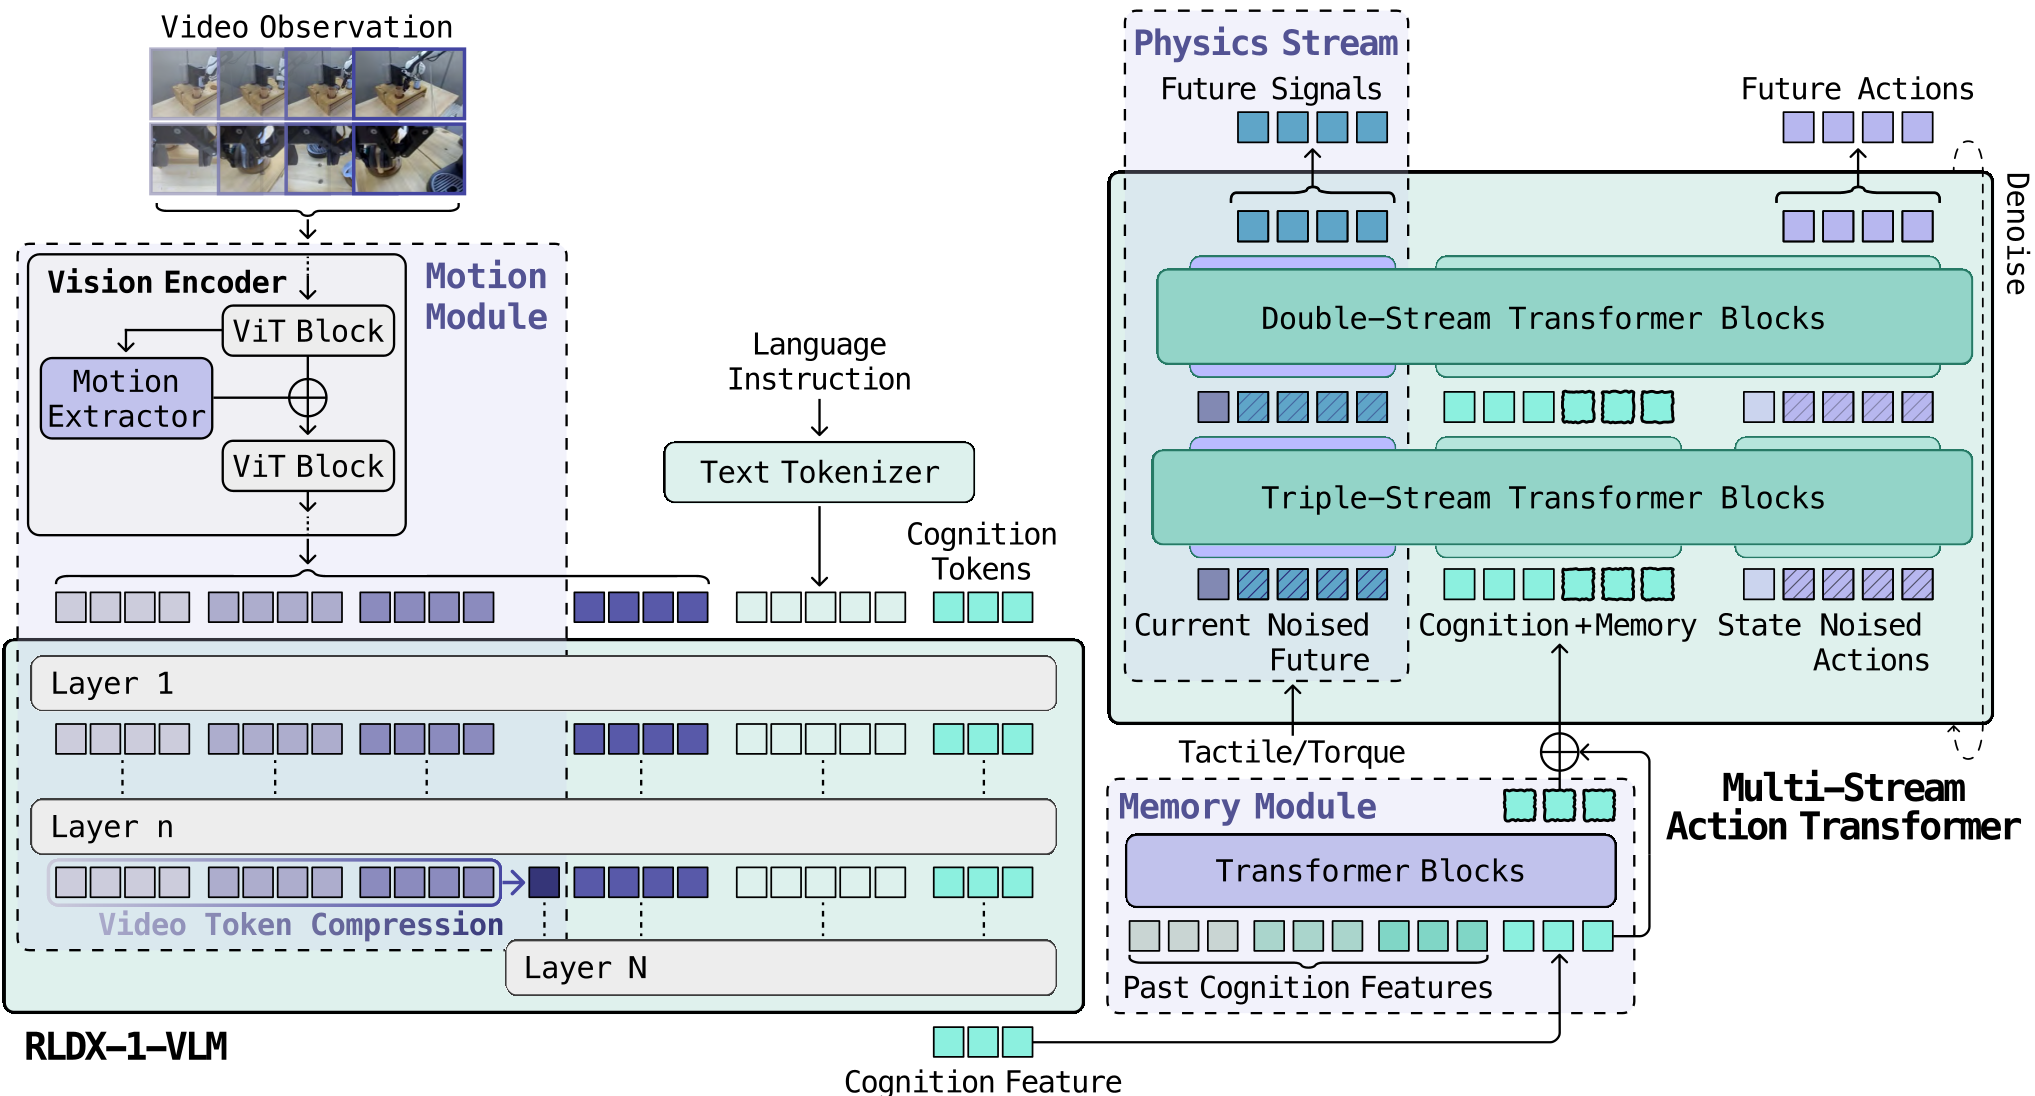
RLDX-1 的心脏是一个多流动作 Transformer。与以往将所有 Token 塞进一个序列的做法不同,MSAT 为不同的模态提供了专有的处理流:
- Cognition (C) Stream:承接 VLM 提取的高维视听特征。
- Action (A) Stream:处理本体感受状态和带噪声的动作轨迹。
- Physics (P) Stream:专门负责实时触觉和力矩反馈的 denoising 预测。
三大功能性黑科技
- 运动感知 (Motion Awareness):集成 STSS(时空自相似性)模块,在 Vision Encoder 的中间层捕捉位移趋势,让机器人不再盯着静态像素看。
- 长期记忆 (Long-Term Memory):引入了一个轻量级的 Transformer 记忆模块,将过去多个 action chunks 期间的认知识别特征存入队列,解决了类似“壳牌游戏(Shell Game)”的推理难题。
- 物理传感 (Physical Sensing):通过辅助任务预测未来的力矩信号,模型学会了在视觉被遮挡时靠“手感”完成插拔。
训练的艺术:三阶段流水线
作者并没有指望在一个阶段完成所有任务,而是设计了教科书般的训练流程:
- Pre-Training:在 1.5M 条多机器人数据集上练就宽泛的动作先验(Embodiment Prior)。
- Mid-Training:针对 ALLEX 人形机器人和独有的传感器(AnySkin 等)进行功能扩充,这里引入了大量的合成数据。
- Post-Training:引入 RECAP (强化学习再精炼),利用 VLM 作为 Critic 对复杂任务(如拧灯泡)进行优势估计和策略提升。
实验战绩:实机表现惊人
在仿真测试中,RLDX-1 横扫了包括 LIBERO, SIMPLER 和 RoboCasa365 在内的所有主流基准。更具说服力的是实机演示:
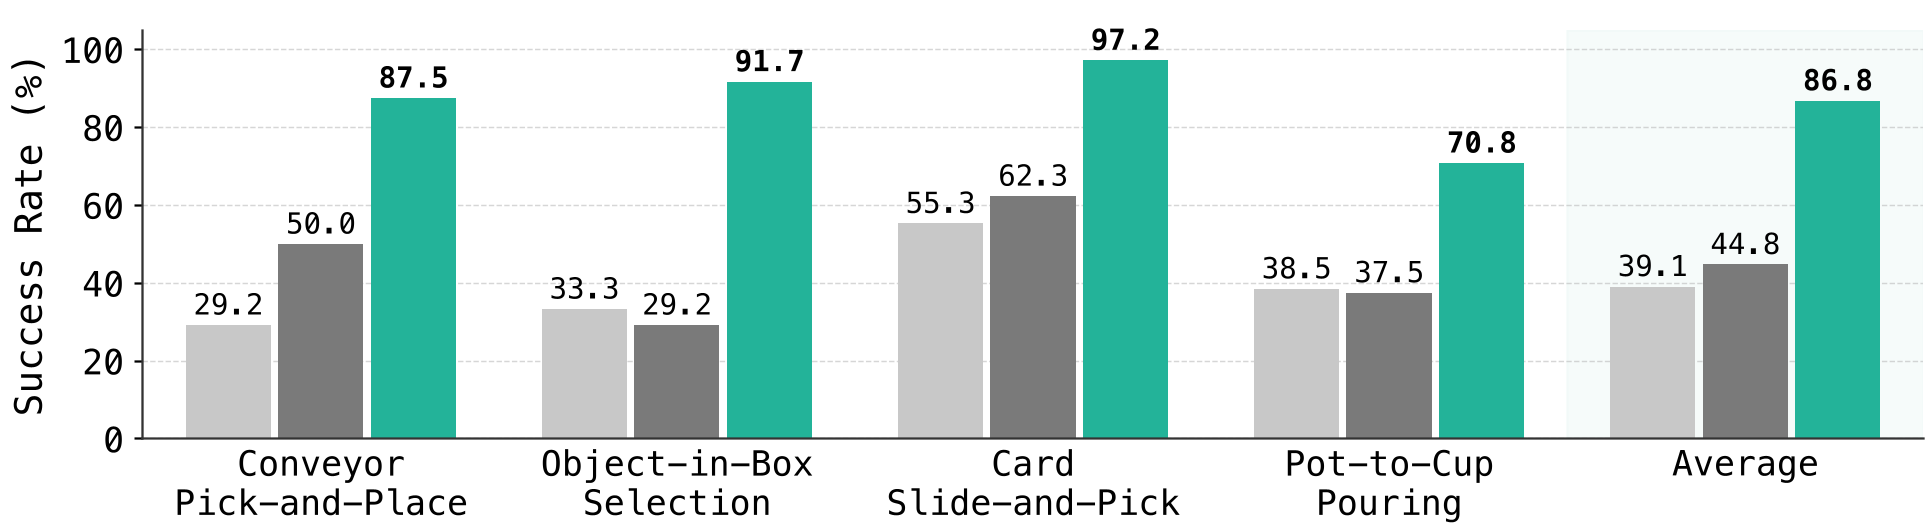
在 Conveyor Pick-and-Place(输送带抓取)任务中,当传送带速度改变时,π0.5 几乎瘫痪(成功率 < 30%),而 RLDX-1 依然能保持 100% 的准确度。在 Card Slide-and-Pick 这种需要精细力控的任务中,RLDX-1 的力矩反馈机制确保了操作的完美执行。
系统优化:43.7ms 的实时响应
对于人形机器人,延迟就是杀手。论文指出,传统的 PyTorch Eager 模式在 RTX 5090 上也有 71.2ms 的延迟。通过 Static Graph Conversion (静态图转换) 和硬件级别的 Kernel Optimization (内核融合),RLDX-1 消除了内核启动开销,将延迟压低了 40% 左右。
深度洞察与总结
RLDX-1 的成功揭示了一个趋势:下一代机器人大模型(Foundation Models)的重点将不再仅仅是扩大模型参数量,而是如何更优雅地集成跨模态时序信息。
- 价值:它为高自由度(48-DoF)人形机器人提供了一个可行的全栈解决方案。
- 局限性:合成数据虽然缓解了样本稀缺,但在极其复杂的物理交互(如流体操作)中仍可能存在 Sim-to-Real 的鸿沟。
- 展望:未来的 VLA 可能会更加依赖世界模型进行在线生成的想象(Planning by Generation),而 RLDX-1 为这种具备物理直觉的系统奠定了坚实的感知底座。