
RoboAlign-R1:蒸馏多模态奖励对齐,打造更真实的机器人视频世界模型
RoboAlign-R1: Distilled Multimodal Reward Alignment for Robot Video World Models
本文提出了 RoboAlign-R1,一个旨在提升机器人视频世界模型(World Model)任务对齐度与长时生成稳定性的框架。核心包括基于强化学习的奖励微调(RL Post-training)以及一种无需训练的滑动窗口重编码(SWR)推理策略,在多个机器人基准数据集上达到了 SOTA 水平。
TL;DR
在具身智能(Embodied AI)的浪潮中,视频世界模型被寄予厚望,旨在让机器人能够“预见”未来。然而,目前的模型往往空有“视觉皮层”而缺乏“物理直觉”。今日解读的 RoboAlign-R1 通过多模态奖励蒸馏和长时推理优化,显著提升了预测未来的准确性与物理合理性。
核心痛点:视觉相似 ≠ 物理正确
目前的机器人世界模型主要面临两个致命顽疾:
- 目标函数失配 (Reward Misalignment):模型在训练阶段通常优化的是 MSE 或 LPIPS 等底层像素指标。一个视频可能在像素上极其接近真实视频,但如果机械臂抓空了,或者物体发生了违反物理规律的形变,这个预测对机器人的决策而言就是灾难性的。
- 长时漂移 (Long-horizon Drift):自回归生成像是一个“传话游戏”,每一帧的小误差都会在下几帧被放大。当生成时长达到数十帧时,背景、阴影和物体结构往往会发生明显的不可预测崩溃。
解决方案:RoboAlign-R1 的双管齐下
1. 奖励对齐的多模态“教师”
作者首先构建了 RobotWorldBench,一个包含 10,000 个标注视频对的基准,涵盖了指令遵循、操作成功、动作-结果一致性、时间连贯性、接触真实感和物理属性六大维度。
- 教师模型 (RoboAlign-Judge):基于 Qwen3-VL-8B 进行微调,由于其具备“思维链 (CoT)”能力,可以像人类专家一样先分析物理逻辑再给出评分。
- 学生模型 (Student Reward):将教师的判断能力蒸馏到一个仅 98M 的轻量化模型中。为什么要这么做?因为 8B 的模型太慢了,无法直接放入 RL 的训练循环。蒸馏后的学生模型推理速度提升了 100 倍以上,使得在大规模强化学习(GRPO)中使用多模态奖励成为可能。
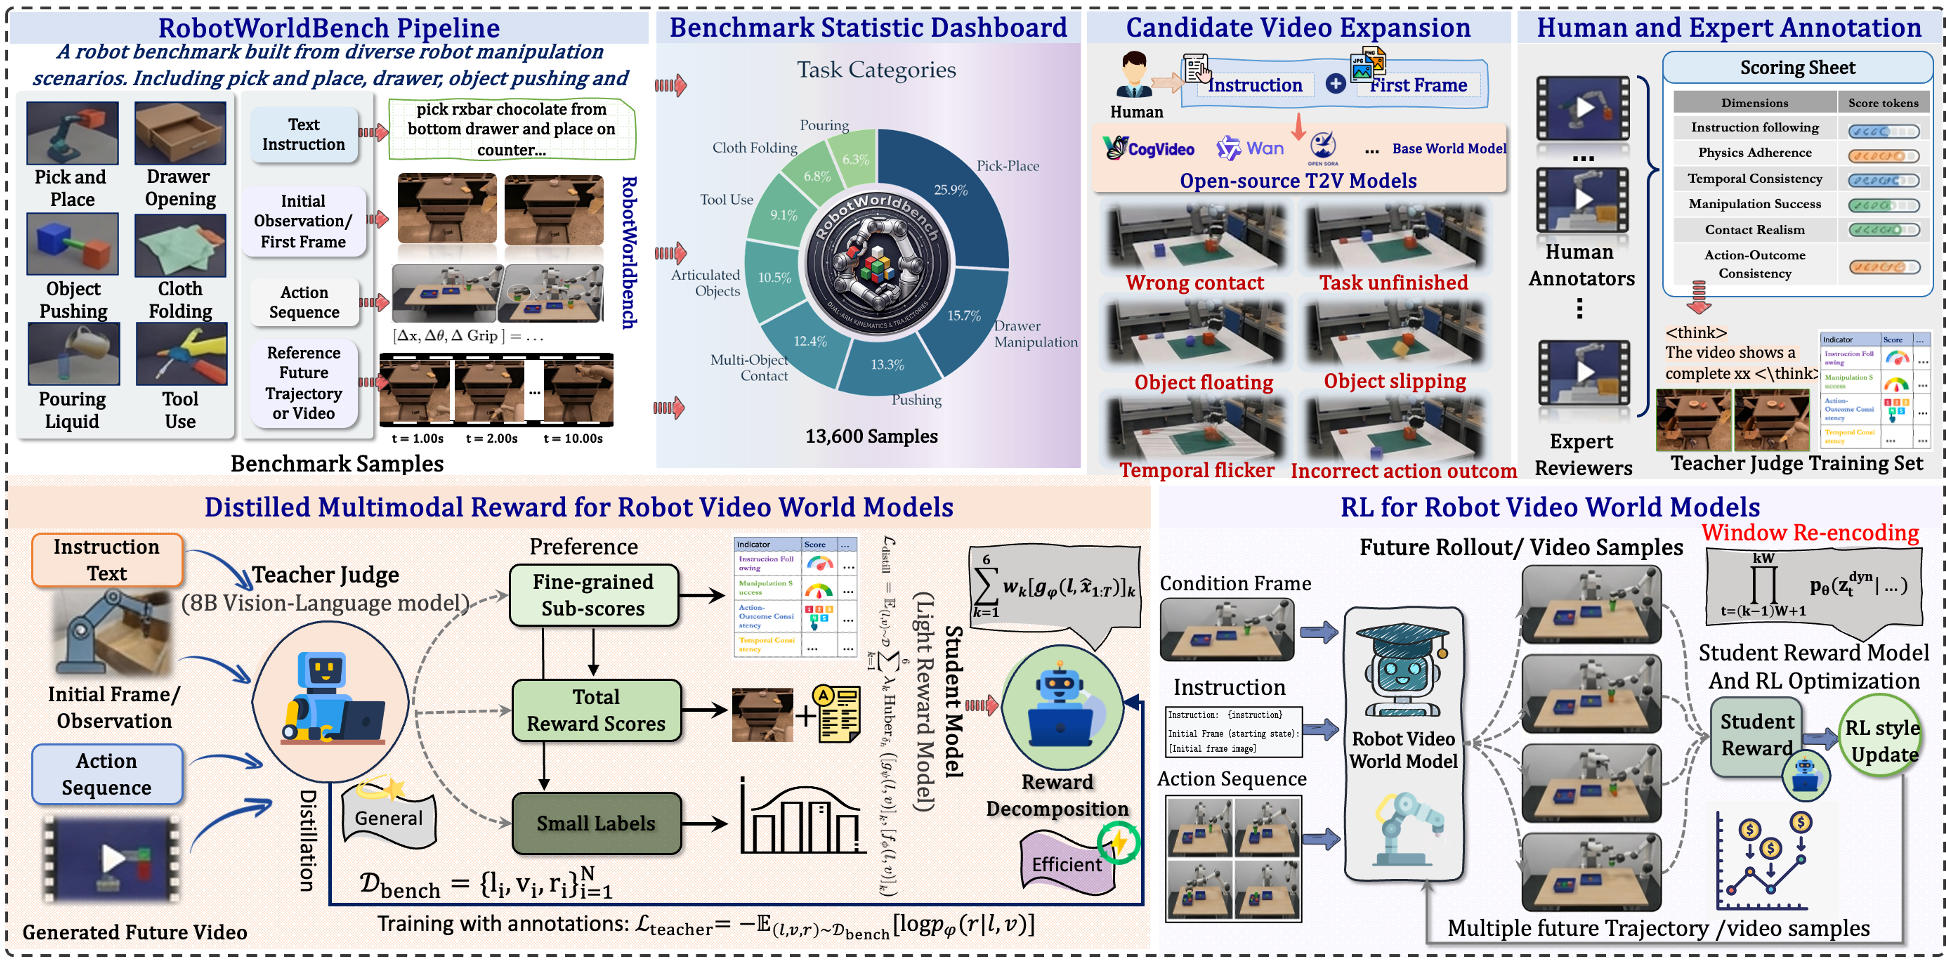 图 1: RoboAlign-R1 的整体流程。从基准建设到教师评判,再到学生奖励蒸馏和最终的 RL 训练。
2. SWR 推理:定期重置未来的“锚点”
为了对抗长时误差累积,作者提出了 滑动窗口重编码 (Sliding Window Re-encoding, SWR)。
- 逻辑物理化:传统的 AR(自回归)生成只在 Token 空间循环。SWR 则是每隔 W 步,将预测的帧解码回像素空间,再重新送入编码器生成新的上下文 Token。这个过程强行“锚定”了视觉表征,避免了 Token 空间的语义漂移。
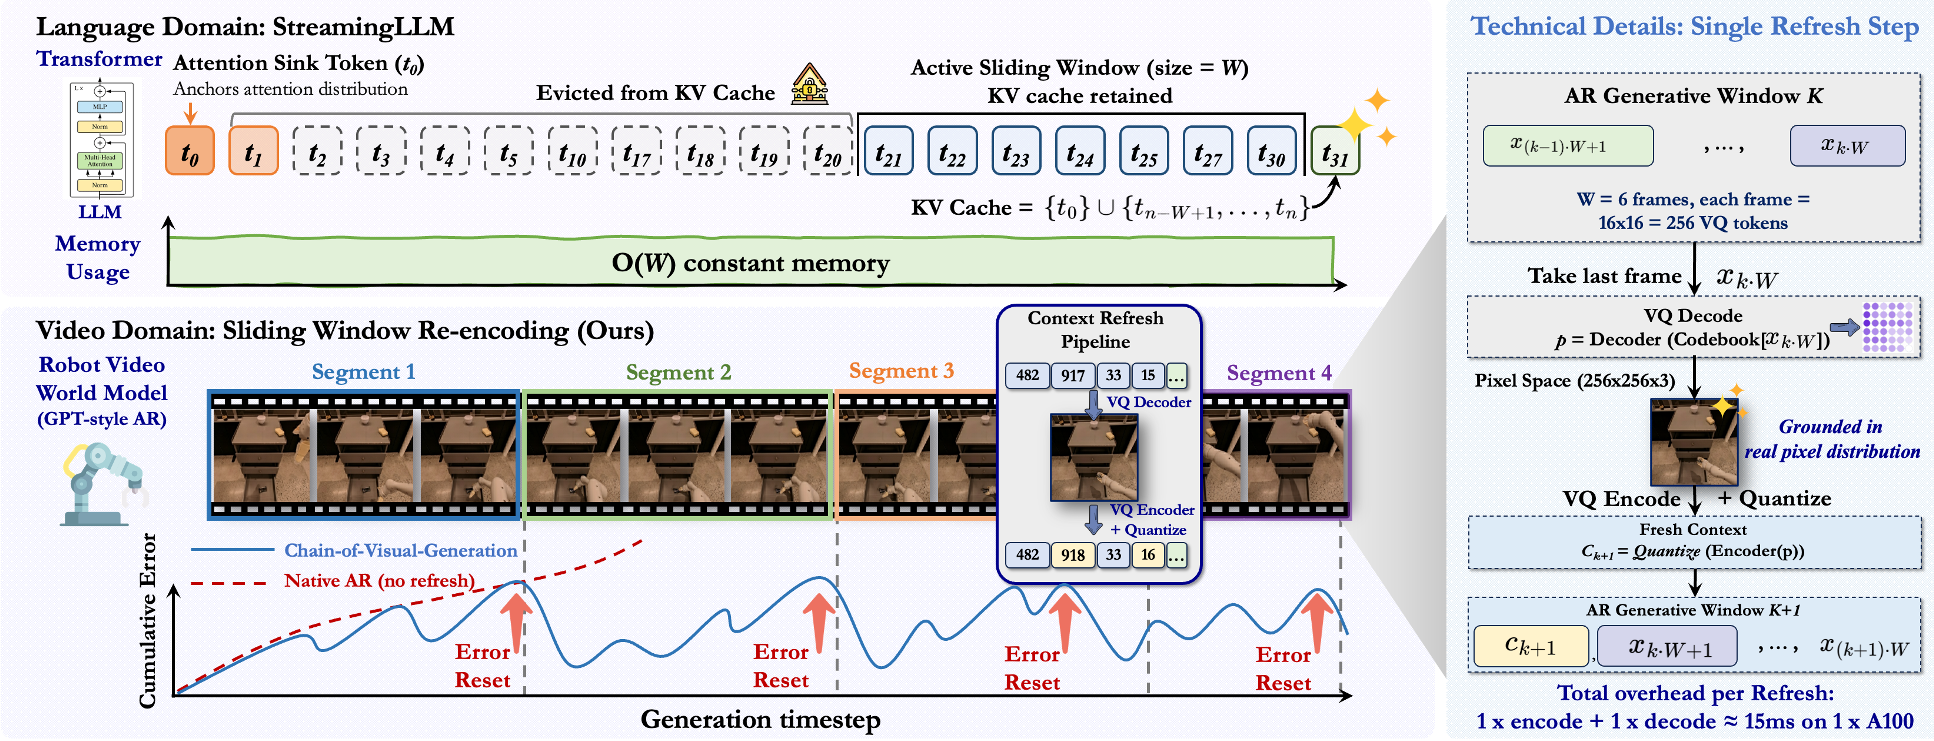 图 2: SWR 与 StreamingLLM 的类比,通过定期“刷新”来维持长序列生成的稳定性。
实验结果:全方位的跨越
在 RT-1 和 BridgeData V2 两个主流机器人数据集上的实验显示,RoboAlign-R1 的表现大幅超越了包括 iVideoGPT 在内的强力基线。
- 任务一致性:在指令遵循和操作成功率上由于引入了多模态奖励,提升最为明显(+10.1%)。
- 视觉保真度:通过 SWR 策略,长序列预测的 PSNR 提升了 0.62 dB,LPIPS 降低了 9.8%。
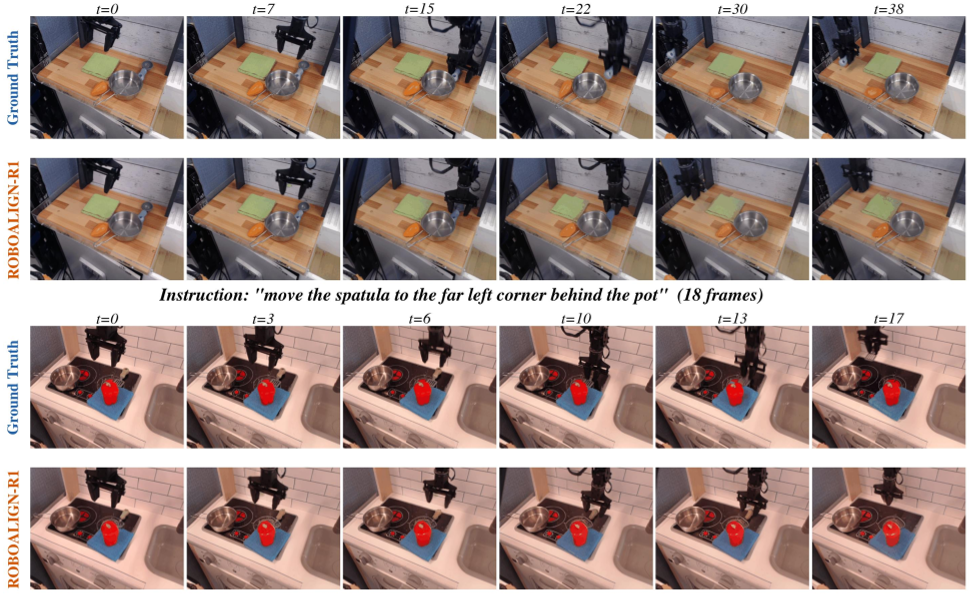 图 3: 在 BridgeData V2 上的定性对比。可以看到 RoboAlign-R1 在背景稳定性和物体质感上对比 iVideoGPT 和其他模型具有明显优势。
深度洞察
RoboAlign-R1 的成功再一次证明了 “大模型思维注入底层任务” 的威力。通过将昂贵的大型多模态模型(LMM)作为教师,把高级的物理常识和任务逻辑蒸馏到小规模奖励模型中,我们可以在不改变底层架构的情况下,显著增强世界模型的能力。
此外,SWR 机制提供了一个非常“物美价廉”的工程手段。在自回归生成中,我们往往过度迷信权重训练,但有时通过推理层面的 Context 刷新,就能解决由于自回归算子本身缺陷导致的噪声累积。
总结与局限
RoboAlign-R1 展示了通过“对齐”来优化世界模型的新路径。尽管目前它仍主要集中在桌面操作任务,未来的研究可以进一步扩展到更复杂的双臂操作或非结构化场景,以及验证这种更强的世界模型是否能直接反哺、提升下游策略(Policy)的学习效率。
本文由资深学术技术主编解读。版权归属于 RoboAlign-R1 论文作者团队。