
Rose-SQL:让 8B 模型在多轮 SQL 推理中超越 GPT-3.5 的艺术
Rose-SQL: Role-State Evolution Guided Structured Reasoning for Multi-Turn Text-to-SQL
本文提出了 Rose-SQL,一个针对多轮 Text-to-SQL 任务的无需微调(Training-free)的推理框架。该框架引入了 Role-State 表征,通过小规模大语言模型(LRMs,如 Qwen3-8B)的上下文学习,实现了 SOTA 级别的跨轮次结构化推理性能。
TL;DR
在 Text-to-SQL 领域,多轮对话的上下文依赖一直是“老大难”问题。传统的做法要么靠微调强灌知识,要么靠大模型(GPT-4/3.5)暴力破解。Rose-SQL 另辟蹊径:它通过一套名为 Role-State 的“结构化蓝图”,让 Qwen3-8B 这种小规模模型在无需一行代码微调的情况下,在 SParC 和 CoSQL 两个权威榜单上刷出了超越 SFT(监督微调)专家模型的新高度。
痛点深挖:多轮 SQL 解析难在哪?
多轮 Text-to-SQL 任务比单轮难得多,核心障碍有两点:
- 结构失配(Structural Misalignment):自然语言的语义和 SQL 的严苛语法之间缺乏一个稳定的桥梁。对于小模型,直接从“帮我查查德国有哪些车型”跳到
SELECT count(*) FROM ... JOIN ...太远了。 - 上下文噪声(Contextual Noise):随着对话进行,历史信息指数级增加。如何判断当前问题是依赖上一轮的过滤条件,还是开启了一个全新的主题?
作者观察到,虽然像 Qwen3、DeepSeek 这样的推理模型(LRMs)拥有强大的长链思维(Long CoT)能力,但它们在没有感官引导的情况下,往往会迷失在对话的迷雾中。
核心机制:Role-State 与进化轨迹
1. Role-State:SQL 的数字化灵魂
作者将 SQL 的功能模块化,定义了 10 个核心角色(如 selected, join, condition, group 等),并将其编码为一个十维的 Indicator Vector。这个向量就像是 SQL 的 DNA,不代表具体的表名,而代表了查询的结构逻辑。
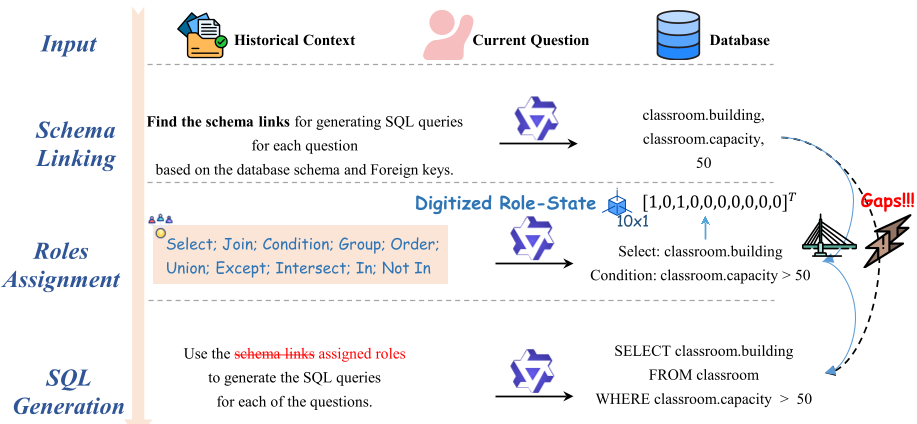 Role-State 充当了从语义意图到语法执行之间的结构化蓝图。
2. 进化轨迹搜索(Evolutionary Trajectory Searching)
这步最显“资深主编”眼中的功力:系统不仅仅检索相似的问题,还执行结构同构检查。只有当检索出的历史案例在 Role-State 的转换逻辑上与当前轮次一致时,才会被作为引导案例。这种方式确保了模型参考的是“逻辑上相似的推导过程”,而非仅仅是“看起来相似的单词”。
3. 增益依赖分析 (GDA)
为了过滤无效对话,作者引入了 PPL(困惑度)。通过对比模型在有无历史背景下的 PPL 变化,量化各轮次的信息增益,确保模型只盯着那些真正有用的“上下文锚点”。
实验与结果:小模型的逆袭
Rose-SQL 的表现令人惊艳。在 Qwen3 系列模型上,加入 Rose-SQL 框架后,性能直接“跳级”:
- Qwen3-4B 在加入 Rose-SQL 后,性能几乎追平了未经优化的 8B 基座。
- Qwen3-8B 在 SParC 数据集上的执行准确率(EX)达到了 78.72%,直接将 GPT-3.5 以及一众经过专门微调的专家模型(如 Track-SQL, RASAT)甩在身后。
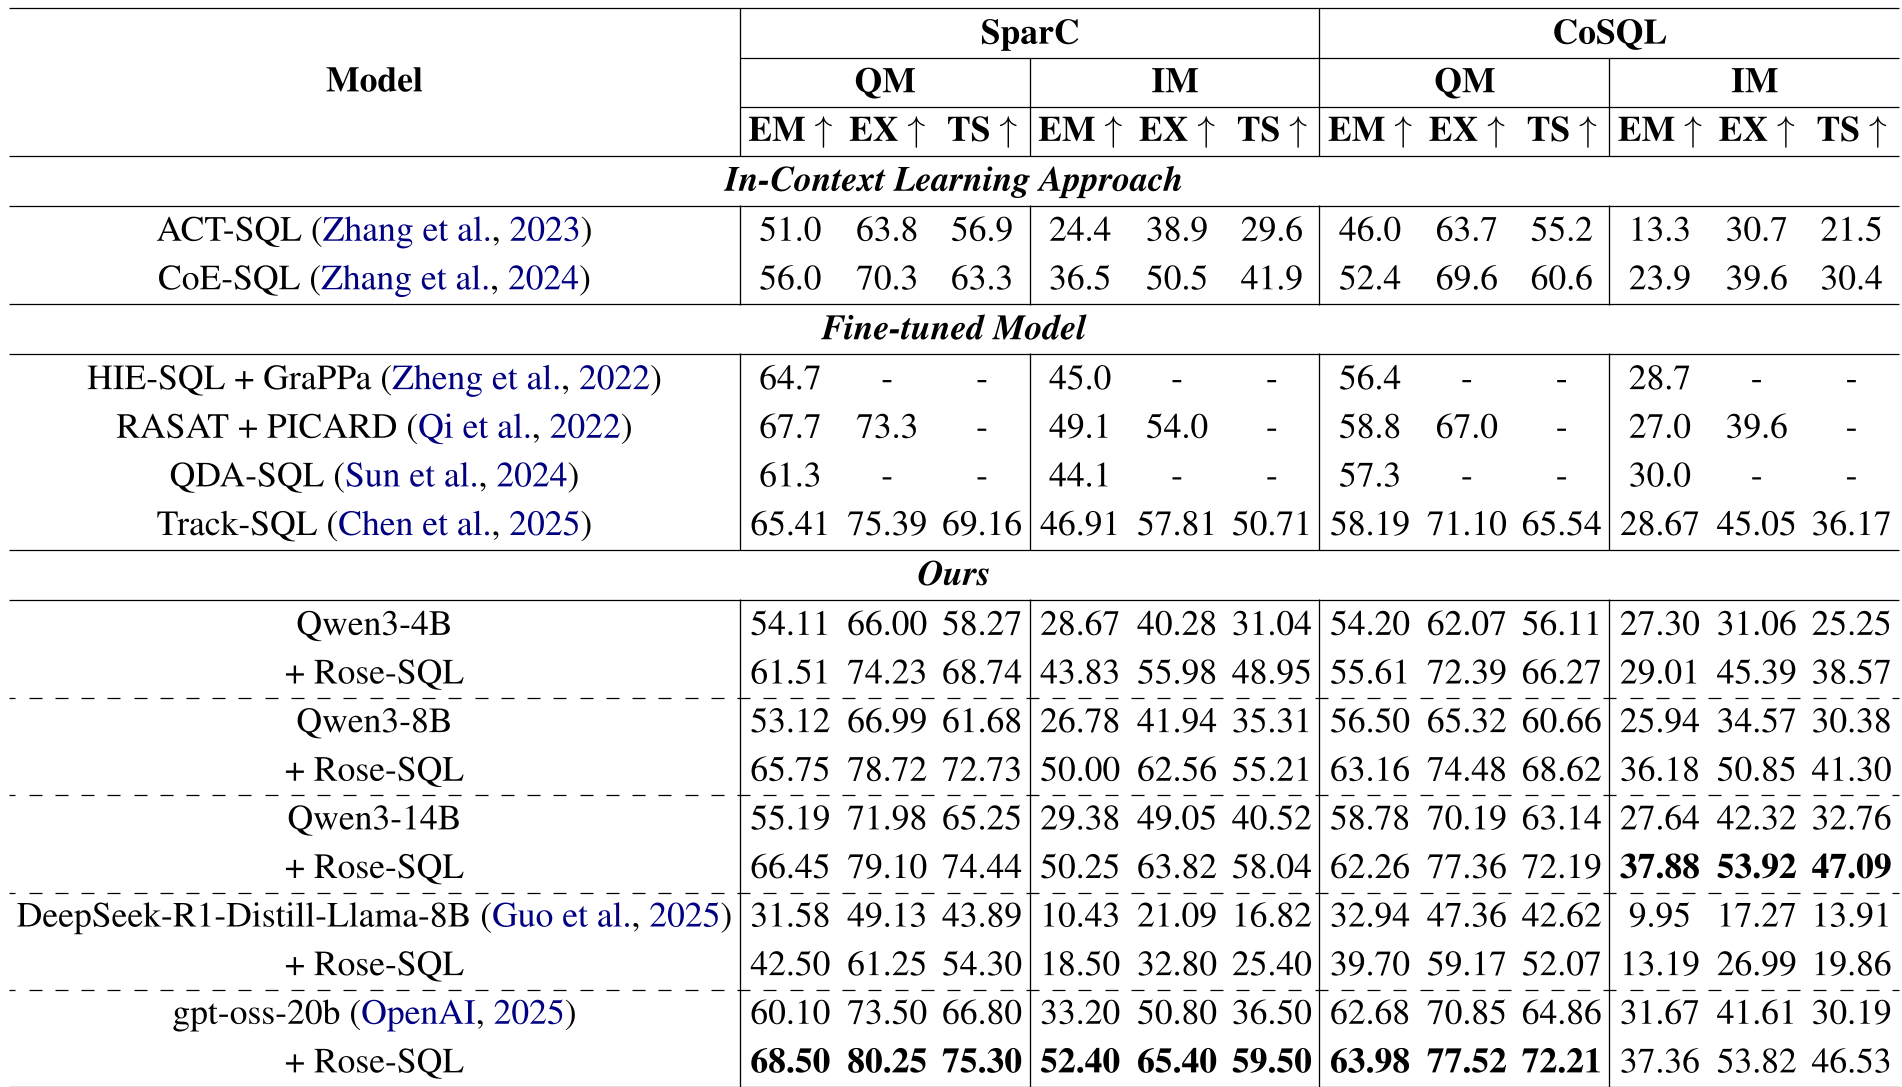 表 1 展示了 Rose-SQL 如何系统性地提升 4B/8B/14B 模型的各维度表现。
消融实验的关键发现:
通过消融分析,作者发现 Role Knowledge Injection () 对提升 Exact Match (EM) 帮助最大,因为它提供了原子的语法规范;而 Evolutionary Trajectories () 则是提升多轮交互(IM)一致性的关键,它教会了模型如何处理“对话的演进逻辑”。
深度洞察:为何无需微调能赢?
Rose-SQL 的成功本质上是将推理压力从“隐式权重存储”转移到了“显式推理路径”。
- Inductive Bias 的显性化:通过 Role-State,模型被强迫先思考“我要执行什么动作(Join 还是 Group)”,再填写具体的“参数(具体的列名)”。这种层次化推理路径(Hierarchical Reasoning)极大降低了生成错误 SQL 的概率。
- 精准的历史回溯:相比全量上下文输入,通过 GDS 和同构检查筛选出的轨迹,给模型提供了高质量的“避坑指南”。
局限性与挑战
虽然强大,但 Rose-SQL 目前依赖于历史轨迹的召回。在极罕见的对话模式下,如果找不到结构同构的案例,其性能增益可能会缩水。此外,由于引入了复杂的 Prompt 和检索过程,推理的输入 Token 数显著增加,这在推理成本受限的场景下需要权衡。
总结
Rose-SQL 为我们展示了后微调时代的一种可能:通过深入理解任务的领域性质(SQL 的结构化特征),并结合大推理模型(LRMs)的长 CoT 能力,我们可以构建出更轻量、更灵活且更强大的语义解析系统。对于正在做 Text-to-SQL 落地或复杂 Agent 推理的开发者来说,这种“结构化中间层 + 逻辑同构引导”的思路极具参考价值。