
ROPD:用语义准则打破 Logit 依赖,开启黑盒模型的高效蒸馏时代
Rubric-based On-policy Distillation
本文提出了 ROPD (Rubric-based On-policy Distillation),一种基于结构化语义准则的在线蒸馏框架。通过将教师模型的知识转化为 prompt 相关的评分准则(Rubrics),ROPD 在不依赖教师模型 Logits 的黑盒场景下,刷新了多项推理任务的 SOTA 记录。
TL;DR
在大型语言模型(LLM)的对齐阶段,在线蒸馏(On-Policy Distillation, OPD)一直是性能提升的王道。但传统的 OPD 必须“开箱”,即依赖教师模型的 token 概率分布(Logits)。本文提出的 ROPD 彻底打破了这一桎梏:它不再模仿概率,而是利用教师生成的回答提取“判卷标准”(Rubrics)。实验显示,ROPD 在黑盒环境下不仅反超了白盒 SOTA 方法,还将样本效率提升了整整 10 倍!
痛点深挖:为什么 Logits 并非万灵丹?
目前主流的对齐方法(如 MiniLLM, GKD)都属于白盒蒸馏。它们要求学生模型在分布式层面去贴近教师模型。这种方法存在三大硬伤:
- 闭源墙限制:无法利用 GPT-4 或 GPT-5 等顶级 API 模型作为教师。
- 概率噪声:Token 级别的 Logits 包含大量的随机表达波动,学生模型往往花了大代价在模仿老师的说话方式(Style),而不是学习逻辑(Logic)。
- 分布错位:在复杂推理任务中,高概率的 Token 路径未必等于正确答案,导致模型通过了概率校验却给出了错误结论。
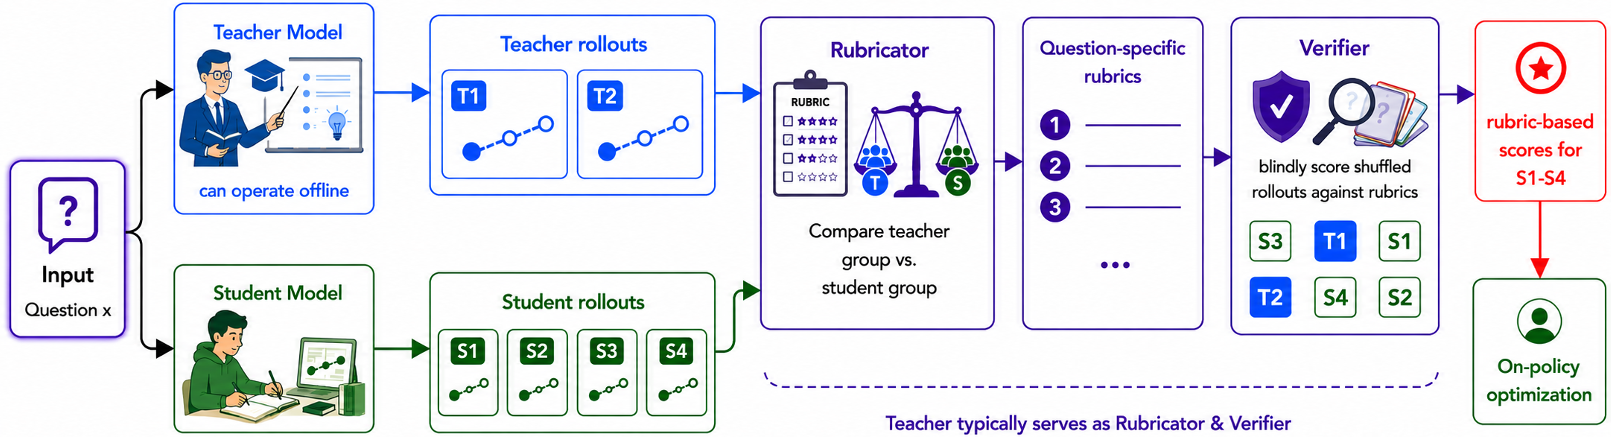
ROPD 核心机制:从“照猫画虎”到“依规判卷”
ROPD 将蒸馏过程重构为两个阶段,巧妙地将黑盒输出转化为结构化奖励:
1. 准则感应 (Rubric Induction)
给定一个问题,系统会采样多个教师回答和学生 Rollouts。Rubricator(通常由教师模型担任)会通过对比教师与学生的行为差异,提炼出一系列二进制准则。例如:
- 任务完成度:是否最终给出了 boxed 格式的答案?
- 可观测质量:是否识别出了题目中的奇偶性约束(Parity Obstruction)?
- 通用推理:步骤之间是否逻辑连贯?
2. 基准校验 (Rubric-based Verification)
Verifier 拿着这些准则去“盲审”学生的每一个采样回答,并计算加权得分。这些得分直接作为奖励信号馈送给 GRPO 算法(Group Relative Policy Optimization)。这种设计消除了对价值模型(Value Model)的需求,极大地减少了 GPU 显存占用。
关键发现:语义比概率更可靠
论文中一个非常深刻的 Insight 是:教师 Logits 与答案正确性之间甚至存在负相关。
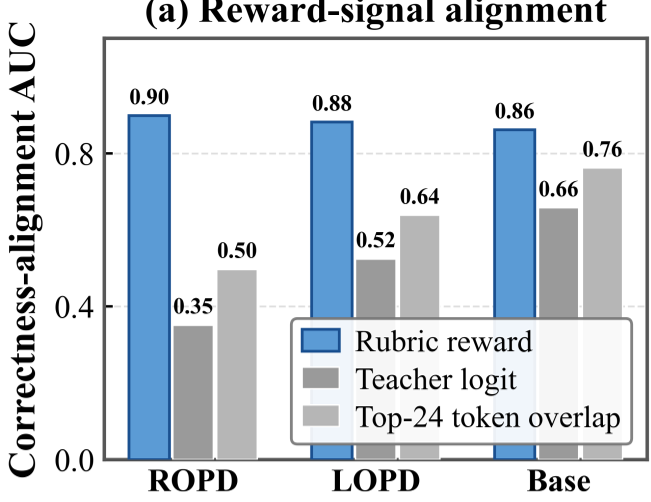
从上图 (a) 可以看到,ROPD 的 Rubric 奖励与正确性的对齐 AUC 达到了 0.90,而教师 Logits 的 AUC 仅为 0.35。这意味着:
- 模仿是手段,超越是目的:训练早期,ROPD 模型通过语义对齐迅速掌握教师的格式规范;但在后期,它会主动偏离教师的 Token 分布,去追求更高的逻辑正确率。
实验战绩:10 倍效率提升
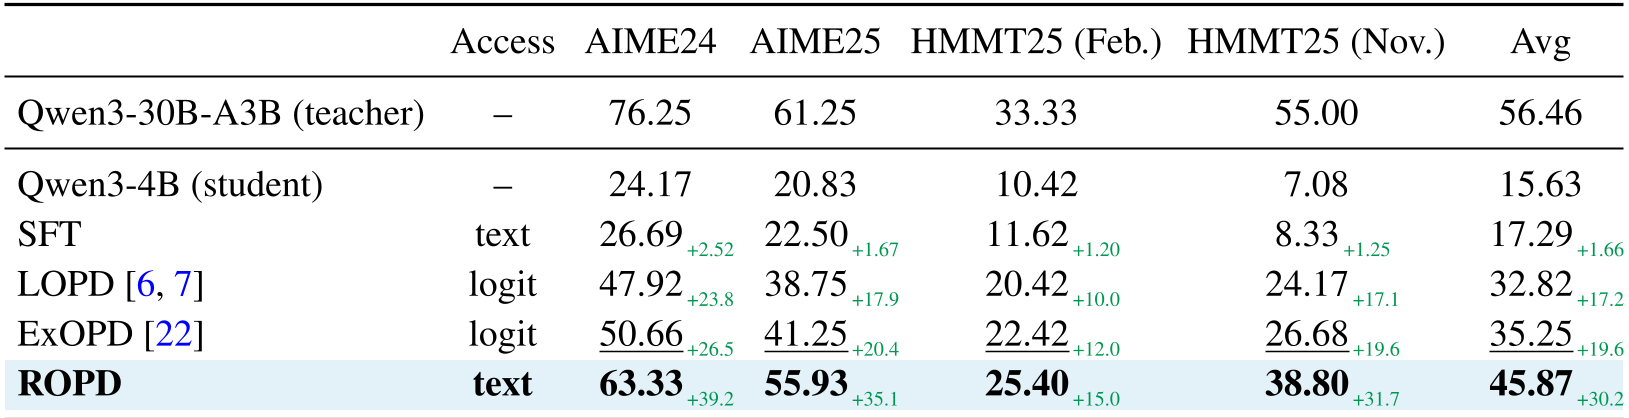
ROPD 在 AIME(美国数学邀请赛)等极难任务上的表现惊人:
- 效率奇迹:仅需 1.6k 样本即可达到传统方法 15.4k 样本的效果。
- 跨架构稳健:即使教师是 GPT-5,学生是轻量级的 Gemma 或 Qwen,ROPD 依然能实现稳健的性能跃升(+50% 相对提升)。
- 无感优化:相比传统的白盒在线学习,由于教师模型可以离线预运行 Rubric,训练的总耗时提升了 6.3 倍。
深度洞察与总结
ROPD 的成功向我们揭示了一个事实:蒸馏的本质是逻辑的传递,而非分布的对齐。
通过将抽象的知识拆解为可验证的“语义里程碑”,ROPD 实现了一种更为高维的对齐。尽管目前主要针对数学、医学等强逻辑领域,但这种“基于准则的反馈”为未来解决主观性任务、创意任务提供了极具参考价值的范式转换。对于研究者来说,ROPD 不仅仅是一个算法,它标志着模型对齐正在从“统计模仿”进化到“语义理解”。
局限性:目前 ROPD 仍高度依赖 Rubricator 生成准则的指令遵循能力,且在创意性、主观性任务上的表现仍需进一步验证。