
[ICLR 2025] RAF 模型:揭秘神经网络如何同时“理解”规律与“死记”硬背
The Rules-and-Facts Model for Simultaneous Generalization and Memorization in Neural Networks
本文提出了 Rules-and-Facts (RAF) 模型,这是一个研究神经网络同时具备结构化规则学习(泛化)与非结构化事实存储(记忆)能力的理论框架。通过统计物理中的副本方法(Replica Method),作者精确刻画了线性模型及核回归在处理包含教师规则与随机标签混合数据时的性能界限。
1. 核心速览 (Executive Summary)
TL;DR:为什么大模型既能写出符合逻辑的代码,又能记住瑞典的首都是斯德哥尔摩?本文提出了 Rules-and-Facts (RAF) 任务模型,首次在数学上清晰地界定了神经网络如何分配其参数容量:一部分用于提取结构化的“规则”(Rules),另一部分用于插值非结构化的“事实”(Facts)。
背景定位:这项工作是统计物理学习理论的一项突破。它将经典的“教师-学生模型”(研究泛化)与“Gardner容量分析”(研究记忆)通过一个 参数完美统一。它证明了**过度参数化(Overparameterization)**并非冗余,而是实现“规则”与“事实”共存的物理前提。
2. 痛点与动机 (Problem & Motivation)
长期以来,学术界对“记忆”抱有某种偏见:
- 经典观点:记忆会导致过拟合,模型应该尽量压缩信息以获得泛化。
- 近期观点:记忆是“良性的”(Benign Overfitting),模型可以容忍噪声。
- 现实需求:对于现代 AI,记忆是必须的。 irregular verbs(不规则动词)或历史事实无法通过规则推导,只能硬背。
作者敏锐地察觉到,现有的 SOTA 模型分析往往将记忆视为“副作用”,而没有将其视为与泛化地位对等的“学习任务”。
3. 方法论详解 (Methodology)
RAF 任务定义
数据由两部分组成:
- Rules: 标签由教师向量 生成:。
- Facts: 标签是纯随机的 。 模型必须在测试集上预测对规则,同时在训练集上“复读”出那些随机的 Facts。
核心直觉:核几何的容量分配
作者通过分析发现,在过度参数化()的核方法中,内存分配遵循以下逻辑:
- 分量:捕捉激活函数中的线性部,负责与教师规则对齐,驱动泛化。
- 分量:捕捉非线性高阶项,这些“余数”容量被用来精准插值那些不符合规则的随机事实。
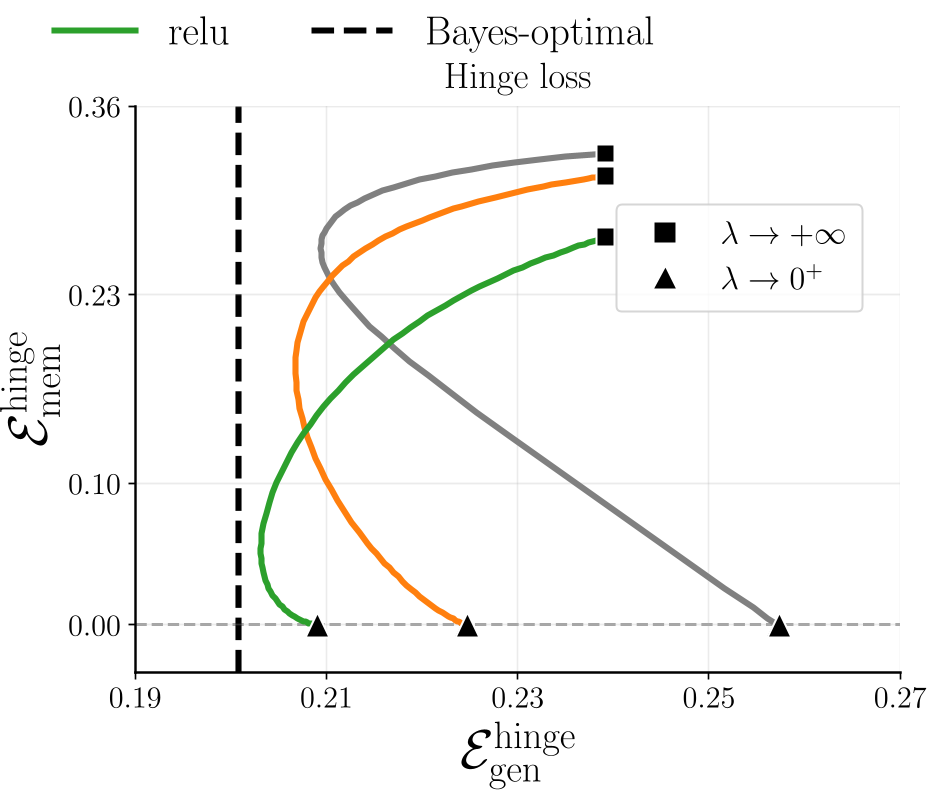 图 1:正则化参数 如何控制线性感知机与核方法在泛化(横轴)与记忆(纵轴)之间的权衡。可见核方法(红色/绿色线)能进入低泛化+低记忆误差的左下角黄金区域。
4. 实验与结果 (Experiments & Results)
线性模型的失败与核方法的胜利
线性感知机(Linear Perceptron)在 RAF 任务面前无能为力:要记住所事实,就会完全破坏对规则的理解。 相比之下,带有非线性激活(如 ReLU, Erf)的核方法通过增加参数维度,实现了“鱼和熊掌兼得”。
关键发现:正则化的角色
- 当正则化 时,模型趋向于完美记忆训练集(Ridgeless 极限)。
- 存在一个最优角度 ,它由核函数的几何性质决定,能让模型在实现完美记忆的同时,达到泛化能力的理论上限。
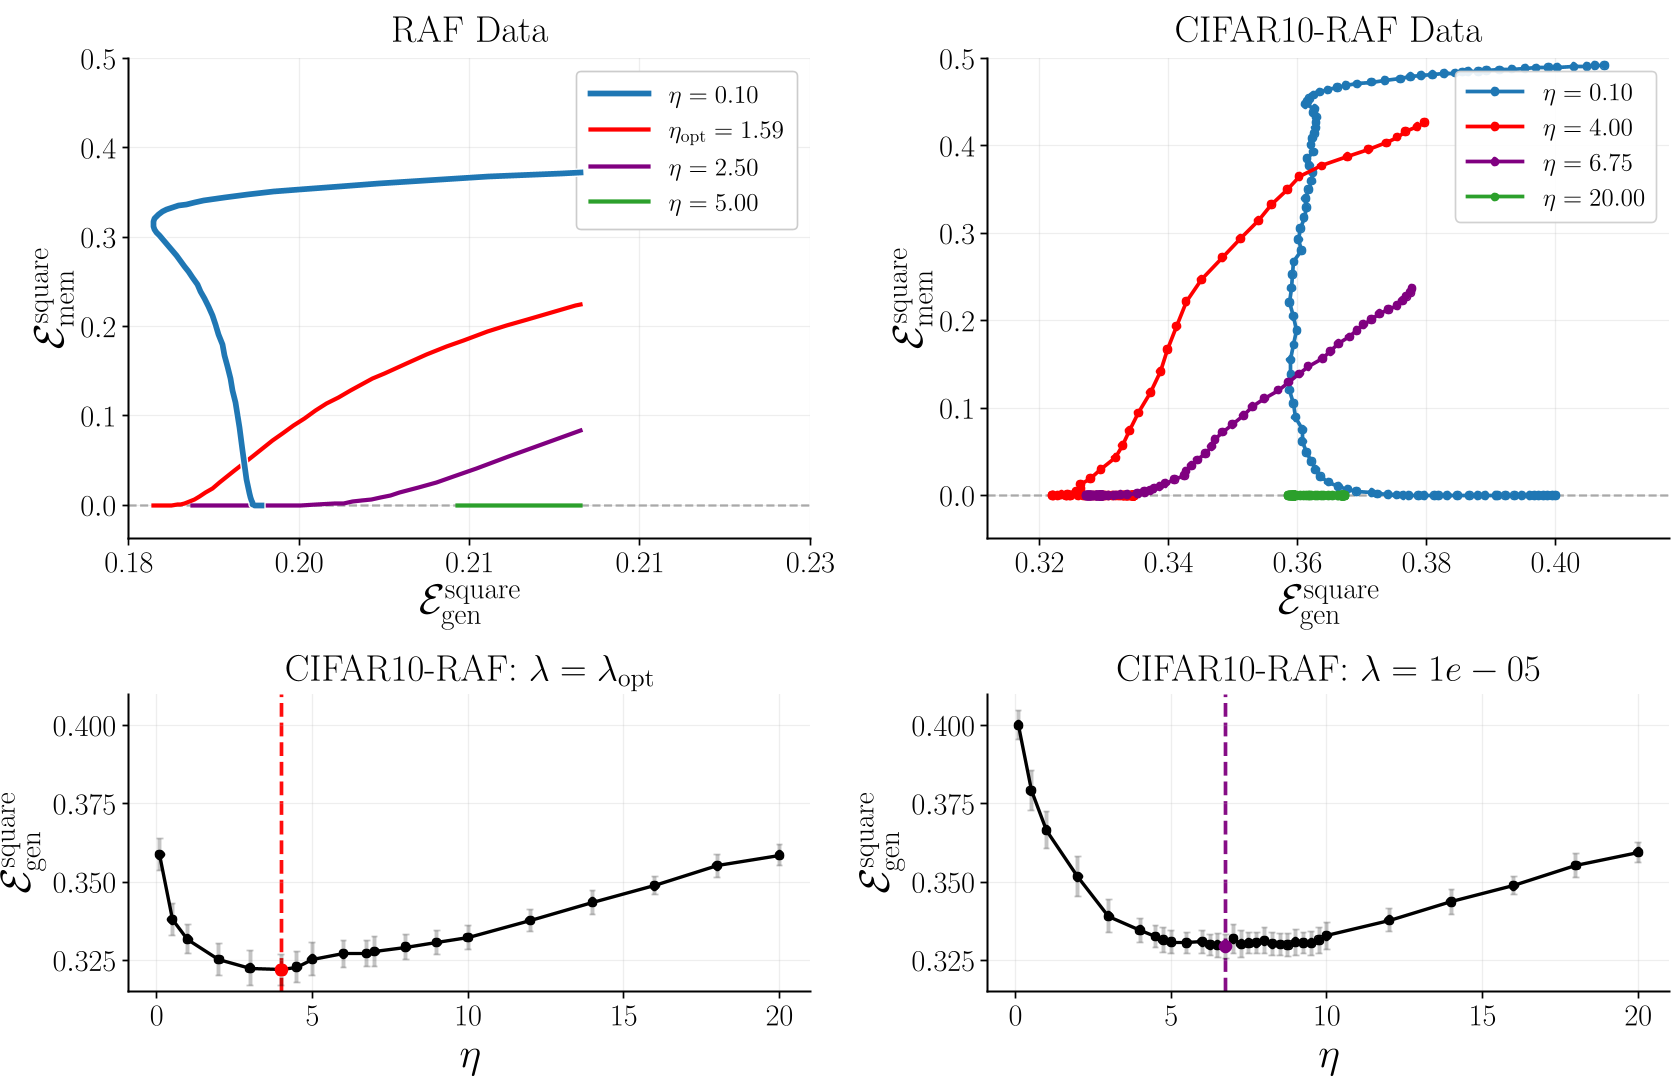 图 2:在真实的 CIFAR10 数据集上,通过混合分类任务与随机标签任务,验证了理论预测的定性一致性:带宽 决定了模型是在“死记硬背”还是在“总结规律”。
5. 深度洞察与总结 (Critical Analysis & Conclusion)
泛化率的遗憾
尽管核方法表现优异,但根据作者的推导,核方法在 RAF 任务下的泛化误差随样本数 衰减的速率仅为 ,这远慢于 Bayes-optimal 的 。这暗示了单纯的核方法或固定特征模型无法达到学习的最优解。
Takeaway
- 过度参数化是功能性的:它不仅是为了优化方便,更是为了构建一个足够大的空间去物理隔离“泛化流形”和“记忆孤岛”。
- 未来展望:真正的突破可能在于特征学习(Feature Learning)。只有当神经元能够根据数据动态调整基底时,才可能在实现完美记忆的同时,达到最快的泛化收敛率。
结论:RAF 模型提供了一个极简且优美的数学沙盒,让我们重新审视记忆在智能系统中的地位——它不是泛化的敌人,而是泛化的补充。