
[CVPR 2025] Scene Grounding:跨越现实与合成,解决大规模 3D 重建的“断裂”困局
Scene Grounding In the Wild
本文提出了 Scene Grounding 框架,通过将野外采集的局部 3D 重建模型(Partial Reconstructions)对齐到基于 Google Earth Studio 的全球参考模型,解决了大规模场景重建中的不连续与对齐错误问题。该方法利用 3D Gaussian Splatting (3DGS) 嵌入 DINOv2 语义特征,实现了即使在无视觉重叠情况下的全局一致性对齐。
TL;DR
在 3D 重建领域,由于摄影视角偏差,建筑物的正面和背面往往会碎裂成两个无法连接的局部模型。本文提出了一种全新的框架,利用 Google Earth Studio 生成的全球参考模型作为“地标锚点”,通过 3D Gaussian Splatting (3DGS) 与 DINOv2 语义特征 的结合,成功将断开的局部模型精准对齐。这不仅解决了传统 SfM 依赖重叠视角的痛点,更在跨域对齐鲁棒性上超越了 DUSt3R 等 SOTA 手段。
背景定位:SfM 重建的“孤岛”难题
经典的 Structure-from-Motion (SfM) 算法(如 COLMAP)有一个致命弱点:它本质上是在玩“找不同”的接龙游戏。如果游客大多只拍米兰大教堂的正门,而少数人拍了后门,且中间没有过渡路径,算法就会生成两个互不相干的 3D 孤岛。
由于这种 Viewpoint Bias 的存在,我们无法获得一个全局统一的坐标系。作者的直觉非常犀利:虽然游客照片不全,但卫星地图和城市 3D 建模软件(如 Google Earth)拥有几乎 100% 的覆盖率。即便卫星地图看起来“假”(Domain Gap),其内在的语义结构(哪里是窗户、哪里是尖顶)与真实照片是高度一致的。
核心方法:基于语义特征的逆向优化
为了桥接现实照片(Real Images)与伪合成影像(Pseudo-synthetic Renderings)之间的距离,作者抛弃了传统的颜色光度损失(Photometric Loss),转向了语义空间。
1. 语义增强的 3DGS 参考模型
系统首先利用 Google Earth 数据构建一个参考模型。不同于普通的渲染,作者向每个高斯球(Gaussian)中注入了 DINOv2 提取的特征向量。
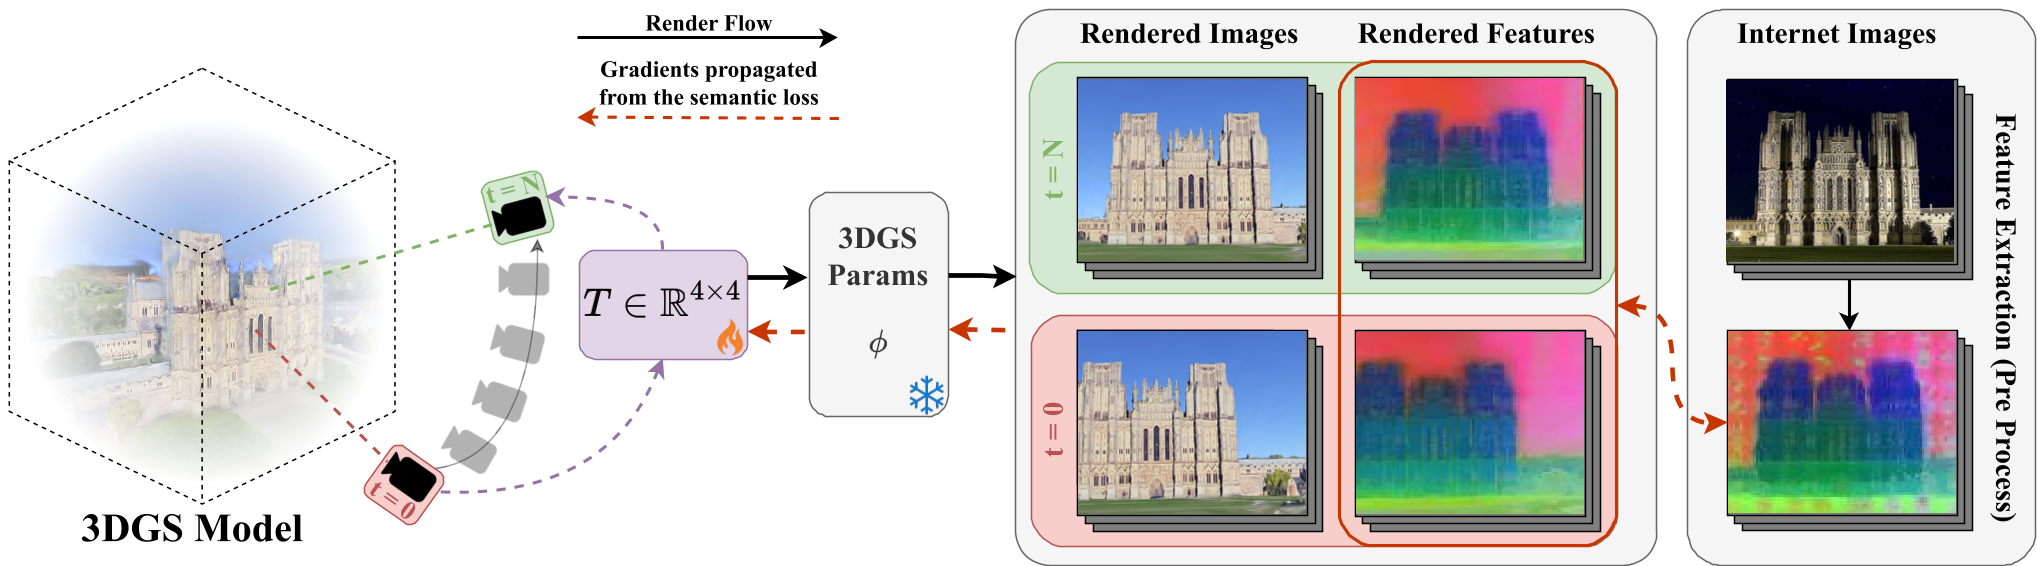 图 2: 语义特征驱动的健壮优化流程。通过对比 Meta-image 渲染视图与实拍图的语义特征,优化 6DoF 全局变换 T。
2. 健壮优化与 LTS 策略
在野外场景中,实拍图可能包含路人遮挡,参考模型可能包含浮动的伪影(Floaters)。如果直接进行全局优化,这些异常值(Outliers)会带偏模型。 作者引入了 Least Trimmed Squares (LTS) 策略:在每一轮迭代中,自动计算所有图片的语义损失。只保留损失较小的“中位数以内”的图片进行反向传播,动态剔除遮挡严重的图片。
实验战绩:对齐精度的跨代提升
为了验证效果,作者发布了 WikiEarth 基准数据集,将 WikiScenes 的真实重建与 Google Earth 模型配对。
结果分析
实验表明,该方法在各种初始状态下均能显著提升精度:
- COLMAP 初始化:旋转误差由 4.99° 降至 2.48°,失败场景数归零。
- 对比 Feed-forward 模型:虽然 DUSt3R 和 VGGT 在小规模重叠场景表现优异,但在本项目这种“跨越建筑物两端、中间无视觉连接”的极端案例中,它们往往会发生错误的几何坍缩,而本文方法凭借“外部权威参考”保持了极高的稳定性。
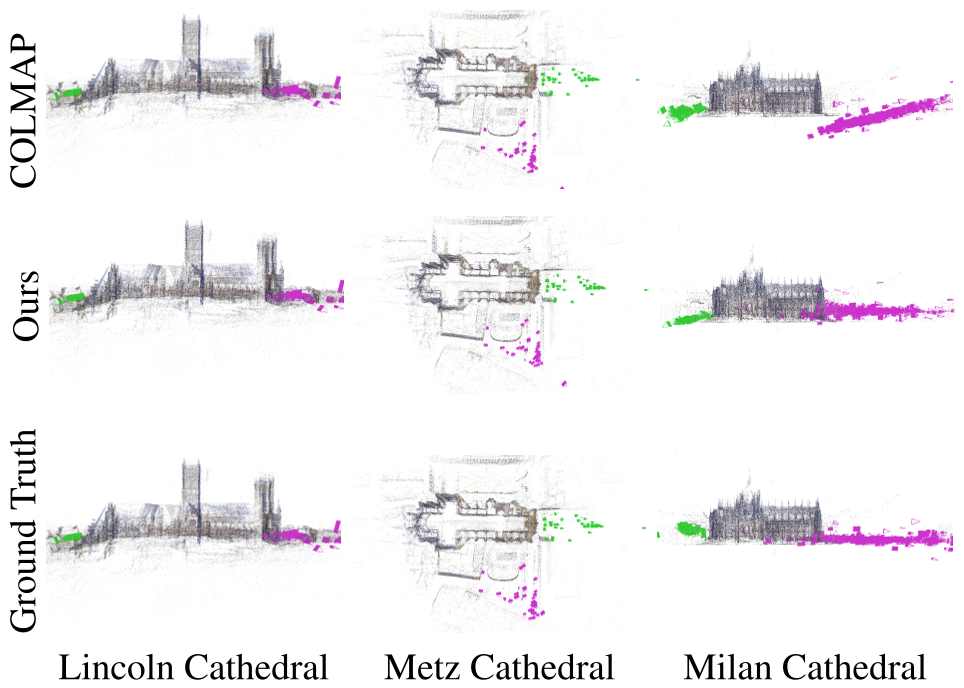 图 6: 多局部模型合并效果。绿紫色代表不同的局部重建,经过本文方法后完美“回填”到全局参考空间。
深度洞察与总结
为什么有效?
- Inductive Bias 的引入:传统 SfM 是纯几何推导,本文通过 Google Earth 引入了先验的“世界知识”。
- 语义的韧性:外观(光照、纹理细节)会变,但 DINOv2 捕获的物体类别和部件关系在不同视角下具有极强的鲁棒性。
局限性与未来
尽管该方法非常强悍,但它仍然依赖一个较好的初始对齐。如果初始化姿态完全错误,优化器可能会陷入局部最优。未来的研究方向可能包括:
- 将 LLM/语言语义 引入、实现更高级的“文字指引对齐”。
- 利用无人机视频实时更新参考模型,构建更精细的混合场景。
一句话总结:这篇论文为真实世界的大规模数字化(Digital Twins)提供了一把解决“碎片化”问题的关键钥匙。