
模拟成就真实:高效视频转换助力 VLA 模型突破泛化瓶颈
Seeing Realism from Simulation: Efficient Video Transfer for Vision-Language-Action Data Augmentation
本文提出了名为 Seeing Realism from Simulation 的高效视频数据增强框架。该方法通过条件视频生成技术(Conditional Video Transfer)将廉价的仿真视频转化为具有写实风格的训练数据,在 RDT-1B 和 π0 等 VLA 模型上显著提升了实机操作的泛化性能。
TL;DR
本研究提出了一套高效的视频转译方案,通过将低成本的仿真机器人轨迹转换为高保真的写实视频,解决了 VLA 模型在现实场景中因视觉多样性不足导致的泛化失效问题。通过引入 Velocity Caching(速度缓存) 和 Coreset Sampling(核心集采样),研究者在将生成成本降低 60% 的同时,显著提升了 RDT-1B、π0 等主流模型的实机表现。
1. 痛点:机器人的“记忆陷阱”
在具身智能领域,VLA(Vision-Language-Action)模型的训练面临一个悖论:现实数据太贵,仿真数据太假。目前的模型在整洁、静态的仿真环境中能达到近乎完美的表现,但一旦进入现实世界,光照的一点点变化或桌面上多出一个杂物,成功率就会暴跌。
作者指出,这种**脆弱性(Brittleness)**的本质是模型在“记忆”固定的动作序列,而非“学习”任务背后的物体特征与操作逻辑。
2. 核心架构:语义驱动的视频转译
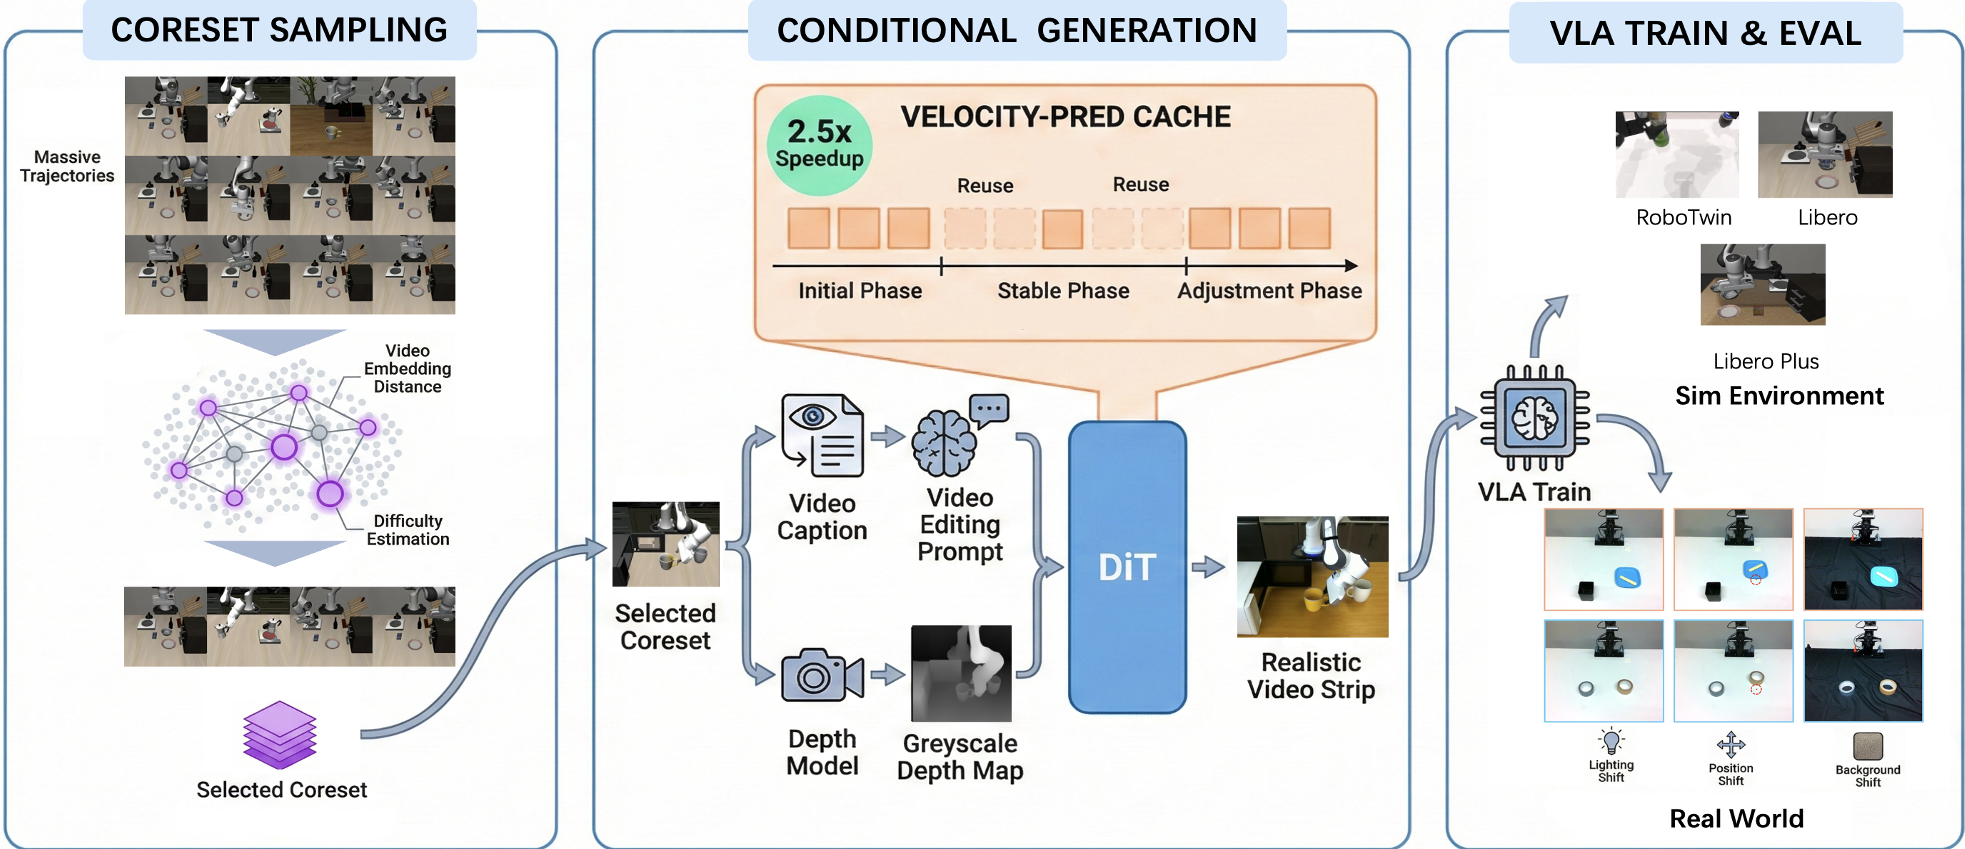
为了填补虚实鸿沟,作者构建了一个四阶段的增强流水线:
- 特征提取:利用 VideoChat2 提取视频描述,并导出深度图(Depth Map)作为几何约束。
- 语义重写:利用 Qwen3-8B 对环境描述进行“魔改”,例如将“不锈钢桌面”改为“大理石纹理”,在保持动作逻辑不变的前提下丰富背景多样性。
- 条件合成:使用 Cosmos-Transfer 2.5 模型,以深度图为“骨架”,以重写后的文本为“肤色”,合成全新的写实视频。
3. 效率革命:让增强跑得更快、更准
大规模合成视频是极其耗费计算资源的。为此,本文贡献了两大“减负”杀手锏:
3.1 Velocity Caching(速度缓存)
研究发现,扩散模型在去噪过程中,相邻时间步的“速度向量(Velocity)”存在高度冗余。作者将推断过程分为:
- 初始阶段:逐步计算,捕获剧烈变化的特征。
- 稳定阶段:每 步计算一次,中间步骤直接复用缓存。
- 调整阶段:最后几步精细修正。 该算法在测试中节省了 61.2% 的生成时间,且几乎没有视觉损失。
3.2 Coreset Sampling(核心集采样)
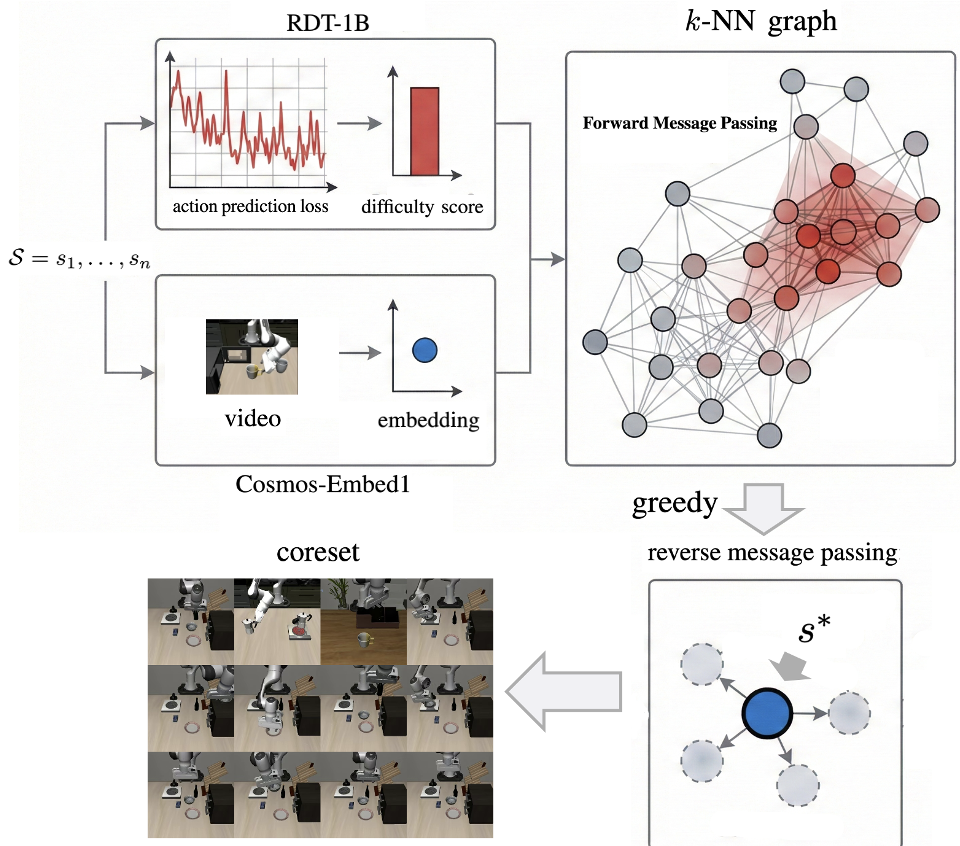
与其盲目增强所有数据,不如精准打击。作者提出一种基于**难度(Policy Loss)和视觉多样性(Cosmos-Embed1)**的筛选机制。通过构建 k-NN 图并进行信息传递,系统会优先选择那些模型还没学好且在视觉空间中具有代表性的轨迹,不仅节省了能量,还得出了更强的模型。
4. 实验见真章:不仅是 SOTA,更是强健性
在 Robotwin 2.0 和真实的 AgileX Piper 机器人平台上,该框架表现亮眼:
- 在 Hard 模式(充满干扰的环境)下,RDT-1B 成功率提升了 10%。
- 抗干扰能力:在 LIBERO-Plus 评测中,针对光照变化和物体布局变动,成功率分别提升了 3.7% 和 16.6%。
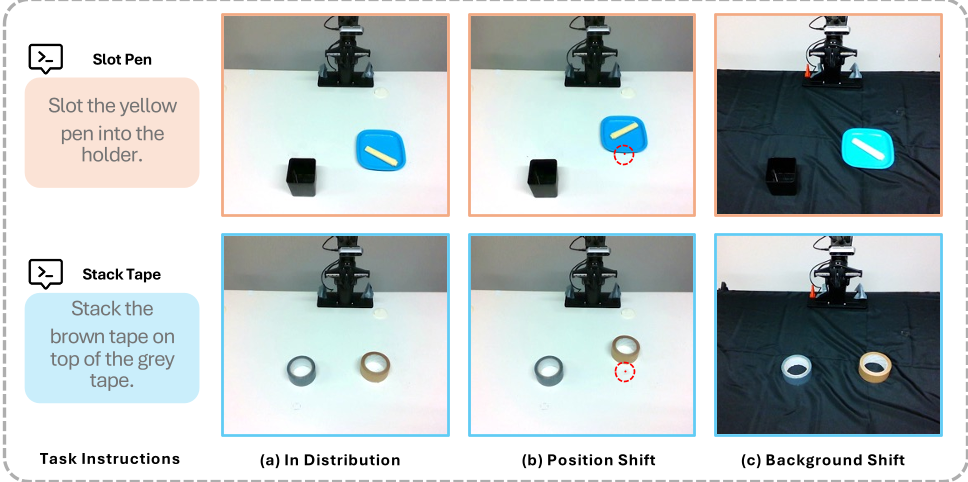
- 实机测试:在“插笔进架(Slot Pen)”和“堆叠胶带(Stack Tape)”任务中,面对未见过的背景背景,成功率从 60% 稳步提升至 75%。
5. 总结与深度洞察
本文的核心价值在于,它不仅仅是做了一次“滤镜转换”,而是通过**几何一致性(深度图)和语义多样性(LLM 改写)**的结合,真正触达了 VLA 数据增强的本质。
局限性分析:虽然视频转译能解决视觉域的差异,但目前的方案对几何动力学(如相机视角、机械臂初始姿态)的扰动改善有限。未来的方向或许在于如何通过扩散模型进一步干预物理交互层面的增强。
通过 Seeing Realism from Simulation,我们看到一个未来的趋势:未来的机器人可能并不需要在现实中苦练万遍,而是在一个被生成模型无限拓宽的“写实幻境”中完成进化。