
[Tencent 2026] MTP-D:通过自蒸馏与循环扩展,让 LLM 推理效率突破瓶颈
Self-Distillation for Multi-Token Prediction
本文提出了 MTP-D,一种针对多 Token 预测 (Multi-Token Prediction) 的自蒸馏框架。该方法通过将主预测头的知识蒸馏至 MTP 辅助头,显著提升了辅助头的 Token 采纳率,配合“循环扩展”策略,在不损失主模型性能的前提下实现了高达 2.2 倍的推理加速。
TL;DR
推理速度一直是制约大语言模型(LLM)大规模落地的核心瓶颈。Multi-Token Prediction (MTP) 技术通过并行预测未来多个 Token 来换取速度,但辅助头的“不给力”限制了实际收益。腾讯大模型团队提出的 MTP-D 框架,通过优雅的**自蒸馏(Self-Distillation)和循环扩展(Looped Extension)**策略,在保证模型模型质量的前提下,实现了翻倍的推理加速。
背景定位:MTP 的理想与现实
传统的 Next-Token Prediction (NTP) 是逐个 Token 生成的,就像挤牙膏,效率极低。MTP 的出现让模型能“一眼看多步”,通过多个辅助 Head 并行给出候选 Token。然而,业界目前面临两个尴尬:
- 采纳率魔咒:只要有一个 MTP 头预测错了,后面的预测全部作废。随着预测长度增加,累计成功率(CAR)掉得比股票还快。
- 训练跷跷板:增加 MTP 头往往会干扰主模型的性能,导致“顾此失彼”。
核心机制:MTP-D 的三大杀手锏
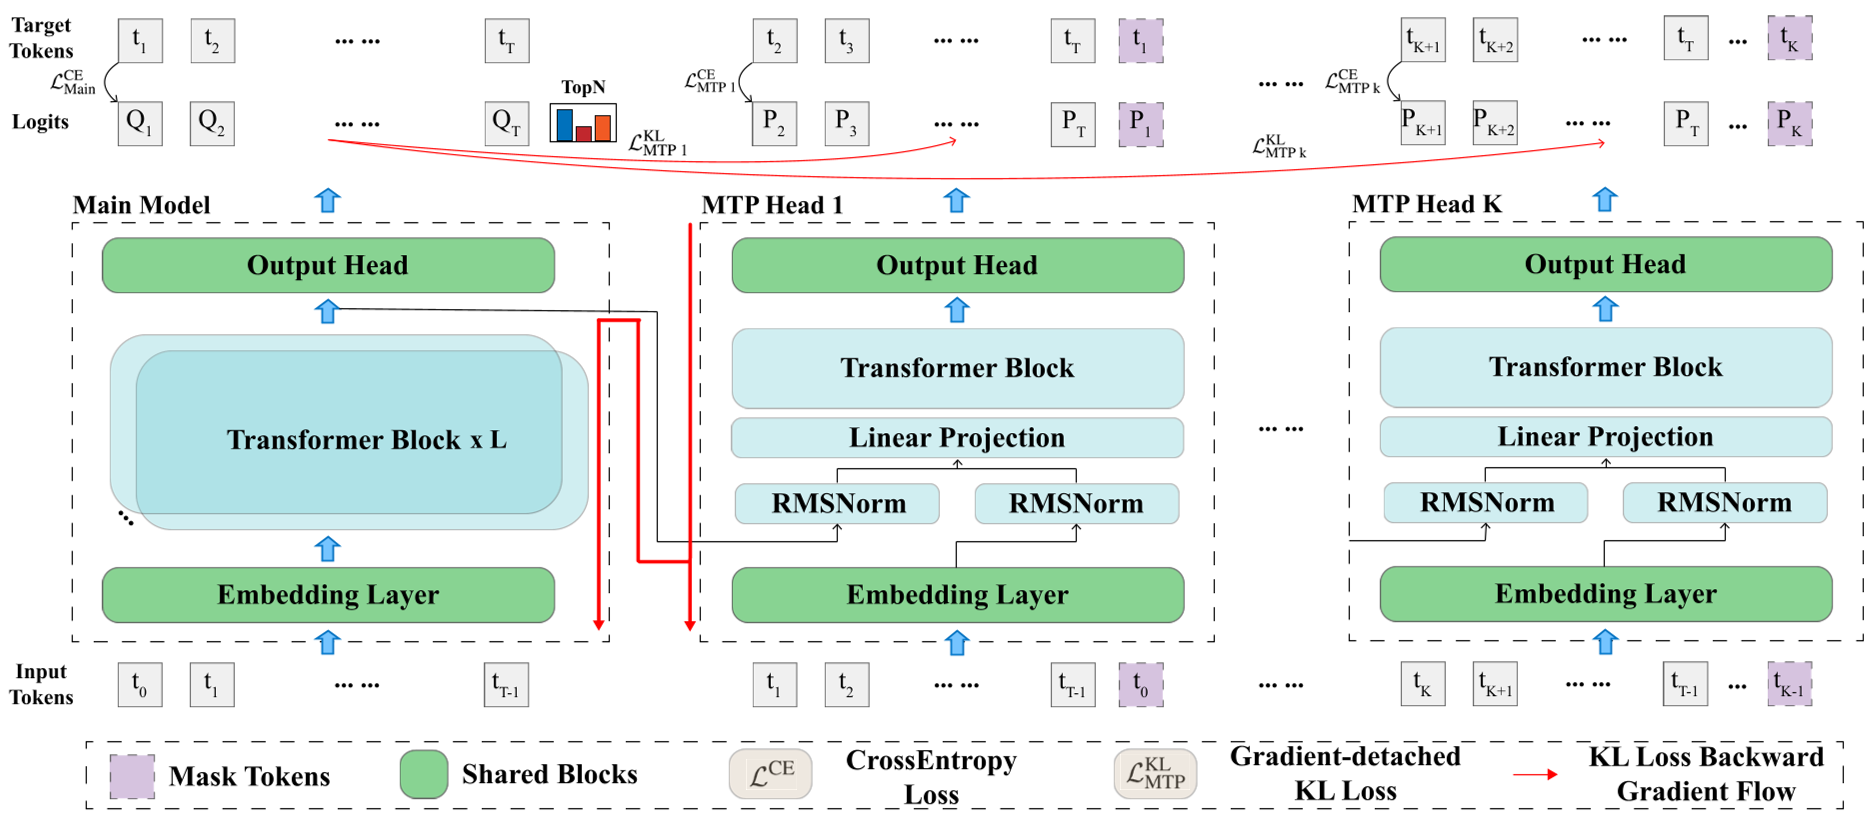
1. 梯度截断的自蒸馏 (Gradient-detached Self-Distillation)
作者认为,MTP 辅助头之所以采纳率低,是因为它们没能学到主头(Main Head)那深邃的语义分布。
- 做法:把主头当成“老师”,MTP 头当成“学生”。利用 KL 散度让学生模仿老师的 Logits 分布。
- 直觉 (Insight):为了不让“差生”带坏“老师”,作者对主头的 Logits 进行了 Stop-gradient 处理。这意味着知识只从主头流向 MTP 头,而不允许 MTP 的低质量梯度反向污染主模型。
2. TopN 概率选择
现代 LLM 词表动辄 10 万+。如果对全量 Logits 做蒸馏,不仅内存吃不消,那些概率极低的“噪声 Token”还会干扰学习。
- 深度洞察:作者通过分析发现,Top 10,000 的 Token 已经覆盖了 99.5% 以上的概率分布。通过只对 TopN 进行蒸馏,既保证了数值稳定性,又极大降低了显存开销。
3. 循环扩展策略 (Looped Extension)
想把 MTP 头从 4 个增加到 16 个?传统的从头训练大法非常昂贵。
- 巧妙方案:由于级联 MTP 架构具有结构一致性,作者将已训练好的 个头的参数,复制并初始化给下一组 个头。利用极小规模的数据(如 70B tokens)进行继续预训练(Continued Pre-training),就能实现规模的平滑扩张。
实验战绩:丝滑加速,分毫未损
在 2B Dense 和 A1B MoE 两大架构上,MTP-D 展示了统治级的表现:
- 性能保全:主预测头的 Accuracy 在增加辅助头后几乎没有下降,解决了业界的“跷跷板效应”。
- 极致加速:在 4-to-16 的循环扩展实验中,即使是第 16 个辅助头,在数学推理(MATH)等逻辑性强的任务中依然能保持一定的采纳率,最终实现 220.4% 的加速。
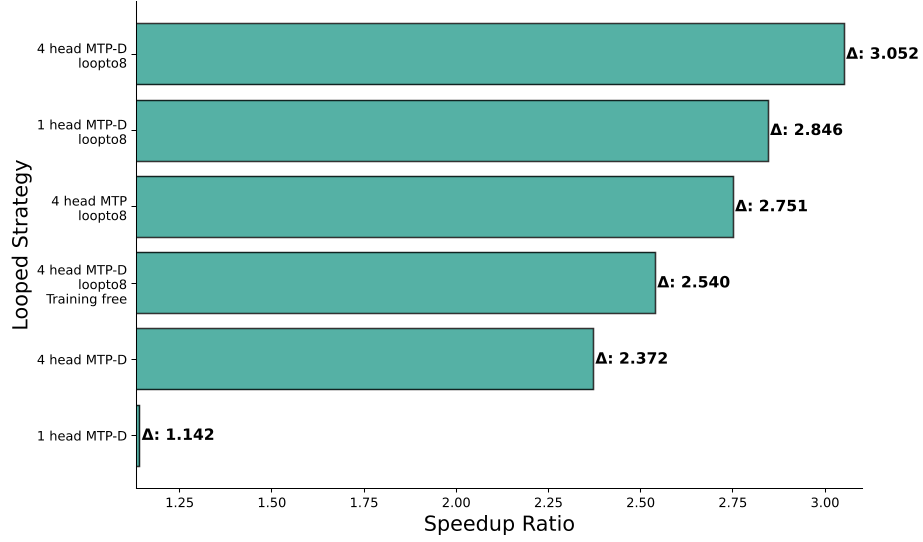 上图展示了不同扩展策略下的加速比曲线,MTP-D(粉色线)在各任务中均显著优于基线。
深度分析:为什么 MTP-D 真的有效?
- 超越 Cross-Entropy 的监督:传统的 MTP 只用 Ground-truth 做 Cross-entropy 训练。但这太“死板”了。自蒸馏让辅助头学会了主模型对词表的整体认知(哪些词是可能的,哪些是绝对不可能的),从而提高了容错率。
- 结构一致性的红利:DeepSeek 风格的级联架构天然支持这种“循环扩展”。实验证明,这种初始化方式比随机初始化能更快达到收敛,且捕捉到了辅助头之间的内在高相关性。
总结与局限
MTP-D 为 LLM 推理优化开辟了一条低成本、高收益的新路径。
- 启示:未来的预训练模型可能不再只交付一个“单头”版本,而是交付一个自带“高效导航头”的加速版。
- 局限:目前的验证多在 2B 规模模型及预训练阶段进行。在超大规模(如 100B+ 参数)模型以及 SFT/RLHF 阶段的表现,仍有待工业界的进一步验证。
资深主编评价:这是一篇典型的“简洁且有力”的工业界论文。它没有堆砌复杂的数学公式,而是敏锐地抓住了 MTP 架构的物理特性(结构一致性),通过自蒸馏解决了分布对齐的核心矛盾,具有极高的实战参考价值。