
TACO:让终端智能体在喧嚣的日志中“进化”出清醒头脑
A Self-Evolving Framework for Efficient Terminal Agents via Observational Context Compression
本文提出了 TACO,一种针对终端智能体(Terminal Agent)的即插即用、自我进化的观察上下文压缩框架。该框架通过从交互轨迹中自动发现并提炼压缩规则(Rules),在显著降低 Token 开销的同时,提升了智能体在长程任务中的 SOTA 表现。
TL;DR
在软件工程自动化的浪潮中,终端智能体(Terminal Agents)常被湮没在万行级的编译日志和包安装输出中。本文介绍的 TACO (Terminal Agent Compression) 框架,通过一套自我进化的规则体系,自动识别交互过程中的冗余,将杂乱的终端反馈压缩为语义清晰的摘要。实验证明,这不仅能通过减少噪声提升 Agent 的决策准确率(+1%~4%),还能显著降低 Token 成本。
背景:被日志“吞噬”的推理能力
终端任务(如调试、编译、环境搭建)具有典型的“长程迭代”特征。每一次命令执行返回的原始输出可能包含 90% 的无效信息(如 git 克隆进度条、反复出现的配置检查)。
传统方法存在两大痛点:
- 静态规则失效:手动编写规则难以覆盖所有工具(pip, docker, cmake, 甚至自定义脚本)。
- 信噪比平衡难:粗暴的截断可能切掉最关键的错误堆栈(Error Traceback),导致推理断裂。
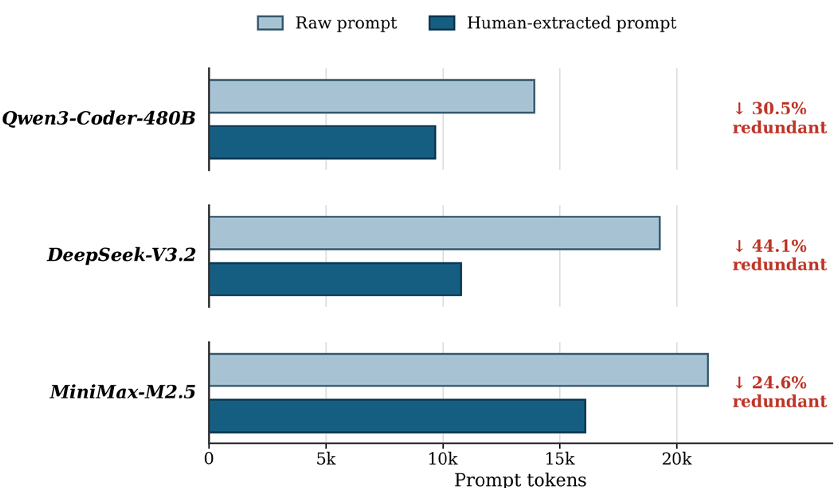
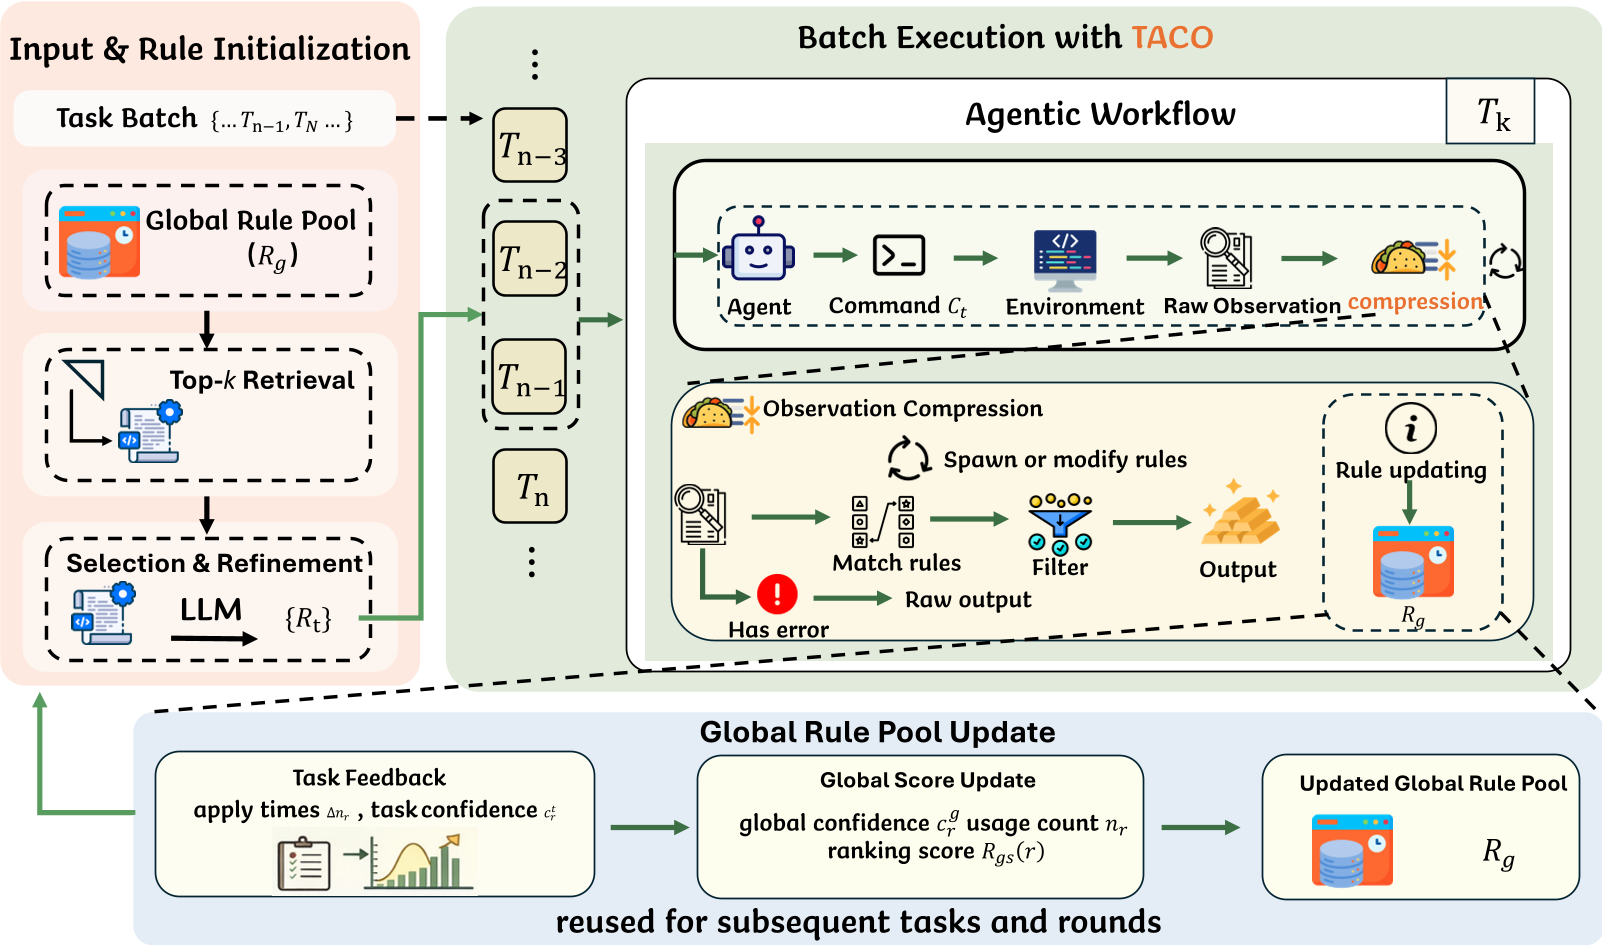
核心算法:TACO 的“三位一体”进化论
TACO 的本质是一个符号化的、无须训练的自适应适配器。其核心架构由三个关键维度驱动:
1. 结构化规则定义 (Rule Schema)
不同于简单的文字总结,TACO 生成的是具有逻辑约束的 JSON 规则:
- Trigger Regex: 识别特定命令(如
apt-get install)。 - Keep Patterns: 强制保留的核心信号(如
ERROR,Failed)。 - Strip Patterns: 明确剔除的背景噪声(如进度百分比)。
- Context Control: 保留首尾 行,设定最大行数上限。
2. 任务内的在线进化 (Intra-Task Evolution)
当 Agent 遇到未见过的长输出时,TACO 会调用 LLM 实时“产出”新规则。更巧妙的是它的反馈修正机制:如果 Agent 发现压缩后信息不足(例如重新执行了同一条命令),TACO 会判定该规则“过度压缩”,随即撤回并生成更保守的替代方案。
3. 全局规则池演进 (Global Rule Pool)
任务结束后,高质量的规则会被打分并沉淀到全局池。对于新任务,TACO 会基于相似度和得分检索并初始化规则集,实现跨任务的知识迁移。
实验深度解析:效率与质量的双重飞跃
核心战绩
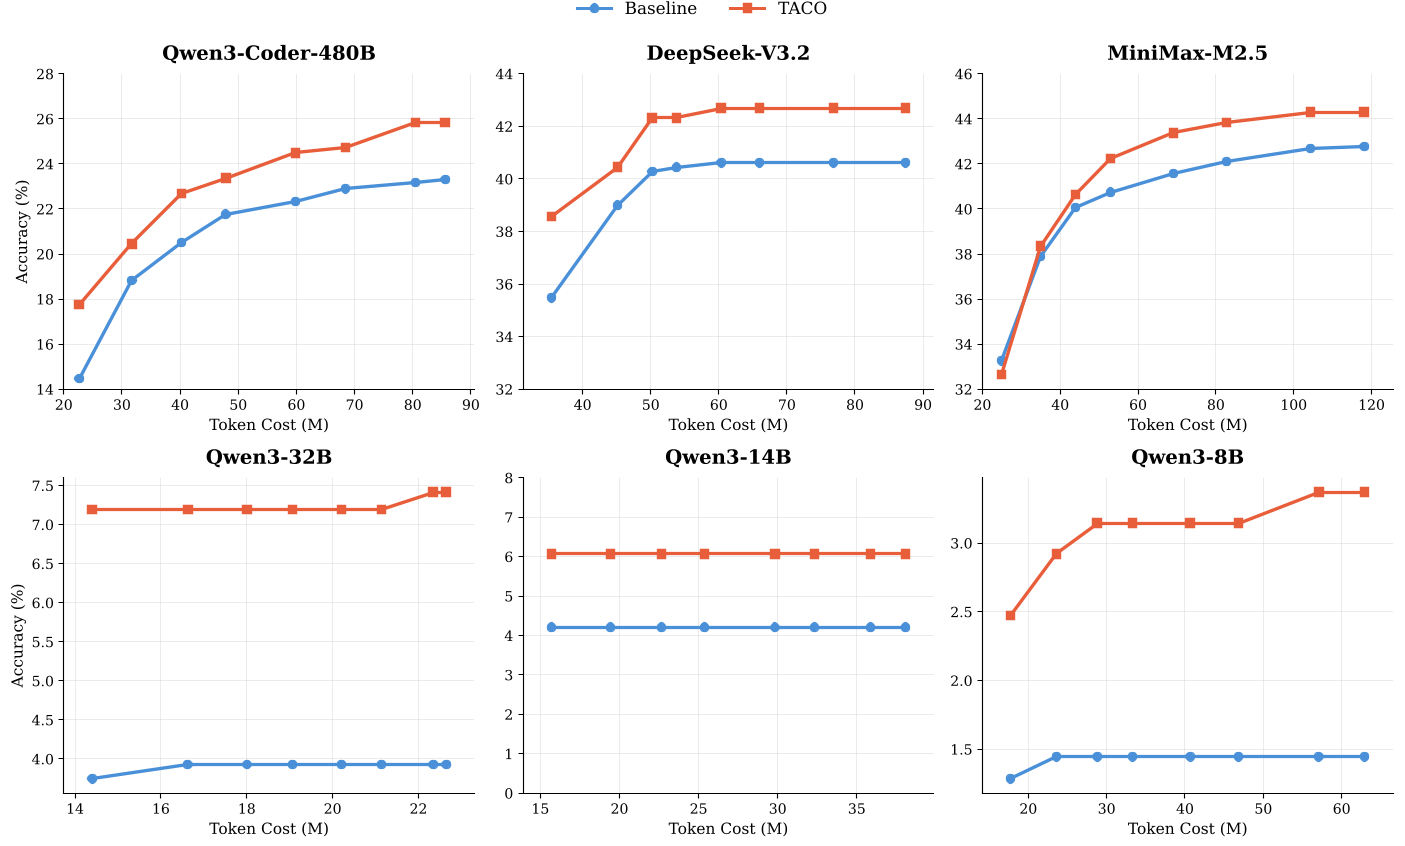
在 TerminalBench 2.0 评测中,TACO 对多种骨干模型(Backbone)均有正面贡献:
- 准确率提升:即使是像 DeepSeek-V3 或 Qwen3-480B 这样的顶级模型,集成 TACO 后准确率仍有显著提升(+2% 左右)。
- Token 效率:大模型的单步 Token 消耗平均降低 10%。更有趣的是,对于小模型,虽然总 Token 可能增加,但这是因为 TACO 赋予了它们“活下去”的能力,让原本在第一步就因过载而崩溃的小模型能够完成更多步骤。
消融研究:规则池真的有用吗?
作者通过消融实验(Ablation Study)论证了:如果去掉“全局演进”,Agent 很快会因为规则质量低而产生 1.7% 的性能滑坡。这证明了规则的持续优化和冷启动初始化是保持系统健壮的核心。
深度洞察:从“语法裁剪”到“语义过滤”
TACO 最令人惊艳的案例在于它处理 apt-get install 的方式。原始输出可能有 10,000 个字符记录 200 个包的解压过程,TACO 进化出的规则能将其精简为 73 字符的“当前状态:正在设置 x11-utils”。这种**任务感知(Task-aware)**的压缩,本质上是将终端环境变成了一个“可搜索的、具有语义索引”的数据库。
局限性与展望
尽管 TACO 在软件工程领域表现出色,但其规则生成仍依赖于底座 LLM 的零样本(Zero-shot)能力。在极端复杂的专有工具链环境中,如何预置更强的先验知识仍是挑战。未来,这种“观察量压缩”的思路若能与强化学习(RL)结合,或许能让 Agent 像人类专家一样,一眼从冗长的 Log 中抓取那致命的一行报错。
总结:TACO 证明了在 Agent 时代,上下文管理不再是一个简单的缓存问题,而是一个动态优化的策略问题。