
SIOP:无需验证器,Agent 也能通过“自我反思”实现回合级信用分配
Self-Induced Outcome Potential: Turn-Level Credit Assignment for Agents without Verifiers
本文提出了 SIOP(Self-Induced Outcome Potential)框架,旨在解决大语言模型 Agent 在缺乏外部验证器(Verifier)和标注时,难以进行 Turn-level(回合级)信用分配的问题。该方法在 7 项搜索增强问答任务中表现出色,平均性能接近有监督基线,并显著超越了现有的无验证器 Outcome-level 方法。
TL;DR
在 Agent 强化学习中,如何判断一个中间的搜索动作或推理步骤是否有用?由于缺乏每一步的标签,这通常是个难题。本文提出的 SIOP (Self-Induced Outcome Potential) 框架通过将模型对同一个问题的多个采样答案进行“语义聚类”,并利用聚类的可靠性来引导中间步骤的信用分配。它成功地在不需要 Gold Answer 的情况下,实现了接近有监督学习的 Turn-level 奖励效果。
1. 痛点:被忽视的中间决策
当前的推理模型(如 OpenAI o1 或 DeepSeek-R1)正在向长程推理演进。Agent 需要不断地调用工具、获取观察并决定下一步。然而,大部分 RL 训练只在最后给一个“对”或“错”的奖赏。
这种 Outcome-only 模式存在两个命门:
- 稀疏性:长距离交互后,模型很难知道是哪一次检索立了功。
- 依赖验证器:在很多现实场景中,我们根本没有现成的 Verifier 来判断结果是否正确。
虽然 IGPO 或 TIPS 等方法尝试引入 Turn-level 奖赏,但它们假设你已经知道了 Gold Answer。SIOP 的出现,就是为了打破“必须有金标才能做过程引导”的局限。
2. 核心机制:将结果聚类作为潜在未来
SIOP 的直觉非常优雅:模型虽然不知道正确答案,但它多次采样的分布隐藏了真理。
2.1 语义结果众数 (Semantic Outcome Modes)
模型针对同一个 Query 生成 个 Rollouts。即便文字不同,语义可能一致。SIOP 使用 NLI(自然语言推理)模型将这些答案聚类。每一个聚类 代表一种潜在的“未来结局”。
2.2 可靠性校准 (Reliability Calibration)
为了防止“一本正经胡说八道”的错误答案占据多数,SIOP 引入了校准。它利用 NLI 模型检查检索到的原文 obs 是否能支撑某个聚类的答案。
公式直觉:一个聚类的权重 不仅取决于它出现的频率,还取决于它与环境观察的契合度。
2.3 势函数驱动的回合奖赏
这是 SIOP 的核心数学贡献(参考图 1 架构):
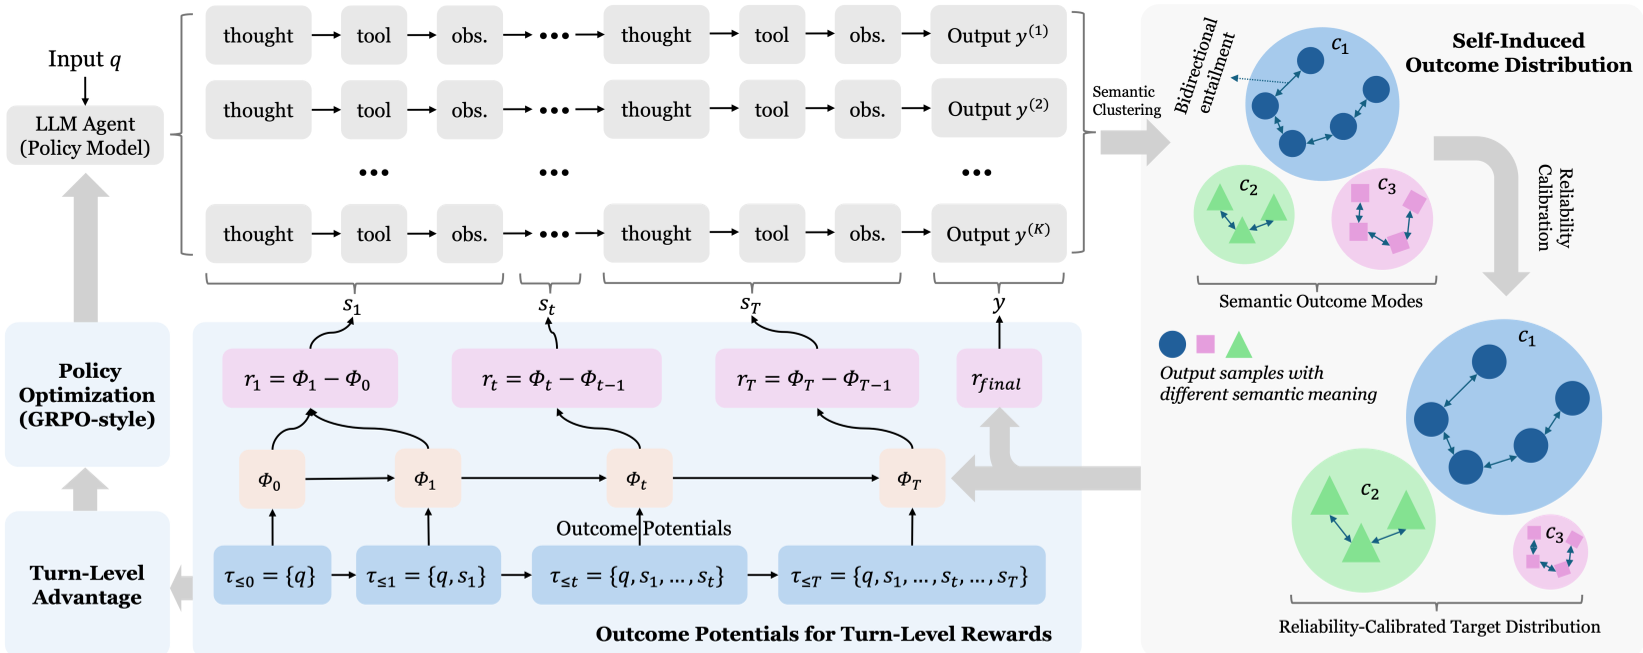
定义势函数 为当前前缀对可靠目标的“支持度”。每一回合的 Process Reward 定义为: 如果这一步动作(比如一个精准的搜索词)显著提高了模型最终给出可靠答案的概率,这一步就会获得高分。
3. 实验结果:填补监督鸿沟
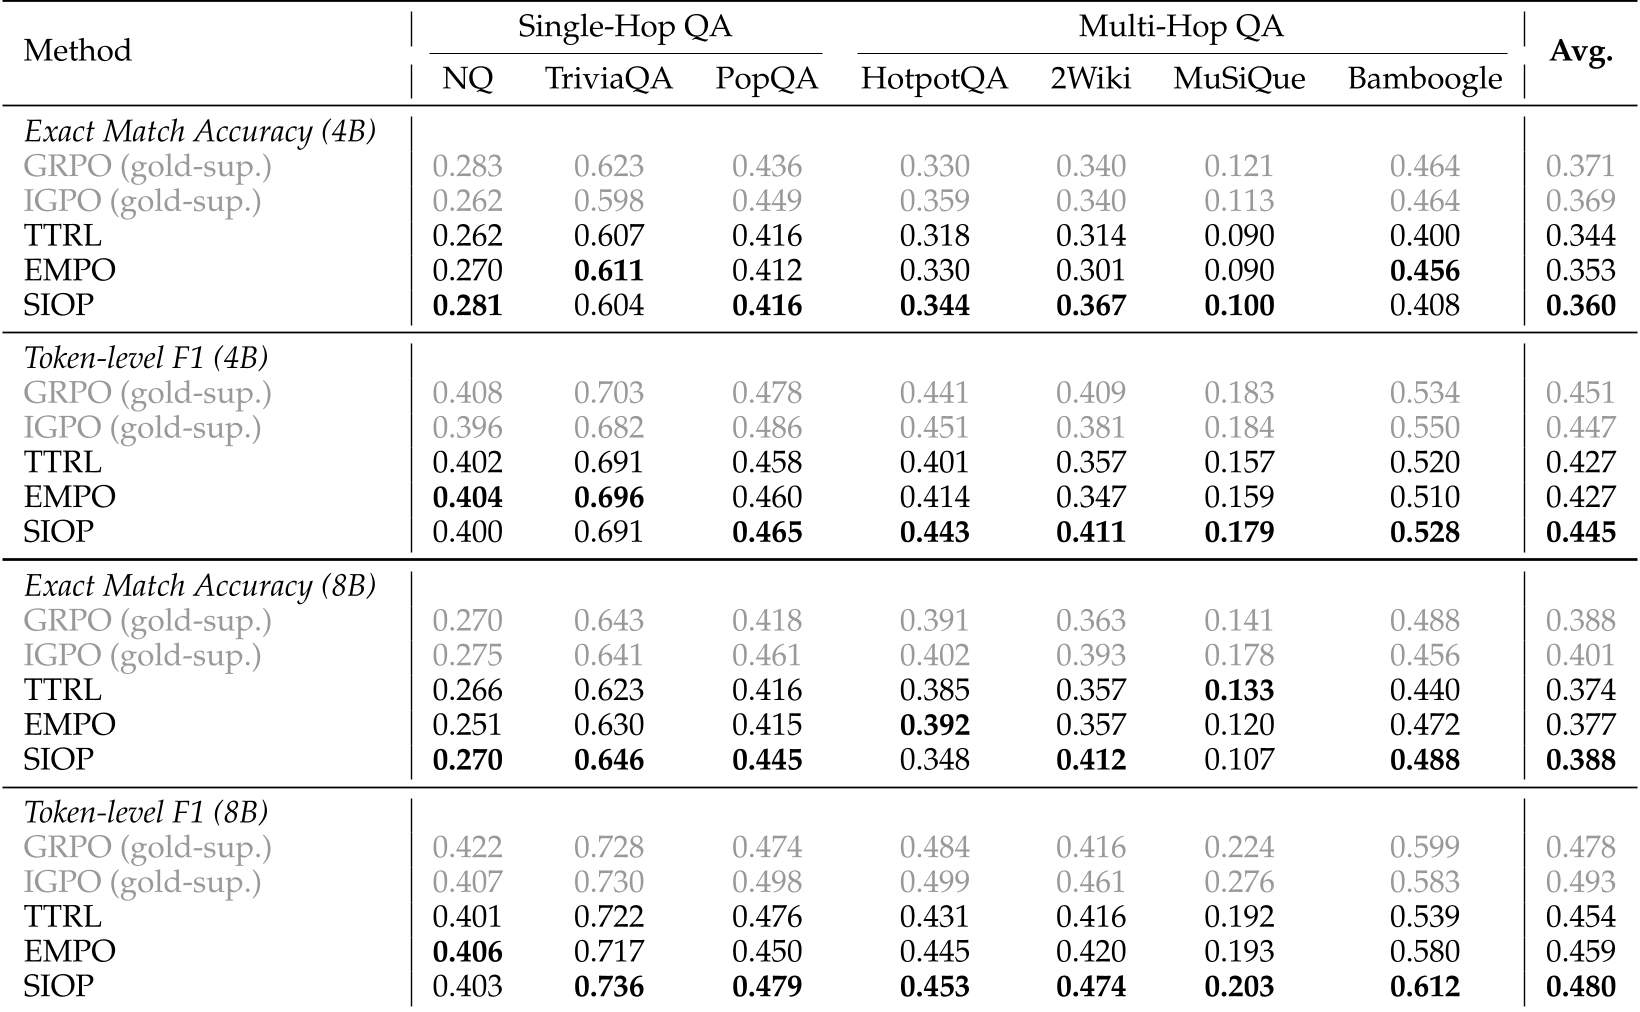
作者在 NQ、HotpotQA 等 7 个基准测试上进行了严苛的测试,并对比了有监督的 GRPO 和 IGPO。
关键发现:
- 超越无监督基线:在 4B 模型上,SIOP 的 2Wiki EM 值比之前的 EMPO 高出 6.6%。
- 逼近有监督表现:SIOP 在完全没有金标的情况下,其 F1 表现几乎追平了使用金标的 GRPO。
- 训练动力学:如图 2 所示,SIOP 训练出的 Agent 倾向于生成更短且更低熵的响应,减少了冗余的搜索次数。
4. 深度洞察:为什么这有效?
SIOP 的成功在于它解决了 Credit Assignment(信用分配) 的精度问题。传统的 GRPO 会将结果奖赏均匀地广播(Broadcast)到轨迹中的所有 Token 上,这会导致“噪声”很大。
SIOP 通过 Turn-specific Advantage,只对当前回合生成的 Token 进行奖励。通过消融实验(表 3)可以发现,如果去掉这种回合级的信用分配,改为传统的广播式分配,性能会大幅下降。这意味着“把功劳记在对的步骤上”比“给出一个高的结果分”更重要。
5. 局限与未来
虽然 SIOP 在检索增强任务中表现惊人,但它依赖于 NLI 模型的高质量评判能力。在极度抽象、模糊或涉及复杂代码/数学逻辑的场景下,如何构建更稳健的“语义聚类”仍是挑战。
总结
SIOP 为我们展示了“自监督”在 Agent 领域的新高度:通过数学上严谨的势函数设计,模型可以利用自己的输出分布作为阶梯,在没有老师(标注)的情况下,学会如何更聪明地调用工具。