
LDM:自监督学习的“大统一理论”报告
Understanding Self-Supervised Learning via Latent Distribution Matching
本文提出了潜变量分布匹配 (Latent Distribution Matching, LDM) 框架,为自监督学习 (SSL) 提供了统一的数学解释。该框架通过将 SSL 形式化为数据分布与预设潜变量模型的匹配问题,成功统一了对比学习、非对比学习及预测型 SSL 方法(如 SimCLR, VICReg, CPC, JEPA 等)。
TL;DR
自监督学习(SSL)长期以来被视为一种“炼丹术”,依赖于各种防止模型崩溃的技巧。本文提出的 潜变量分布匹配 (Latent Distribution Matching, LDM) 框架,通过严谨的数学推导,将对比、非对比及预测型 SSL 全部纳入统一的统计学范畴。更重要的是,它证明了为什么简单的预测任务就能让模型“理解”现实世界的物理特征。
痛点深挖:互信息(MI)的迷思
许多研究将 SSL 解释为最大化两个视图(View)之间的互信息。然而,作者指出 MI 有一个致命缺陷:它是可逆变换不变的。这意味着,如果你对表征做一套复杂的“乱码”变换,只要变换可逆,MI 依然保持最高,但得到的表征却毫无语义价值。
作者认为,SSL 表现好的真正原因不是 MI,而是它在通过 潜变量熵最大化 隐式地执行分布匹配。
核心机制:潜变量分布匹配 (LDM)
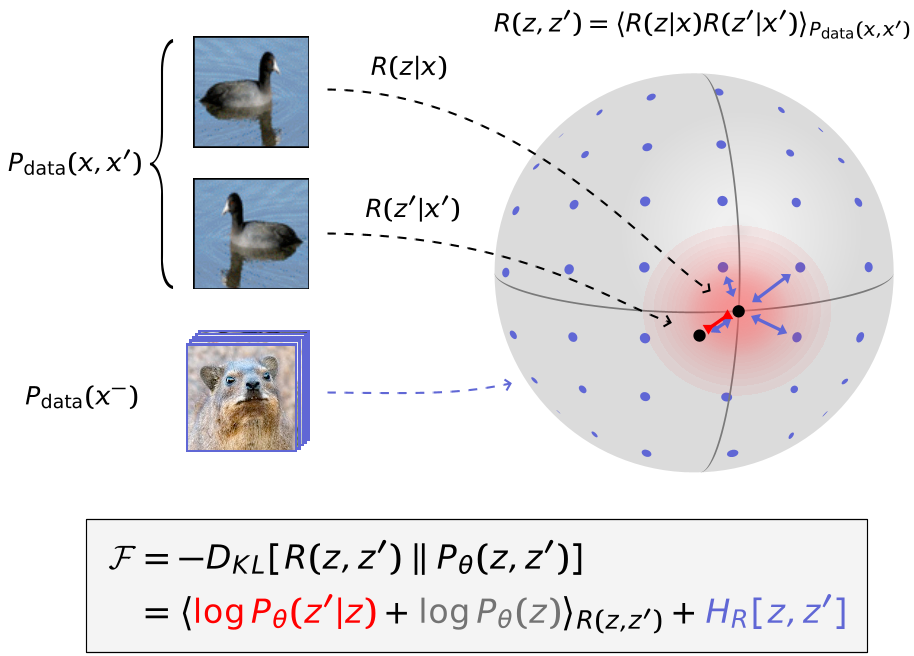
LDM 的核心逻辑可以用一个简洁的公式表达:
- 对齐 (Alignment):让编码后的潜变量符合我们假想的物理或数学模型(如高斯分布、Kalman 滤波)。
- 均匀性 (Uniformity):通过最大化熵,强制编码器将数据流形“铺开”,防止所有输入都映射到同一点(即 Collapse)。
统一视角下的 SSL 家族
作者展示了现有主流方法如何被视为 LDM 的特定实例:
- SimCLR:相当于假设潜变量服从球面冯·米塞斯-费舍尔(vMF)分布,并利用 KDE 估计熵。
- VICReg:相当于假设潜变量服从平面高斯分布,利用 LogDet 估计熵。
- Predictive SSL (如 JEPA):则是假设了随时间演化的预测模型,并利用 Stop-gradient 隐式估计条件熵。
深度创新:带不确定性的 Kalman-SSL
基于 LDM 理论,作者派生出了一种新型 SSL 方法:将 Kalman 滤波器 嵌入到潜变量空间。
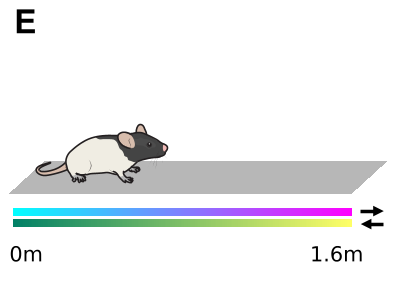
传统的 SSL 只能告诉你“未来的表征是什么”,而基于 LDM 的 Kalman-SSL 不仅能预测未来,还能给出 置信区间(Uncertainty Quantification)。这在处理带噪声的生物信号(如大鼠海马体神经元放电)时展现了巨大的威力。
理论支柱:可辨识性 (Identifiability)
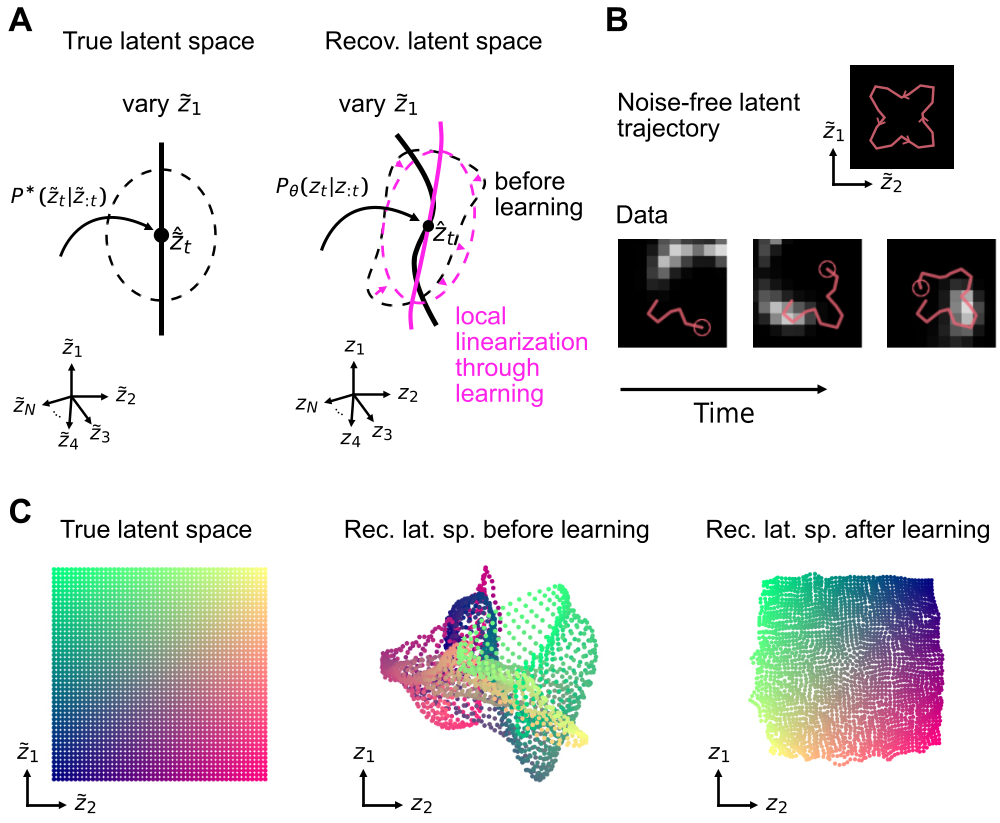
这是本文最硬核的部分。作者通过 Theorem 1 证明:只要预测误差呈高斯分布,且编码器在数据流形上可逆,最优的 SSL 模型所学习到的表征必定与“真实”潜变量服从 仿射变换 (Affine Transformation) 关系。这意味着模型学到的不仅是特征,更是由于物理规律约束而产生的真实坐标。
总结与展望
本文的深度见解在于:SSL 的成功很大程度上取决于我们如何通过潜变量模型向模型“注入”先验。SSL 的潜变量空间往往有数千维,而图像的真实维度很低,这说明 SSL 并非在做压缩,而是在做几何上的 解缠绕 (Untanglement)。
局限性:在高维空间(N > 4)中,由于采样稀疏,熵最大化变得极度困难,这就是为什么超大规模潜变量空间的 SSL 仍难以完美模拟真实物理世界。未来,设计更高效的熵估计架构(Entropy Estimator)将是该领域的终极战况。