
别再为“数学噪声”买单:语义召回率(Semantic Recall)重塑向量检索评估
Semantic Recall for Vector Search
本文提出了 Semantic Recall(语义召回率),这是一种评估近似最近邻搜索(ANNS)算法质量的新指标。与传统召回率不同,该指标仅关注那些在数学近邻中且被专家/LLM判定为语义相关的对象,消除了对检索“数学噪声”的惩罚。
TL;DR
在向量检索(Vector Search)领域,我们长期奉为圭臬的 Recall(召回率) 指标可能一直误导了我们。Google 与 CWI 的研究人员指出:传统召回率强迫算法去寻找那些“数学上靠得近、语义上没屁用”的噪声点。本文提出的 Semantic Recall 和 Tolerant Recall 能够将搜索成本降低高达 35%,同时不损失任何用户感知的检索质量。
痛点深挖:传统召回率的“精确谬误”
目前评估 ANNS(近似最近邻搜索)的标准做法是:用暴力搜索(Exact NNS)算出前 K 个最接近的向量作为 Ground Truth,看 ANNS 算法能找回多少。
但这存在一个致命缺陷:嵌入模型并不完美。在嵌入空间里,某些对象虽然距离查询向量非常近,但其背后的语义完全不相关。
- 数学噪声:这些不相关但距离近的点就像是特征空间里的杂讯。
- 无效惩罚:如果一个算法没找回这些“噪声”,传统召回率会给出一个很低的分数,尽管用户根本不在乎这些点。
- 资源浪费:为了找回这些极难捕捉的噪声点,工程师往往不得不增加搜索半径或分区探测数,导致计算成本剧增。
核心贡献:语义召回率 (Semantic Recall)
作者提出,我们应该只衡量那些“既在数学近邻内,又在语义上相关”的对象。
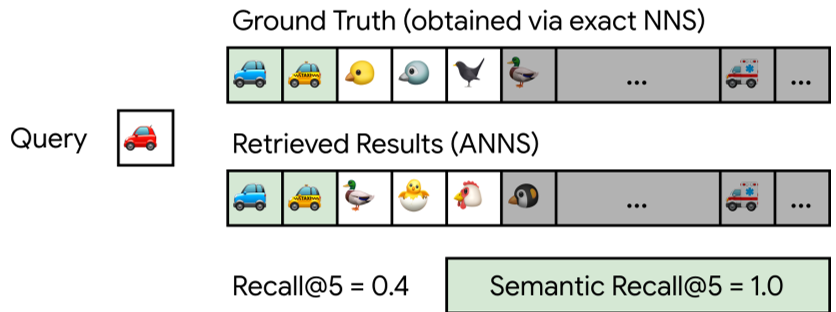 注:图中绿色部分代表语义相关的数学近邻,这才是 ANNS 应该关注的目标。
1. 技术实现:由 LLM 担任评判官
如何判定语义相关性?作者并没有采用昂贵的人工标注,而是利用 LLM-as-a-Judge。由于只需要判定 Ground Truth 中前 100 个结果(而非全量数据集),这种方法的开销是可接受的。实验显示,Gemini 与 Claude 在相关性判定上的高度一致性(约 91.1%),证明了该方法的鲁棒性。
2. 工程平替:容忍召回率 (Tolerant Recall)
在无法获取原始文本或频繁更新的数据集场景下,作者提出了 Tolerant Recall。其核心逻辑是:如果检索到的点 虽然不在 Ground Truth 里,但它的相似度得分(Score)与 Ground Truth 里的点 非常接近(在 的容忍范围内),我们就认为这次检索是成功的。
实验与结果:成本与质量的博弈
研究人员在 MSMARCO(883万文档)和 MIRACL(泰语数据集)上进行了大规模实验,发现了几个反直觉的结论:
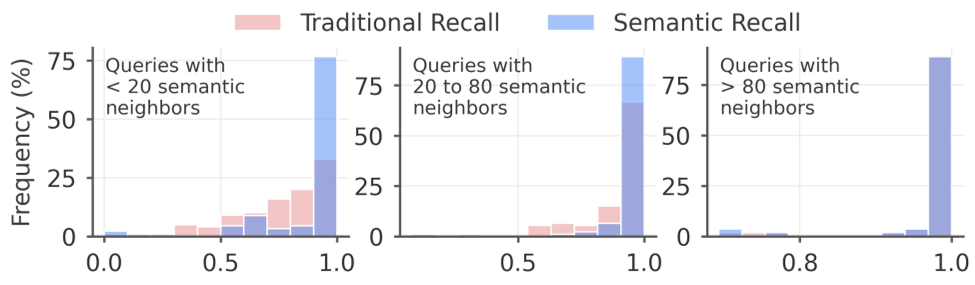
- 二峰分布:约 40% 的查询在近邻中其实只有极少数(0-15个)相关结果。
- 噪声更难找:那些语义不相关的点(non-SN)往往扎堆在某个距离区间,导致算法很难精准区分它们。
- 调优红利:当我们将优化目标从“传统召回率”切换为“语义/容忍召回率”时,搜索效率大幅提升。
 如上图所示,当召回率目标接近 1.0 时,成本呈指数级上升。通过使用更科学的指标,我们可以向左移动曲线。
在保持相同的语义找回效果下,优化 Tolerant Recall 可以让 BigANN 上的成本降低 35%,MSMARCO 上的成本降低约 25%。
深度洞察:为什么这改变了游戏规则?
这篇论文的本质是在挑战 “精确近邻(Exact Neighbor)” 的权威性。在 AI 驱动的检索系统中,向量只是手段,语义才是目标。
- 对架构师的启示:不要再死磕传统召回率的 0.99 了。那多出来的 0.05 可能全是毫无意义的偏置。
- 对算法开发者的启示:在做向量量化(Quantization)或早期停止(Early-termination)策略时,使用 Tolerant Recall 能让你找到性能更好的超参数组合。
总结与局限
虽然 Semantic Recall 非常直观,但它也存在局限性:
- 依赖评判器:LLM 也会有偏见或理解错误。
- 冷启动问题:对于完全没有相关结果的查询,该指标未定义。
然而,这项工作标志着向量检索评估从“纯几何视角”向“用户价值视角”的重大飞跃。对于任何规模化的向量数据库系统,转向基于语义容忍的评估体系,其带来的成本节约将直接转化为商业上的竞争优势。