
重新定义泛化:剥离概率假设,回归几何直觉
Separating Geometry from Probability in the Analysis of Generalization
本文提出了一种解析泛化(Generalization)的新框架,通过扰动分析和变分原理,将传统的概率统计假设与确定性的几何性质剥离开来。该方法涵盖了插值、硬边缘分类器以及凸评价函数等多种场景,在 Hilbert 空间下实现了与 VC 维度相当的最优泛化边界。
TL;DR
在机器学习领域,我们习惯了用“概率”来解释“泛化”。然而,Maxim Raginsky 和 Benjamin Recht 的这篇力作挑战了这一范式。他们证明了:泛化可以被视为一种确定性的几何属性。通过将数据看作优化问题的扰动参数,他们构建了一套不依赖于 i.i.d. 假设的变分原理框架,推导出的边界在数值上竟能与最严苛的统计下界完美匹配。
背景定位:打破对“概率分布”的迷信
通常我们说一个模型“泛化能力强”,前提是假设训练集和测试集来自同一个概率分布。但问题在于,这个分布在现实中是无法观测且无法验证的。作者指出,将“泛化”与“分布”强绑定,导致了科研中 empiricism(经验主义)与不可验证理论的混淆。
本研究的动机在于:能否找到一种**确定性(Deterministic)**的方法,仅通过观察算法对数据扰动的敏感度(Sensitivity Analysis),就能预判其在未知数据上的表现?
核心方法:作为参数规划的机器学习
作者将机器学习建模为一种**参数规划(Parametric Programming)**问题。其中,数据集 被视为扰动参数。如果一个算法在面临“合理”的数据变动时,其目标函数依然能保持稳定,那么它就具备泛化性。
1. 变分原理 (Variational Principles)
核心公式在于对样本不相似度的量化:
这里的 不再是统计意义上的散度,而是基于模型类 在不同样本点采样算子下的几何差异。
2. 插值算法的几何边界
对于最小范数插值(Minimum Norm Interpolation),作者定义了算子 来捕捉数据带来的约束。
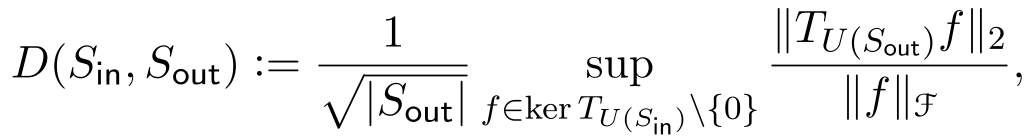
定理 1 的直觉非常深刻:在测试集上的误差,上限取决于模型在满足训练集约束后,在该方向上由于数据变动导致的“范数增长”。
实验与结果:确定性理论意外匹配统计下界
最令人惊讶的结果出现在第四章关于**硬边缘分类器(Hard-margin SVM)**的分析。
作者通过对偶问题和弱对偶性推导出了一个确定性的 Leave-one-out 边界:
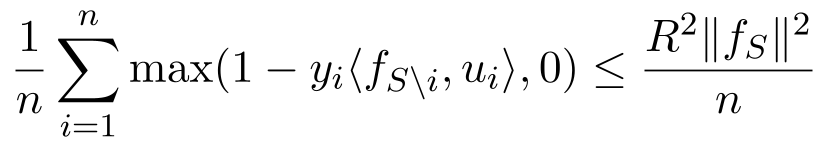
当把这个确定性结果放回随机环境下时,它不仅涵盖了传统的 VC 维度分析,甚至在不需要任何 Rademacher 复杂度等复杂概率工具的情况下,直接达到了学习理论中的最佳下界上限。这有力地证明了:统计上的“平均泛化能力”本质上是确定性几何稳定性的统计表现。
深度洞察:从全局凸性到局部增长
在第五和第六章,作者将这一理论从简单的线性/凸性模型扩展到了满足**二次增长条件(Quadratic Growth)**的非凸领域。
- 算子敏感度:只要损失函数在最小值附近有足够的曲率(Curvature),局部 Lipschitz 常数就能有效地刻画样本变化带来的泛化漂移。
- 统一框架:通过局部化论证,作者将 Hjort 和 Pollard 的凸过程渐进分析转化为了一种普适的、针对任意样本的确定性评估工具。
总结与未来展望
核心价值: 这篇论文为“泛化”剥离了神秘的概率外壳,将其还原为一种深刻的变分几何性质。它解释了为什么某些即便不满足 i.i.d. 的模型(如现实中的深度网络)依然能表现良好——因为它们优化出的解在数据扰动流形上具有极高的几何稳定性。
局限性: 虽然确定性边界很漂亮,但对于某些依赖极端对称性(如 Rademacher 复杂度所利用的交换性)的概率边界,目前的确定性重构还不够直接。
启示: 未来的研究者或许不应再纠结于“分布是否偏移”,而应更多关注模型在参数空间对输入扰动的敏感度矩阵(Hessian 等),那是通往真理的确定性道路。