
锐度感知预训练:打破“强而不稳”的 LLM 开发魔咒
Sharpness-Aware Pretraining Mitigates Catastrophic Forgetting
本文提出了利用 Sharpness-Aware Pretraining(锐度感知预训练)来缓解大语言模型在微调或量化过程中的 Catastrophic Forgetting(灾难性遗忘)。核心方法包括引入 SAM 优化器、提高峰值学习率及缩短退火周期,旨在平衡预训练模型在后续任务中的“学习-遗忘”权衡(Learning-Forgetting Tradeoff)。
TL;DR
在 LLM 开发的共识中,我们默认“预训练底座越强,微调后的成品就越强”。但 Carnegie Mellon University 的最新研究对此提出了挑战:预训练损失最低的模型,往往在微调或量化后最容易崩溃。作者提出通过 Sharpness-Aware Pretraining(锐度感知预训练)改善损失平面的几何特性,仅在预训练末期引入 SAM 优化,就能在 1B 规模模型上减少高达 40% 的量化性能损耗。
背景:模型的“虚胖”与脆弱性
目前的 SOTA 模型(如 Llama-3、OLMo)大多采用 AdamW 配以 Cosine 退火。虽然这能刷出极低的预训练 Loss,但也让模型陷入了极窄(Sharp)的极小值区域。
在这种几何结构下:
- 微调即自残:参数哪怕只更新一点点,损失函数值就会由于陡峭的曲率而剧增,导致预训练知识彻底丢失。
- 量化即毁灭:位宽压缩引入的权重误差会瞬间将模型“弹”出狭窄的波谷。
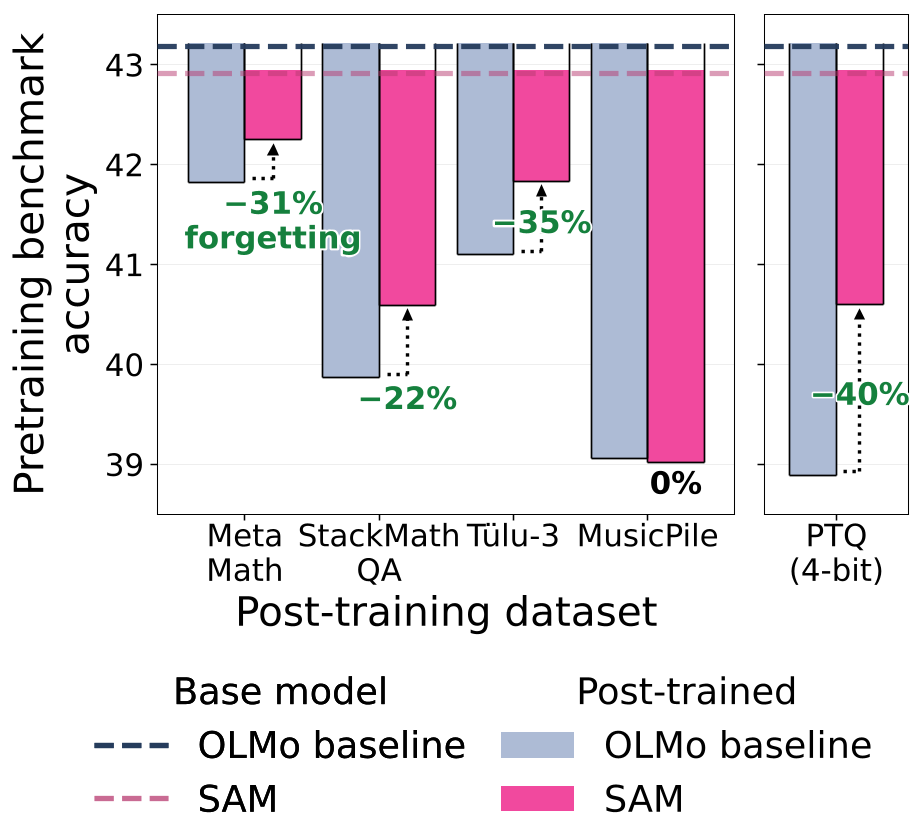 (左图显示 SAM 即使在基座 Loss 稍高时,微调后的遗忘也更少;右图显示其强大的量化鲁棒性)
核心直觉:物理意义上的“平滑”
论文通过二阶泰勒展开揭示了遗忘的物理直觉:
这里的 代表曲率(Sharpness)。减少遗忘只有两条路:要么别动参数(减小 ),要么让损失平面变平(减小 )。作者选择了后者。
实验验证:三种减锐手段
- 显式:SAM 优化器。在更新时进行一次局部“先行探测”,避开陡峭悬崖。
- 隐式:大峰值学习率。根据 Edge of Stability 理论,大步长会自然地将模型“踢”出窄谷,逼迫其进入更宽广的区域。
- 调度:短退火期。不要在 LR 接近 0 的地方磨蹭太久,防止模型过度拟合进极窄的极小值中。
实验战果:更优的“学习-遗忘”权衡
研究团队在 20M 到 1B 的模型尺度上进行了详尽实验。最令人振奋的结论是:SAM 产生的改进随着 Token 预算的增加而扩大。在 192B Token 的高预算下,SAM 相比 AdamW 在 StarCoder 任务上的遗忘量降低了 80%。
 (如图所示,在多个数据集上,SAM 的 Pareto 前沿始终优于 AdamW,即:在达到同样下游性能的前提下,它保留了更多原生能力)
工程创新:Scalable SAM(可扩展的锐度感知)
众所周知,SAM 的计算量是普通优化器的两倍。为了让这套理论在工业界大规模落地,作者尝试了一个天才的策略:仅在 WSD(Warmup-Stable-Decay)调度的最后退火阶段启用 SAM(约占总步数的 10%)。
结论惊人:这种局部干预几乎捕捉到了全流程 SAM 的所有收益,而额外计算成本仅为总额的 10% 左右。
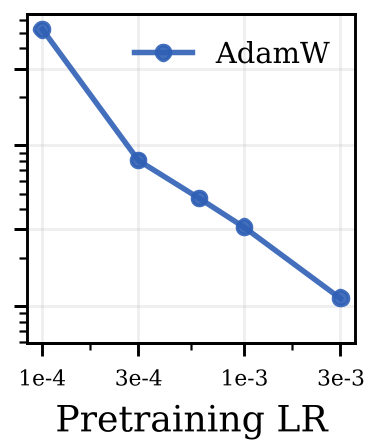 (通过对 Hessian 矩阵的分析证明:SAM 确实通过降低微调方向上的曲率提升了稳定性)
深度视点:从“训练基座”到“训练整个管道”
这篇论文标志着 LLM 训练观念的范式转移:
- 反直觉的基座模型论:一个基座 Benchmark 得分 43.2 的模型,可能不如一个得分 42.9 但更平滑的模型适应性强。
- 量化友好的预训练:我们不再需要事后靠复杂的 PTQ 算法苦苦补救,直接在预训练阶段注入“平滑基因”。
总结
该工作不仅为学术界提供了关于模型几何特性的深刻见解,也为工业界提供了一个即插即用的低成本方案。如果你正面临大模型微调后“智力退化”或量化后精度雪崩的问题,或许是时候在退火阶段加入一点 SAM 魔法了。
名词注释:
- SAM (Sharpness-Aware Minimization): 通过寻求周围领域损失也均衡的参数来搜索平坦极小值。
- WSD (Warmup-Stable-Decay): 一种在大模型预训练中逐渐流行的调度策略。