
SkillOS:赋予 LLM Agent 迭代进化的“数字大脑”
SkillOS: Learning Skill Curation for Self-Evolving Agents
本文提出了 SkillOS,一种基于强化学习(RL)的经验驱动型技能管理框架,旨在构建能够从过去交互中学习并自我进化的 LLM Agent。该方法通过训练一个专门的“技能策展人”(Skill Curator)来自动维护外部 Markdown 格式的技能库(SkillRepo),在 ALFWorld 和 WebShop 等任务中显著提升了 Agent 的执行成功率和效率。
TL;DR
传统的 LLM Agent 往往在完成任务后就“失忆”了。SkillOS 改变了这一点,它采用“策展人-执行器”双模型架构,通过强化学习训练 Agent 如何从失败或成功的经验中总结 Markdown 格式的技能。实验表明,这种自进化的模式不仅让 Agent 变聪明了(成功率提升),还让它变敏捷了(步数减少)。
背景定位:从“单次调用”到“持续进化”
在当前 AI 领域,Agent 的核心瓶颈已从“理解指令”转向“长效学习”。尽管 RAG 或记忆机制能提供信息,但如何将杂乱的轨迹抽象为可复用的 Procedural Memory(程序化记忆/技能) 依然极具挑战。SkillOS 的出现,标志着 Agent 从单纯的经验存储进入到了主动的**技能治理(Skill Curation)**阶段。
痛点深挖:为什么策略管理这么难?
- 反馈延迟:你现在总结的一个技能好不好用,可能要到十次任务后遇到类似场景才知道。
- 噪声干扰:原始轨迹中包含大量无效操作,如果直接存入记忆库,会导致 Retrieval 阶段被噪声淹没。
- 对齐偏差:强大的大模型(如 GPT-4)总结出来的技能,它的小兄弟(如 Llama-8B)执行器可能根本看不懂或学不会。
核心内容:SkillOS 的“策展”艺术
1. 模块化协作流
SkillOS 将系统拆分为两个角色:
- Frozen Agent Executor (执行器):负责干活,根据当前技能库中的指南进行操作。
- Trainable Skill Curator (策展人):负责写指南。它观察执行器的操作轨迹,决定是“新建技能”、“更新旧技能”还是“删除有害技能”。
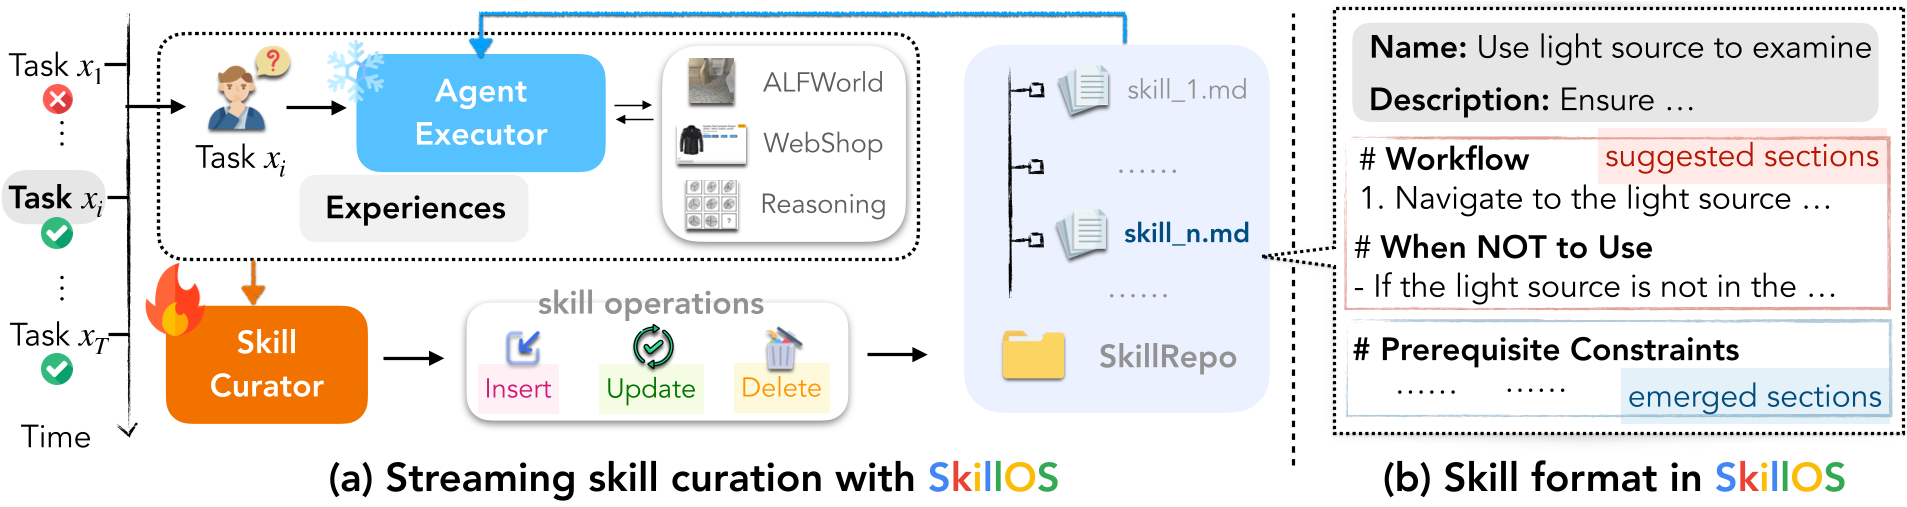 图 1:SkillOS 架构图。策展人通过文件 I/O 操作(Markdown 格式)动态维护技能库。
2. 强化学习秘籍:分组训练与复合奖励
为了解决反馈延迟问题,作者发明了分组任务流。在训练时,不再是一个任务一个任务看,而是把具有“技能依赖”的任务编成一组。策展人对任务 A 的总结,直接在接下来的任务 B、C 中测试效果。
采用 GRPO (Grouped Reward Policy Optimization) 算法,并设计了四重奖励:
- 任务结果奖:后续任务成功了才有高分。
- 格式合法奖:函数调用必须符合规范。
- 内容质量奖:由 LLM-as-a-judge 评估技能是否具有通用见解。
- 压缩奖:鼓励简练,拒绝“流水账”式的轨迹搬运。
实验与结果:小模型也能反超大模型
SkillOS 的表现令人惊喜。在 ALFWorld(家庭任务)和 WebShop(网上购物)中,它全面超越了之前的基线方法(如 ReasoningBank, MemP)。
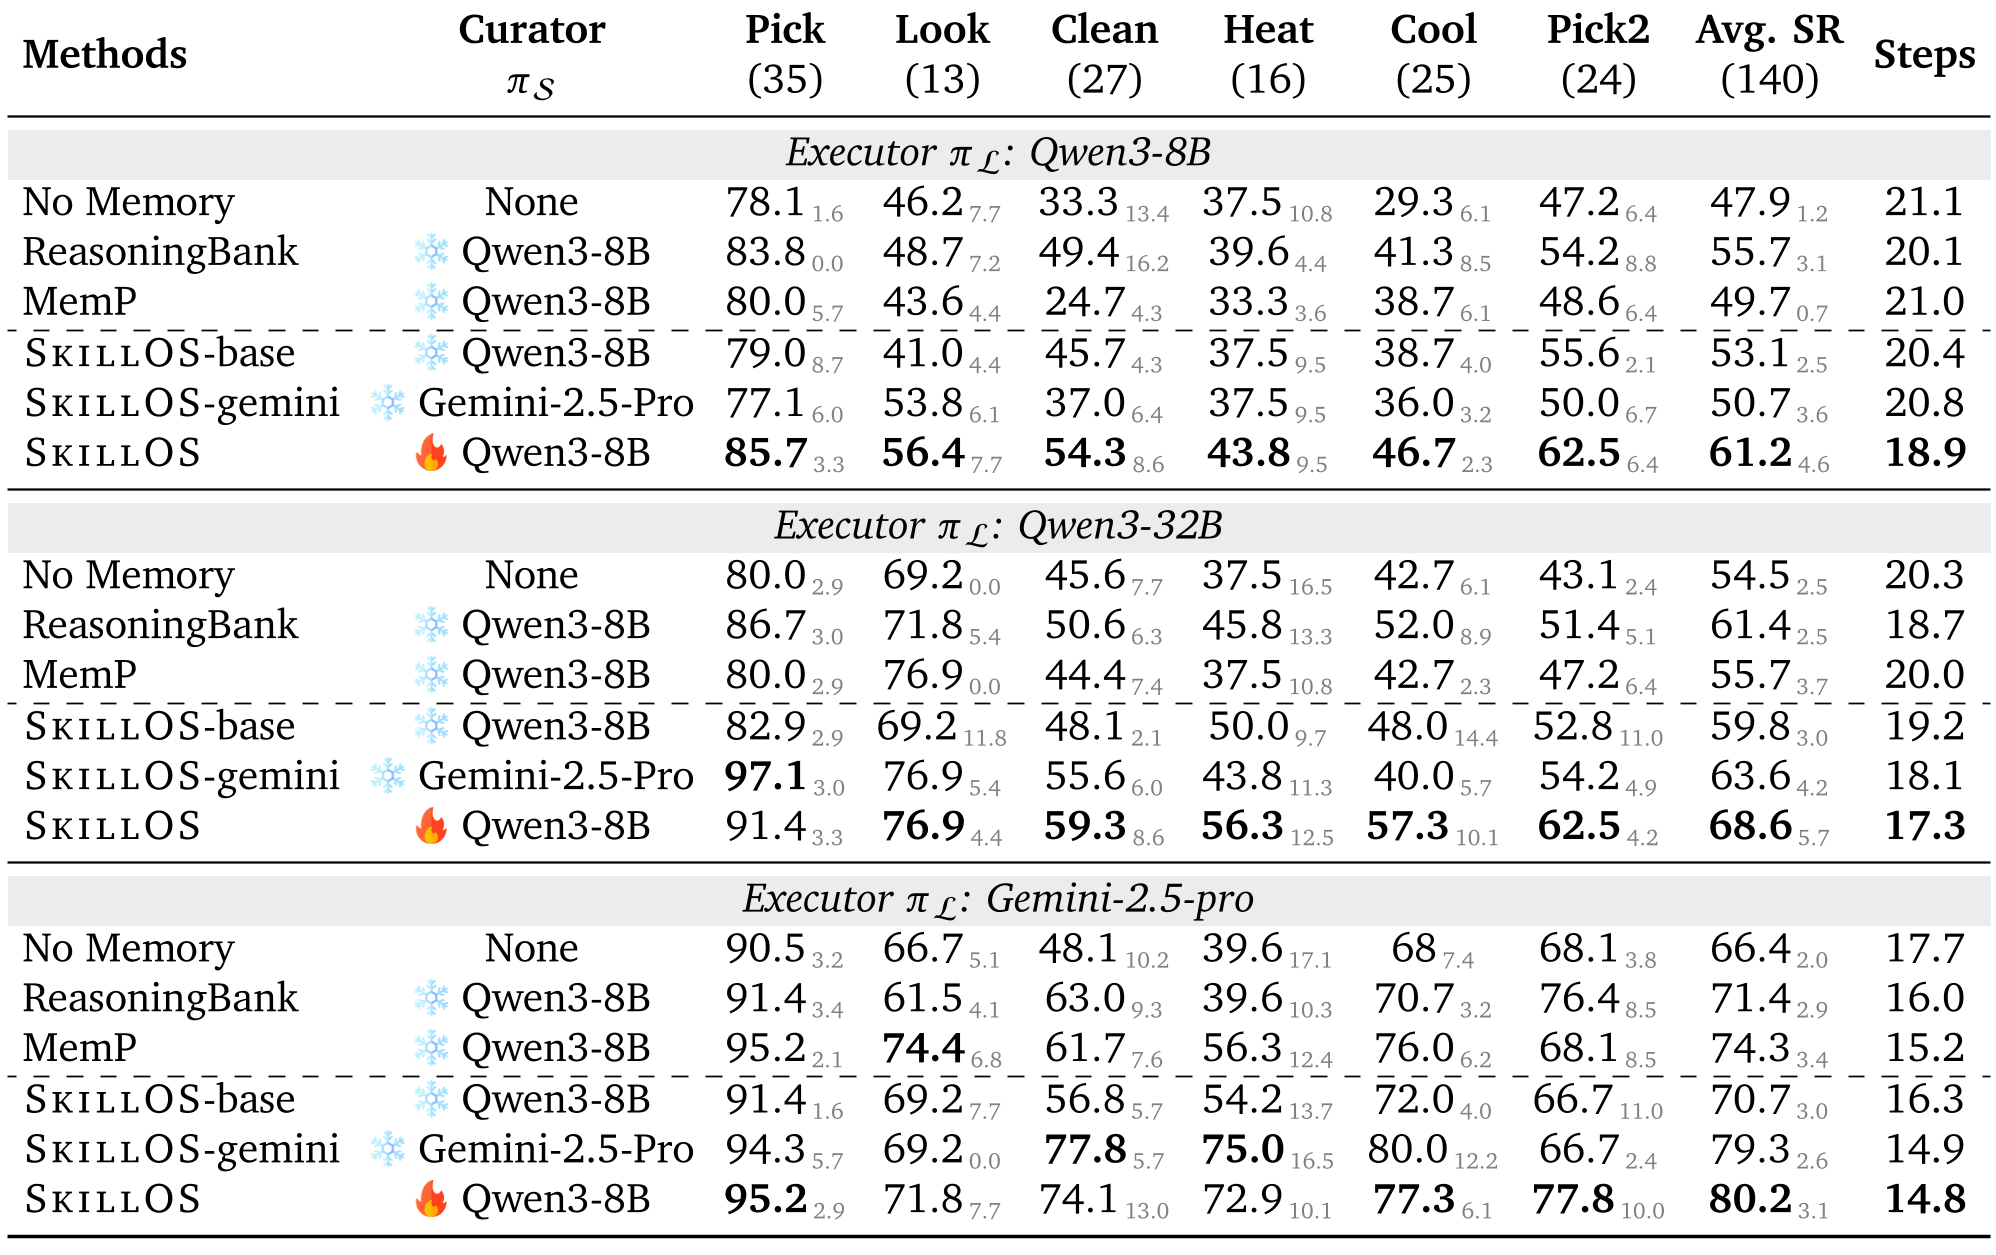 表 1:ALFWorld 实验结果。注意策展人为 8B 模型时,效果由于针对性 RL 训练,甚至超过了零样本的 Gemini-2.5-Pro 策展人。
关键发现:
- 进化动力学:随着训练进行,策展人的行为从“盲目新增”转向“精准更新”。技能库不再是杂物堆,而是日益精炼的专业字典。
- 泛化性:在一个模型(如 Qwen-8B)上训练出的策展人,竟然可以直接给另一个模型(如 Gemini)写技能指南,且依然有效。
深度洞察:策展人的本质是“元认知”
SkillOS 最深刻的贡献在于:它展示了技能策展不仅仅是内容总结,更是一种对“执行器局限性”的补补偿。训练后的策展人会刻意针对执行器容易犯错的地方写 Tips(例如:如果灯没开,先找开关再找 CD)。
局限性与展望
目前的技能库还是扁平的 Markdown 列表,未来若是能引入层级化技能(技能调用技能),并结合动态检索优化,Agent 的自进化天花板将进一步抬高。
总结
SkillOS 为我们展示了一个不再“原地踏步”的 Agent。它通过 RL 教会模型如何管理知识,让 Agent 在不断的任务洗礼中,最终成长为某个领域的“老师傅”。对于正在构建 Agent 系统的开发者来说,这种“管理思维”的引入至关重要。